

約13万件の文書で本番稼働。出典明示とハルシネーション制御に対応した、大規模文書向けRAGナレッジ基盤。適用診断から全社展開まで、段階的に導入できます。
サービス詳細
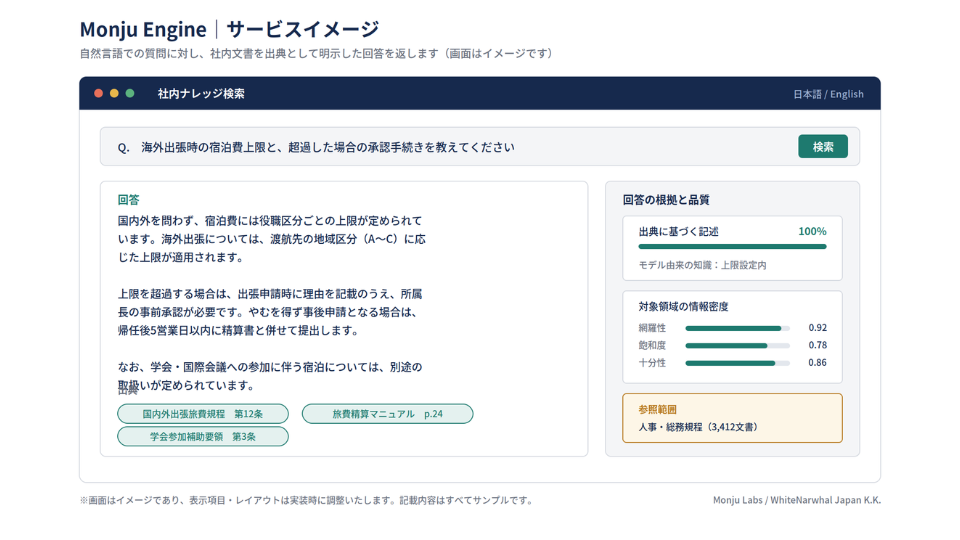
Monju Engineは、大量の社内文書を対象に、根拠(出典)を明示した回答を返す企業向けナレッジ検索基盤です。
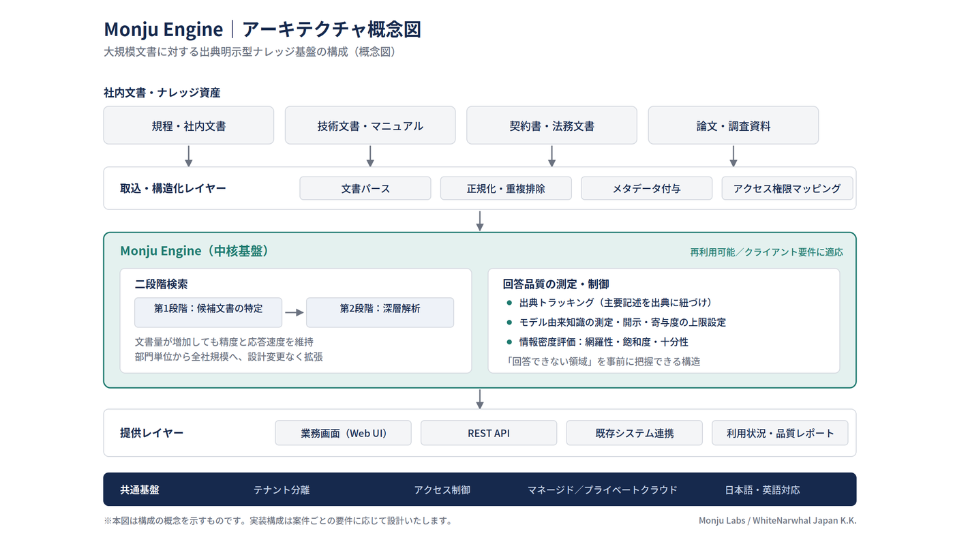
汎用の生成AIツールでは扱いが難しい、数万〜数十万件規模の規程、技術文書、契約書、保守マニュアル、学術文献などを対象とし、二段階検索アーキテクチャにより、文書量が増加しても検索精度と応答速度を維持します。
医療・科学領域では、約13万件の学術文書を対象とした本番環境で稼働しています。
加えて、コーパス内の12の主題領域それぞれについて情報密度の頑健性を動的に評価する独自の統計システムを開発し、カバレッジ(網羅性)、サチュレーション(飽和度)、アデカシー(十分性)を継続的に制御しています。
同一の基盤は、法務、コンサルティング、製造保守、建設、金融コンプライアンス、業界団体など、他の知識集約型業務へ展開可能です。
当社のアプローチは、すべてをゼロから構築するフルスクラッチ開発ではありません。実運用実績のある基盤を、貴社のデータ、専門用語、業務フロー、セキュリティ要件に合わせて適応させることで、開発期間とコストを抑えながら、専用設計に近い使用感を実現します。
東京・サンフランシスコ・ビルバオの3拠点体制により、日本語・英語のバイリンガル対応が標準です。海外拠点やグローバル本社を含む多言語展開にも対応いたします。
特長
1数万〜数十万件規模でも精度が落ちない二段階検索
一般的なRAGは、文書量が増えるほど関連文書の絞り込み精度が低下します。
Monju Engineは、まず「回答の根拠となりうる文書」を特定し、その限定された範囲で深い内容解析を行う二段階アーキテクチャを採用しています。
部門単位の導入から全社規模のリポジトリへ、設計を作り直すことなく拡張できます。2監査に耐える、出典付き・制御可能な回答
多くの企業向けAIは、出典を示しながらもモデル内部の知識を暗黙的に混在させています。
Monju Engineでは、主要な記述を特定可能な出典に紐づけ、モデル由来の知識を測定・開示し、その寄与度に上限を設定できます。
さらに、コーパスの情報密度を動的に評価する独自の統計システムにより、網羅性・飽和度・十分性を定量的に管理します。
「回答できない領域」を事前に把握できるため、法務、医療、金融、コンプライアンスなど、説明責任が求められる領域に適しています。3適用診断から始められる段階的導入
いきなり大規模投資を求めません。
適用可能性診断でデータ準備状況とRAG適用範囲を明確化し、プロトタイプで実クエリによる精度検証を行い、本格実装、その先に全社プラットフォーム化という4段階で、各フェーズごとに投資判断ができます。
解決する課題
数万件以上に及ぶ大規模な社内文書やデータから、必要な情報を効率的かつ正確に検索・活用できない課題を解決します。
PDFやWord、メール、データベースなどに分散した情報を横断的に検索できる環境を構築し、ナレッジ活用の効率化を支援します。
その他提供会社コメント
戦略提案にとどまらず、動作検証済みの検索パイプラインを構築し、ドキュメントとともに納品・引き渡しまで対応します。
既存システムとのAPI連携やセキュリティ要件に応じた環境構築、日本語・英語をはじめとする多言語展開にも対応可能です。
導入実績
■医療・科学分野|約13万件の学術文書を対象とした根拠付き回答基盤
【課題】研究者・専門家が膨大な学術文献から必要なエビデンスを特定できず、意思決定に時間を要していた。
【対応】大規模文書コーパスに対する二段階検索、出典明示型の回答生成、モデル生成知識の測定・制御、日本語ローカライゼーションを実装。
コーパスの情報密度を評価する独自の統計システムを開発し、網羅性・飽和度・十分性を継続的に管理。マネージドクラウドで提供。
【成果】約13万件規模の文書環境において、検索精度と応答速度を維持したまま本番運用を継続。
■医療機関(日本)|非構造の介護記録からの異常検知
【課題】病院が非構造の介護記録から、不規則な介護行動や患者満足度に影響するパターンを検知できなかった。
【対応】構造化・非構造データを組み合わせた機械学習による異常検知モデルを構築し、サービスの不整合を検出、優良事例を可視化。
【成果】患者ケア品質の安定化、転倒等の高リスク事象の早期検知、患者回復率の向上と侵襲的モニタリングの削減。
費用
| 初期費用 | お問い合わせください |
| 月額費用 | お問い合わせください |
| その他 | お問い合わせください |