

RAG(検索拡張生成)とは?仕組みやLLMとの違い、メリット・活用例を解説
最終更新日:2026年09月25日
記事監修者:森下 佳宏|BizTech株式会社 代表取締役
ChatGPTに搭載されているGPTシリーズをはじめとするLLM(大規模言語モデル)は、学習時点までの知識をもとに回答します。そのため、最新の情報や、学習データに含まれていない自社の製品情報・社内規程などを踏まえた回答は苦手です。
こうした課題への対策が「RAG(検索拡張生成:Retrieval-Augmented Generation)」です。
回答の前に社内データや最新情報を検索させ、その内容に基づいてLLMに回答を生成させる技術で、社内検索や問い合わせ対応などを中心に企業での導入が進んでいます。
本記事では、RAGの基本的な仕組み、LLM単体やファインチューニングとの違い、メリット・デメリット、主な活用例、導入・構築の流れを解説します。
導入を検討している経営層の方や、社内で技術的な説明を担うエンジニアの方は、ぜひ参考にしてください。
LLM・RAG開発が得意なAI開発会社について知りたい方はこちらで特集していますので、併せてご覧ください。
\今年度、AI導入相談増加中!/

目次
RAG(検索拡張生成)とは?
RAG(Retrieval-Augmented Generation:検索拡張生成)とは、LLMが回答を生成する前に外部の情報源を検索し、取得した情報を参照して回答を生成する技術です。
簡単に言えば、AIが「資料を調べてから答える」仕組みです。LLM本体には手を加えず、参照する資料を用意・更新することで、回答内容を自社の業務に合わせられる点が特徴です。
近年は、AIエージェントが検索の手順を判断するAgentic RAG(エージェント型RAG)や、CAD図面・回路図・フローチャートなどの画像も検索対象にするマルチモーダルRAGへと発展しています。
また、機密情報をクラウドへ送らず、社内サーバーやローカル環境のLLMで処理する構成での実装も広がっています。
関連記事:「Agentic RAGとは?RAGとの違い・特徴・注意点・活用方法を徹底解説!」
RAGとLLMの違い
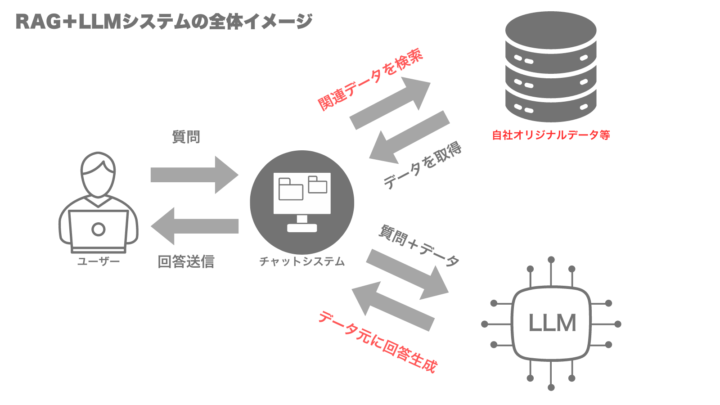
まず押さえておきたいのは、RAGはLLMと対立する技術ではなく、LLMに検索を組み合わせた構成である点です。
LLM単体は、事前に学習したデータの範囲でしか回答できません。
学習後に起きた出来事や、学習データに含まれない社内文書の内容は知らないため、質問されると推測で答えてしまい、事実と異なる内容(ハルシネーション)を出力する原因になります。
知識を更新するには、モデルの再学習や新しいモデルへの切り替えを待つ必要があります。
これに対してRAG構成では、質問のたびに社内データベースや外部の情報源を検索し、見つかった情報をLLMに渡してから回答させます。
LLMが知らないことを参照資料で補うため、社内情報や最新情報を踏まえた回答が可能になり、どの資料を根拠にしたかも示せます。
| 比較項目 | LLM単体 | (LLM+)RAG構成 |
|---|---|---|
| 参照する情報 | 事前学習データのみ | 事前学習データに加え、検索で取得した資料 |
| 最新情報 | 学習時点以降の情報は反映されない | 参照データを更新すれば反映できる |
| 社内情報 | 学習データに含まれないため回答できない | 社内文書を検索対象にすれば回答できる |
| 回答の根拠 | どの知識に基づく回答かを特定しにくい | 参照した文書名や該当箇所を提示できる |
| 更新方法 | モデルの再学習や新モデルへの切り替えが必要 | 文書の追加・差し替えと検索インデックスの更新で対応できる |
企業がLLMを業務で使おうとすると、「自社のことを知らない」「情報が古い」「根拠がわからない」という3つの壁に突き当たります。RAGは、モデル自体を作り変えずにこの壁を越えられる現実的な手段として、多くの企業で採用されています。
関連記事:「LLMとRAGで社内情報検索を効率化!検索・活用における役割やメリット、課題の解決方法」
ファインチューニングとの違い
ファインチューニングは、既存のLLMに特定領域のデータを追加で学習させ、モデル自体の振る舞いを調整する手法です。社内特有の言い回しや回答のフォーマット、専門分野の判断傾向などをモデルに身に付けさせたい場合に向いています。
ただし、学習データの準備と品質管理が必要なうえ、情報が変わるたびに再学習しなければ内容を更新できません。また、学習させた知識のうちどれを根拠に回答したのかを示すことも困難です。
事実に関する知識を正確に覚えさせる用途には不向きとされています。
一方、RAGはモデルには手を加えず、質問に関連する情報を検索してLLMに渡す仕組みです。知識の追加や更新は参照データの差し替えで済むため、情報の鮮度が求められる用途や根拠の提示が必要な業務に適しています。
両者は二者択一ではありません。「知識はRAGで補い、口調や出力形式はファインチューニングで整える」というように、目的に応じて組み合わせる設計も一般的です。
RAG研究の全体像を把握するには、手法を体系的に整理した以下のサーベイ論文が参考になります。
参照:「arXiv|Retrieval-Augmented Generation for Large Language Models: A Survey」
関連記事:「ファインチューニングとRAGの違い、使い分け方を徹底解説!」
プロンプトエンジニアリングとの違い
プロンプトエンジニアリングは、指示文の書き方や例示の与え方を工夫して、LLMが持つ能力を引き出す入力方法の工夫です。追加の開発をほとんど必要とせず、すぐに試せる手軽さがありますが、モデルが知らない情報を補うことはできません。
一方、RAGは検索によってLLMの外部から知識を追加する仕組みです。と言っても、検索結果の渡し方や回答ルールの指示にはプロンプト設計を用いるため、両者は組み合わせて使うことが前提になります。
3つの手法の違いを整理すると、以下の通りです。
| 比較項目 | プロンプトエンジニアリング | RAG | ファインチューニング |
|---|---|---|---|
| 変えるもの | LLMへの指示文 | LLMに渡す参照情報 | モデルのパラメータ |
| 主な効果 | 出力の形式や品質の改善 | 社内情報・最新情報に基づく回答 | 専門的な言い回しや振る舞いの定着 |
| 知識の追加 | できない | 検索対象に文書を加えれば可能 | 限定的(事実知識の追加には不向き) |
| 情報の更新 | 不要 | 参照データの更新で対応 | 再学習が必要 |
| 回答根拠の提示 | 難しい | しやすい | 難しい |
| 導入コスト・期間 | 小さい・短い | 中程度(検索基盤とデータ整備が必要) | 大きい・長い(学習データの準備と学習環境が必要) |
| 向いている用途 | 要約や文章作成など汎用タスクの品質向上 | 社内FAQ、問い合わせ対応、規程・マニュアル検索 | 専門分野特有の文体や判断傾向の再現 |
関連記事:「プロンプトとは?生成AIにおける役割から最適化する効果・プロンプトエンジニアリング・今後の動向まで徹底解説!」
LLM×RAGに強い会社の選定・紹介を行います
今年度RAG相談急増中!紹介実績1,000件超え!
・ご相談からご紹介まで完全無料
・貴社に最適な会社に手間なく出会える
・AIのプロが貴社の代わりに数社選定
・お客様満足度96.8%超
完全無料・最短1日でご紹介 LLM×RAGに強い会社選定を依頼する
RAGの仕組み(検索・拡張・生成の流れ)
外部情報の検索とLLMによる文章生成を組み合わせる処理は、主に以下3つのステップで進みます。
- 検索(Retrieval)
- 拡張(Augmentation)
- 生成(Generation)
なお、構成はシステムによって異なり、ベクトル検索を使わずキーワード検索だけで構築するケースや、AIエージェントが検索を繰り返すケースもあります。
①関連情報を検索する
最初のステップでは、ユーザーの質問(クエリ)に関連する情報を、あらかじめ用意した検索インデックスから探し出します。
前提として、社内文書などの参照データは事前に適切な長さに分割(チャンキング)され、検索できる状態で格納されている必要があります。
ベクトル検索を使う場合は、各チャンクをEmbeddingモデルで数値の並び(ベクトル)に変換し、ベクトルデータベースに登録しておきます。ベクトルは文章の意味を数値で表したもので、意味の近い文章ほどベクトル同士も近くなります。
質問が入力されると、同じEmbeddingモデルで質問文もベクトルに変換し、データベース内のベクトルとの類似度を計算します。これにより、表現が違っても意味の近い文書を見つけられます。
検索で集めた候補は、さらにリランキング(Rerank)で並べ替えます。リランキングでは、質問と各候補文書の内容を専用のモデルで照合し、回答に役立つ順に順位を付け直します。
検索方式には主に以下の3種類があります。
| 検索方式 | 仕組み | 得意なこと | 苦手なこと |
|---|---|---|---|
| キーワード検索(全文検索) | 質問に含まれる単語と一致する文書を探す | 型番・製品名・専門用語など、表記が決まっている語の検索 | 言い換えや表現の揺れへの対応 |
| ベクトル検索 | 文章の意味をベクトル化し、意味の近さで探す | 言い換えや曖昧な質問から、意図に合う文書を探すこと | 型番や固有名詞の厳密な一致 |
| ハイブリッド検索 | キーワード検索とベクトル検索を並行して実行し、両者のスコアを統合する | 互いの弱点を補い、検索の取りこぼしを減らせる | 設定・調整の項目が増える |
現在の企業向けRAGでは、ハイブリッド検索とリランキングを組み合わせる構成が標準的になりつつあります。
また、基本の仕組みを発展させた手法として、以下のようなものがあります。
| 手法 | 概要 | 向いている場面 | 注意点 |
|---|---|---|---|
| Agentic RAG(エージェント型RAG) | AIエージェントが検索の要否や検索先を判断し、質問の分割や検索語を変えた再検索を行いながら、回答に必要な情報がそろうまで検索を進める | 複数の資料をまたいで調べる必要がある複雑な質問 | 検索と生成の反復で処理時間・コストが増えるため、実行回数の上限や終了条件の設計が必要 |
| マルチモーダルRAG | 文章に加え、画像・図表・レイアウトも検索・参照する | 図解入りの製品マニュアル、グラフを含む報告書、図面や回路図 | 画像の解析やベクトル化の分だけ、インデックス作成のコストが増える |
| GraphRAG | 文書から人物・製品・組織などの関係を抽出してナレッジグラフを構築し、その関係性をたどって情報を検索する | 「AとBの関係」や「全体の傾向」など、複数の文書にまたがる関係性を問う質問 | グラフの構築に手間と費用がかかり、データ更新時には再構築も必要 |
参照:Microsoft|マルチモーダルコンテンツの抽出・分割・検索
関連記事:「ベクトルデータベースとは?仕組みやメリット、活用事例を解説」
関連記事:「Rerankとは?RAGの検索精度を向上する仕組み・代表モデル・使い方を徹底解説」
②検索した情報をプロンプトに追加する
検索で取得した情報は、ユーザーの質問や指示とともにLLMへ入力されます。これが拡張(Augmentation)にあたる工程です。
実際には、「以下の参照資料だけを根拠に回答すること」「資料に記載がない場合はわからないと答えること」といった回答のルールもあわせて指示します。
複数の文書を参照する場合は、文書名や更新日、出典なども渡すことで、情報の背景や適用条件を踏まえた回答につなげられます。
③LLMが回答を生成する
LLMは、質問と参照資料の内容を踏まえて、自然な文章で回答を生成します。参照資料の該当箇所を要約・統合し、質問の意図に沿った形に整えて出力する工程です。
生成された回答は、ユーザーに提示される前に後処理が行われる場合があります。例えば、参照した文書へのリンク(出典)の付与、不適切な表現のフィルタリング、個人情報のマスキングなどです。
RAGを活用するメリット
RAGを導入すると、LLMの弱点である知識の鮮度と社内情報の不足を補えるだけでなく、回答の信頼性や運用のしやすさの面でもメリットが得られます。いずれも、「モデルを作り変えるのではなく、参照するデータを管理する」という設計から生まれるものです。
ここでは、企業が導入を検討する際に押さえておきたい4つのメリットを解説します。
最新情報や自社独自の情報を回答に反映しやすい
RAGは質問のたびに参照データを検索するため、データソースや検索インデックスを更新することで最新の情報を回答に反映しやすくなります。製品仕様の変更や社内規程の改定があった場合も、該当する文書を差し替えればAIの回答に反映できます。
ただし、反映されるのはインデックスを更新した時点までの情報であるため、更新の頻度や仕組みをあらかじめ設計しておくことが重要です。
また、製品に関する問い合わせへの回答や操作サポートなど、一般には公開されていない自社独自の情報に基づく回答も生成できます。社内ヘルプデスク業務の効率化や自動化にもつながります。
特に効果が大きいのが、社内に眠るナレッジの活用です。企業内には日々、以下のような情報が蓄積されています。
- 議事録
- 報告書
- 製品マニュアル
- FAQ
- トラブル対応履歴
- ベテラン社員の経験に基づくノウハウや業務のコツ(暗黙知)
とりわけ製造業や建設業などでは、熟練工による技術伝承が課題となることも少なくありません。
しかし、こうした情報の多くは検索しづらい形式(非構造化データ)で保管されており、必要なときに必要な情報を活用できない死蔵データとなっているのが実態です。
自然言語による柔軟な検索と生成を組み合わせることで、こうした埋もれた情報やノウハウを引き出し、再活用できるようにします。
関連記事:「RAGでヘルプデスクを効率化?対話型AIでは不十分な理由・導入メリット・活用事例を徹底解説!」
関連記事:「ナレッジマネジメントとは?概要・手法・メリット・生成AI(RAG)導入方法を徹底解説!」
回答精度を高め、ハルシネーションを抑制できる
LLMの業務活用では、事実と異なる内容をもっともらしく出力するハルシネーションが大きな課題です。特に、法務・医療・製造など正確性が求められる領域では、誤った自動回答が重大なリスクにつながりかねません。
RAGでは、LLMの回答を社内データや信頼できる情報源の記載内容に基づかせるため、LLMが知識の不足を推測で補う場面を減らせます。
「資料に記載がない場合は回答しない」というルールと組み合わせれば、根拠のない回答をさらに抑えられ、より安全な形での業務活用が可能になります。
関連記事:「ChatGPTの回答精度を上げる方法は?RAGの活用方法・プロンプト設計のコツも徹底解説!」
回答の根拠・参照元を示しやすい
RAGでは、回答の生成に使った文書が検索の段階で特定されているため、回答とあわせて参照元の文書名やページ、該当箇所を提示しやすいという特徴があります。
利用者は、AIの回答をそのまま信じるのではなく、示された参照元を開いて内容を確かめられます。規程やマニュアルに基づく回答であれば、原文の条件や例外規定まで自分の目で確認できます。
こうした検証のしやすさは、AIへの信頼につながります。
「AIがそう言っている」ではなく「この規程の第○条に基づく回答」と説明できれば、顧客対応や社内の意思決定にも回答を活用しやすくなります。また、誤回答が起きた際に、原因が参照データの誤りなのか検索の失敗なのかを切り分ける手がかりにもなります。
モデルを再学習せず情報を更新できる
LLMに新しい知識を覚えさせるには、本来、追加学習(ファインチューニング)やモデルの切り替えが必要です。学習データの準備や学習後の品質確認には時間と費用がかかり、情報が変わるたびに繰り返すことは現実的ではありません。
RAGでは、知識はモデルの外にある参照データとして管理されます。そのため、文書の追加・修正・削除と検索インデックスの更新だけで、回答に使われる情報を入れ替えられます。
古くなった規程を削除すれば、その内容が回答に使われることもなくなります。LLMを新しいモデルに切り替える場合も、参照データはそのまま引き継げる点が運用上の利点です。
RAGのデメリット・導入時の注意点

RAGはLLMの弱点を補う有効な手段ですが、導入すれば自動的に精度の高い回答が得られるわけではありません。回答の質は参照データと検索の設計に大きく左右され、構築後も継続的な改善が必要です。
ここでは、導入前に理解しておきたい4つの注意点を解説します。
参照データの品質によって回答精度が左右される
RAGの回答は参照データの内容に基づくため、元のデータが古い・誤っている・重複している場合、その問題がそのまま回答に表れます。どれほど高性能なLLMを使っても、参照データの質以上の回答は得られません。
代表的な落とし穴がデータの陳腐化です。製品仕様の変更や規程の改定があっても参照データが更新されなければ、AIは古い内容を正しい情報として回答します。
また、部門ごとに資料を管理している企業では情報がサイロ化しやすく、同じテーマで内容の異なる文書が複数存在すると、どちらが検索されるかによって回答が変わってしまいます。
対策としては、導入前に検索対象の文書を棚卸しし、古い版や重複を整理することが基本です。
ハルシネーションは完全にはなくならない
RAGはハルシネーションを抑制できますが、完全になくせるわけではありません。主な原因は3つあります。
| 原因 | 発生する状況 | 主な対策 |
|---|---|---|
| 検索の失敗 | 質問と無関係な文書が取得される 必要な文書が見つからず、不十分な情報をもとに回答してしまう。 | ハイブリッド検索やリランキングの導入による検索精度の向上 |
| 参照資料の誤読 | 正しく資料が取得されていても、LLMが条件や例外を読み落としたり、複数の資料を誤って組み合わせたりする。 | 参照元を提示し、利用者自身に内容を確認させる |
| 資料に答えがない | 資料に該当する情報がない場合、LLMが一般的な知識で補填し、もっともらしい架空の回答を作成してしまう。 | 「資料にない場合は回答しない」というプロンプト上のルール設定 |
重要度の高い業務では、最終的な判断を人が行う運用を前提にすることが現実的です。
構築・運用にコストや専門知識が必要
RAGは、LLMを独自に開発する場合やファインチューニングと比べれば、低コストで始められます。しかし、本番運用に耐える品質を出すには、多くの設計と調整が必要です。
構築段階では、以下のように検討項目が多岐にわたります。
- 文書の前処理
- チャンキング
- Embeddingモデルと検索方式の選定
- リランキング
- プロンプト設計
PDFの表や図面などを正しく読み取るには、文書解析の工夫も欠かせません。費用面では、検索基盤の利用料に加え、質問のたびに発生するLLMのAPI利用料も考慮する必要があります。
さらに、運用開始後も精度の評価、参照データの更新、質問傾向に合わせた調整が続きます。
近年は主要なクラウド各社がRAG向けのマネージドサービスを提供しており、検索基盤の構築・運用の負担は軽くなっています。
情報セキュリティ・アクセス権限への対策が必要
RAGは、社内データをLLMの学習に使わずに活用できる点で情報管理上の利点があります。一方で、社内の文書をAIが横断的に検索できるようになることで新たなリスクも生まれます。
最も注意すべきなのが、アクセス権限の問題です。
検索対象に人事評価や役員会資料などが含まれている場合、権限設計が不十分だと、本来は閲覧できない社員の質問に対してその内容が回答に使われてしまいます。
また、クラウドのLLMを利用する場合、検索で取得した文書の一部は回答生成のために外部へ送信されます。
機密性の高い情報はローカル環境のLLMで処理する構成も検討します。さらに、参照文書に悪意のある指示を埋め込んでAIの動作を操作するプロンプトインジェクションへの対策も必要です。
関連記事:「生成AIの機密情報漏洩リスクはRAGで解決できる?メリットや強化策を徹底紹介!」
LLM×RAGに強い会社の選定・紹介を行います
今年度RAG相談急増中!紹介実績1,000件超え!
・ご相談からご紹介まで完全無料
・貴社に最適な会社に手間なく出会える
・AIのプロが貴社の代わりに数社選定
・お客様満足度96.8%超
完全無料・最短1日でご紹介 LLM×RAGに強い会社選定を依頼する
RAGの主な活用例
RAGは、「社内外の資料を調べて答える」業務であれば幅広く活用できます。特に効果が出やすいのは、参照すべき資料が多く、同じような質問が繰り返し発生し、回答に正確さと根拠が求められる業務です。ここでは代表的な3つの活用領域を紹介します。
社内ナレッジ検索・社内FAQ
社内規程、業務マニュアル、過去のプロジェクト資料、議事録などを検索対象にすると、社員が自然な言葉で質問するだけで、必要な情報を参照元付きで引き出せる社内アシスタントを構築できます。
例えば、「出張の日当はいくらか」「この金額の稟議の承認者は誰か」「過去に同じ不具合が起きた案件はあるか」といった質問に、該当する規程や資料を示しながら回答できます。
総務・人事・情報システム部門への定型的な問い合わせを減らせるほか、新入社員や異動者が自分で調べられるようになるため、オンボーディングの負担も軽くなります。
また、日報やチャットのやり取り、トラブル対応の記録を検索対象に加えれば、ベテラン社員の経験に基づくノウハウを他の社員が参照できるようになります。
部署をまたいで資料を横断検索できるため、属人化の解消や、離職による知見の流出を防ぐ手段としても有効です。
カスタマーサポート・問い合わせ対応
製品マニュアル、FAQ、過去の問い合わせ対応履歴を検索対象にすると、顧客からの問い合わせに対する回答案の作成や、チャットボットによる一次対応に活用できます。
オペレーター向けの支援として使う場合は、問い合わせ内容に応じて関連するマニュアルの記載や類似事例を提示し、回答案を自動で作成します。
オペレーターは内容を確認・修正して送信するだけで済むため、対応時間の短縮と回答品質の均一化につながります。
顧客向けのチャットボットとして使う場合は、24時間365日の一次対応が可能になります。ただし、誤回答が顧客に直接届くため、回答できる範囲を限定し、判断が難しい問い合わせは有人対応へ引き継ぐ設計が重要です。
専門文書の検索・チェック
契約書、社内規程、法令、技術基準、設計書など、専門知識がなければ読み解きにくい大量の文書から、必要な条項や記載を探し出して照合する作業にもRAGは効果を発揮します。
法務部門では、契約書のレビュー時に自社の契約基準や過去の契約事例を参照し、不利な条項や基準から外れている箇所を洗い出す用途があります。
製造業や建設業では、設計書や仕様書を社内の技術基準や関連法規と照らし合わせ、記載漏れや基準違反の候補を抽出する使い方が考えられます。
いずれも、担当者が膨大な文書を読み比べる時間を大幅に削減できます。
ただし、RAGの役割はあくまで確認すべき箇所の候補を示すことです。参照元の条項を提示できる特性は、こうした確認作業と相性の良い点です。
関連記事:「RAG(検索拡張生成)の活用事例は?企業の事例を徹底解説!」
RAGを導入・構築する流れ
RAGの構築方法は、大きく2通りあります。
- 自社開発:LangChainやLlamaIndexなどのオープンソースのフレームワークを使い、検索基盤からLLMとの連携までを自社の要件に合わせて開発
- クラウドサービスを利用:Amazon BedrockのKnowledge BasesやAzure AI Searchなど、主要なクラウドが提供するマネージドサービスを活用
どちらの方法でも、目的の設定からデータ整備、評価、運用改善までの基本的な流れは共通です。ここでは、その6つのステップを解説します。
関連記事:「RAGを導入するまでのステップ!プロジェクトの進め方や技術選定のポイントも徹底解説!」
①目的・ユースケースを決める
最初に決めるべきなのは、技術ではなく「誰の、どの業務の、何を改善するのか」です。
「社内の情報をAIで活用したい」という漠然とした目的のままでは、検索対象のデータも評価の基準も定まらず、PoCが成果を判断できないまま終わりがちです。
ユースケースを選ぶ際は、問い合わせの件数や資料探しにかかる時間など、現状の負担を数値で把握できる業務から始めるのが効果的です。そのうえで以下を整理します。
- 利用者(社員か顧客か)
- 参照するデータの範囲
- 求められる回答の正確さ
- 誤回答が起きた場合の影響
- 導入の効果を何で測るのか
経営層と開発チームがこの目標を最初に合意しておくことで、技術選定や予算判断の軸がぶれにくくなります。
②参照するデータを収集・整備する
参照データの準備は、RAGの回答精度を左右する最も重要な工程です。どれほど高性能なLLMを使っても、参照データの質が低ければ正確な回答は得られません。
まず、社内文書やWebページを収集し、内容を整理します。古い版や重複した文書、現在は適用されない規程などを除外し、各文書の最新版と更新日、管理部門を確認します。
あわせて、不要なHTMLタグや定型文の除去、ファイル形式の統一などのデータクリーニングを行います。
続いて、長い文書をAIが扱いやすいサイズに分割するチャンキングを行います。
操作手順の途中や、表の項目名と数値の間で分割すると、検索された部分だけでは内容を正しく理解できません。見出しを各チャンクに付与したり、表とその説明を関連付けたりすることで回答に必要な背景情報を保持しやすくなります。
ベクトル検索を利用する場合は、分割した文書をEmbeddingモデルでベクトル化し、文書名・更新日・閲覧権限などのメタデータとともに検索インデックスへ登録します。
関連記事:「チャンキングとは?RAGにおける分割手法と精度への影響を解説」
③LLMを選定する
回答を生成するLLMを選定します。主な選択肢は以下です。
- OpenAIのGPTシリーズ
- AnthropicのClaudeシリーズ
- GoogleのGeminiシリーズ
- 自社環境で動かせるオープンウェイトのモデル
各社とも短い周期で新しいモデルを投入しているため、特定のバージョンを前提にするのではなく、後からモデルを切り替えられる設計にしておくことが重要です。
選定時に確認したい主な観点は以下の通りです。
| 観点 | 確認するポイント |
|---|---|
| 日本語性能 | 社内文書の日本語や専門用語を正確に読み取り、自然な文章で回答できるか |
| 参照資料への忠実さ | 資料に書かれた内容に沿って回答し、記載がない場合に推測で補わないか |
| コンテキスト長 | 一度に渡せる参照資料の量が、想定する質問に対して十分か |
| データの取り扱い | 入力データを学習に利用しないか、保存期間や処理されるリージョンが自社の要件を満たすか |
| 提供形態 | クラウドのAPIで利用するか、機密性の高いデータのためにローカル環境で動かすか |
| コスト・応答速度 | 想定する利用量でのAPI利用料と、業務に必要な応答速度を満たせるか |
ユースケースごとにモデルを使い分ける構成も一般的です。例えば、社員からの大量の定型的な質問には高速で安価なモデルを、複雑な文書の照合には高性能なモデルを割り当てることでコストと品質のバランスを取れます。
④検索エンジンの開発とLLMとの連携
検索方式を、自社のデータと質問の傾向に合わせて設計し、LLMと連携させます。
型番や専門用語での検索が多ければキーワード検索、言い換えの多い質問が多ければベクトル検索が有効です。企業向けでは、両者を組み合わせたハイブリッド検索にリランキングを加える構成が主流です。
あわせて、部署・文書の種類・更新日などのメタデータを使った絞り込みや、利用者の閲覧権限に応じた検索結果の制御もこの段階で実装します。
LLMとの連携では、検索結果をどの順番で何件渡すか、出典情報をどう付けるか、回答のルールをどう指示するかを設計します。
最後に、利用者が質問を入力し、回答と参照元を確認できるインターフェース(社内チャット、Web画面、業務システムへの組み込みなど)を用意します。
⑤PoCで回答精度を評価する
本格導入の前に、限られた範囲でPoC(概念実証)を行い、回答精度を評価します。
まず、実際の業務で想定される質問と、その正解・根拠となる文書をセットにした評価用データを用意します。業務担当者に協力してもらい、よくある質問だけでなく、判断が難しい質問や資料に答えがない質問も含めることが重要です。
評価では、回答の正しさだけでなく、「必要な文書を検索できているか(検索精度)」と「参照資料に忠実に回答しているか(忠実性)」を分けて確認します。
誤回答の原因が検索と生成のどちらにあるかを切り分けることで、改善すべき箇所が明確になります。応答時間や利用コストもあわせて確認し、目標を満たせるかを判断します。
関連記事:「RAGの精度評価方法とは?指標や改善のポイントを解説」
⑥運用しながら継続的に改善する
RAGの品質は、本番運用を始めてからの改善で大きく変わります。参照データの変化や、専門用語・略語など利用者の質問傾向の変化によって、検索精度は時間とともに低下しやすくなります。
特に注意したいのは、評価の仕組みがないために、精度の劣化に気づかないまま運用を続けてしまうケースです。
そのため、「回答の正答率」「利用者が質問し直す割合」「回答への低評価の割合」など、事業部門と開発チームが合意できるKPIを設定し、定期的にモニタリングします。
あわせて、誤回答の報告が誰に通知され、何営業日以内に原因を分析し、誰が改善策(参照データの修正、検索設定やプロンプトの調整)を決めるのかを運用ルールとして定めておきます。
RAGの構築と運用には、検索技術やLLMの知見を持つエンジニアの関与が欠かせません。自社の技術力や体制を見極め、必要に応じて外部の専門家や開発会社との連携を検討することが重要です。
関連記事:「LLMOpsとは?導入メリット・最適ツール、活用のコツを徹底解説」
RAGの活用は個別の質問応答からAIエージェントへ
RAGは、社内文書の検索や問い合わせへの回答など、個別の作業を支援する用途で活用されてきました。
近年は、こうした「必要な情報を調べて答える」という点での利用に加え、AIエージェントが進める業務フローの中で、各工程に必要な情報を提供する使い方へと活用が進んでいます。
例えば、問い合わせに回答するだけでなく、内容の確認、対応方針の検討、回答案の作成、対応記録の登録までをつなぐような構成です。
その中でRAGは、製品仕様や社内ルール、過去の対応履歴を参照し、各工程の判断や生成を支える技術として利用されます。
個別の質問応答と業務フロー内での活用の違い
RAGの基本的な役割は、検索した情報を生成AIの出力に反映することです。AIエージェントと組み合わせると、その情報を一つの回答にまとめるだけでなく、後続の作業にも引き継げます。
| 比較項目 | 個別の質問応答でのRAG活用 | AIエージェントの業務フロー内でのRAG活用 |
|---|---|---|
| 利用する場面 | 利用者が質問し、必要な情報を確認するとき | 一連の作業の途中で、判断や処理に必要な情報を参照するとき |
| 検索した情報の使い道 | 質問に対する回答や要約を生成する | 対応方針の検討、文書作成、入力内容の確認などに利用する |
| 後続の作業 | 利用者が回答を確認し、次の作業を進める | AIエージェントが取得した情報を引き継ぎ、設定された権限や承認手順に沿って作業を進める |
業務の各工程に必要な知識を提供する
例えば、顧客から製品の不具合について問い合わせがあった場合、RAGを以下のように利用できます。
- AIエージェントが問い合わせ内容を整理し、対象製品や症状を確認する
- RAGで製品マニュアルや過去の類似事例を参照し、原因の候補や確認事項を整理する
- 必要に応じて保証規定や対応手順を参照し、回答案と対応方針を作成する
- 担当者の承認後、連携先のシステムで回答の送信や対応記録の登録を行う
このように、RAGは業務の途中で必要になる知識を補い、情報の確認から実際の対応までをつなぐ役割を担います。送信や登録などの操作は、AIエージェントと外部API・業務システムとの連携によって実行します。
関連記事:「AIエージェントとは?生成AIとの違い・自律的に動く仕組み・種類・導入リスクを徹底解説!」
まとめ
RAGの成果を左右するのは、LLMの性能よりも、どの業務に使うか、どのデータを参照させるか、どう評価して改善し続けるかという設計と運用です。
技術そのものは成熟しつつあり、マネージドサービスの充実によって構築のハードルも下がっています。
差がつくのは、自社の業務とデータにどれだけ深く向き合えるかという点です。
まずは、問い合わせの多い業務や資料探しに時間がかかっている業務を一つ選び、参照すべき文書を棚卸しするところから始めてみてください。
対象業務と評価基準が明確になれば、PoCの成否を判断できるようになり、経営層と開発チームが同じ目標のもとで議論を進められます。
自社開発かマネージドサービスか、クラウドかローカルかといった構成の判断や、開発パートナーの選定に迷う場合は、RAG開発の実績を持つ専門会社に相談することも有効な選択肢です。
AI Market 運営、BizTech株式会社 代表取締役|2021年にサービス提供を開始したAI Marketのコンサルタントとしても、お客様に寄り添いながら、現場のお客様の課題ヒアリングや企業のご紹介を5年以上実施しています。これまでにLLM・RAGを始め、画像認識、データ分析等、1,000件を超える様々なAI導入相談に対応し、参加累計8,000人を超えるAIイベントを主催。AIシステム開発PM歴8年以上。AI Marketの記事では、AIに関する情報をわかりやすくお伝えしています。(JDLA GENERAL 資格保有)
▶ 監修者の実績・経歴を詳しく見る
AI Market 公式𝕏:@AIMarket_jp
Youtubeチャンネル:@aimarket_channel
TikTok:@aimarket_jp
運営会社:BizTech株式会社
掲載記事に関するご意見・ご相談はこちら:ai-market-contents@biz-t.jp
お電話で無料相談

