

AI画像認識とは?VLM・最新モデルから仕組み・活用方法まで徹底解説!導入相談事例も紹介
最終更新日:2026年09月10日
記事監修者:森下 佳宏|BizTech株式会社 代表取締役
AIを活用した画像認識は、製造業における品質管理の自動化、小売業の在庫最適化、セキュリティ強化など、幅広いビジネス領域で導入が進んでいます。
しかし、「導入コストが高そう」「自社に本当に必要なのか」「どれくらいの精度が出るの?」といった懸念をお持ちの経営者も多いのではないでしょうか。実は、AI画像認識の導入は想像以上に身近なものになっています。
さらに近年は、Vision Foundation ModelやVLM、GPT・Geminiなどのマルチモーダル基盤モデルの発展により、画像認識は「何が写っているか」を判定するだけでなく、画像の意味や状況を理解し、自然言語で説明・検索・推論する技術へと広がっています。
この記事では、AIで画像認識を行う方法、AIモデルの種類、活用されている分野、注意点、導入方法をわかりやすく解説します。
精度に関するよくある誤解や最新技術動向、AI Marketが開発企業を紹介した事例も取り上げます。導入を検討している方や、精度向上に課題を抱えている方は、ぜひ参考にしてください。
画像認識・画像解析に強いAI開発会社をご自分で選びたい場合はこちらで特集していますので併せてご覧ください。
目次
AIによる画像認識とは?
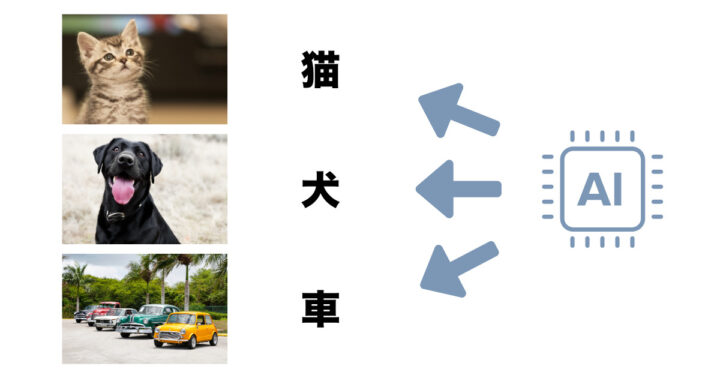
「画像認識」とは、形や色などの特徴を用いて、コンピュータが2次元(2D)または3次元(3D)画像に写るものが何であるかを認識する技術です。人間が「犬」「猫」「車」などの物体を識別する際に、特徴を学習し判断するプロセスを参考に、コンピュータが同様の認識能力を獲得することを目指しています。
AI、特に機械学習やディープラーニングを利用すると、手作業で判定ルールを設定する従来手法に比べて、複雑な特徴を学習できるようになります。こうした技術は、広義にはコンピュータビジョンの一分野です。
尚、動画解析においても、基本的には画像認識の技術がベースとなっています。
AIが画像を認識する仕組み
AIによる画像認識は、画像から「特徴量(見た目の手がかり)」を抽出し、その特徴をもとに対象の種類や位置などを判定する仕組みです。教師あり学習では、画像と正解ラベルの組み合わせから、判定に必要な特徴や規則を学習します。
例えば、犬や猫の画像を学習することで、形や模様などの特徴を捉え、新しい画像に何が写っているかを判定します。ただし、光・角度・背景・個体差によって見え方が変わるため、実際の利用環境を反映したデータで学習・評価することが重要です。
また、大規模な事前学習済みモデルを活用し、用途ごとにゼロから大量の教師データを用意せずに画像認識モデルを構築する方法もあります。なお、必要なデータ量や追加学習の有無は、対象や求める精度によって異なります。
画像認識の歴史:パターン照合から基盤モデルへ
初期の画像認識では、テンプレートマッチングや、人が色・形などの特徴に基づいて判定ルールを設定する手法が用いられていました。しかし、固定されたルールだけで複雑なシーンや多様な対象に対応することには限界がありました。
その後、機械学習や統計的手法が取り入れられ、さらにディープラーニングによって、画像から判定に必要な特徴を自動的に学習できるようになりました。特に、畳み込みニューラルネットワーク(CNN)を活用した手法は、2012年頃からImageNetなどのコンテストで高い性能を示し、画像分類や物体検出などの実用化を後押ししました。
近年は、自己教師あり学習などを用いて大量の画像から汎用的な特徴を獲得するVision Foundation Model(視覚基盤モデル)の活用が進んでいます。事前学習で得た特徴をさまざまな認識タスクへ転用することで、用途ごとのデータ整備やモデル開発の負担を軽減できる可能性があります。
GPTやGeminiなどのマルチモーダル基盤モデルによる画像理解
近年は、分類・物体検出・セグメンテーションといった認識技術に加え、画像と自然言語を組み合わせて扱うVLM(Vision-Language Model)や、GPT・Geminiなどのマルチモーダルな基盤モデルの活用が広がっています。
画像に対応したGPTやGeminiなどでは、何が写っているかを判定するだけでなく、内容を自然言語で説明したり、画像についての質問に回答したり、複数の情報を踏まえて推論したりすることが可能です。画像認識の用途は、対象の分類や検出に加え、画像の意味や状況を自然言語と結び付けて理解する領域へと広がっています。
例えば、製造現場の写真に対して「異常と思われる箇所を説明して」と質問したり、図面や帳票の内容を読み取って要点を整理したり、店舗画像から状況を説明させたりするといった使い方ができます。
ただし、製造業の外観検査や高速な物体検出など、特定の対象を高い安定性や低遅延で判定する用途では、CNNを用いた専用モデルやYOLOなどの物体検出モデルが適している場合もあります。そのため、導入時には、専用モデルの精度・速度と、マルチモーダル基盤モデルの柔軟な画像理解能力を比較し、用途に応じて使い分けることが重要です。
関連記事:「VLMとは?仕組み・LLMとの違い・メリット・デメリット・活用分野を徹底解説」
関連記事:「マルチモーダルAIとは?代表モデル・活用メリット・ビジネス活用事例や相談事例を徹底解説!」
画像認識に強いAI会社の選定・紹介を行います
今年度AI相談急増中!紹介実績1,000件超え!
・ご相談からご紹介まで完全無料
・貴社に最適な会社に手間なく出会える
・AIのプロが貴社の代わりに数社選定
・お客様満足度96.8%超
・物体検出、異常検知、類似画像検索等
完全無料・最短1日でご紹介 画像認識に強いAI会社選定を依頼する
実際にAI Marketにいただいた活用相談事例
AI Marketには、画像や映像を用いた業務効率化・品質向上について、多くの企業からご相談が寄せられています。
お客様から寄せられたご相談は以下のようなもので、AI Marketでは、コンサルタントがお客様の課題感をヒアリングし、適した技術・ソリューションを保有する企業をご紹介致しました。
- 図面・仕様書から自動見積積算を行うAIシステムの構築
- 食品工場の入場前作業(コロコロ・毛髪除去)の行動遵守チェックAI
- 配電盤のネジ締め・コネクタ接続不良のスマホ画像検知アプリ
- 液体残量の変化を測定するスマートフォン解析アプリ
- 製品本体画像・型番シールからSKUを特定する画像検索・OCRシステム
※実際のお客様からのご相談内容のため、企業特定に繋がる情報は伏せています。
① 図面・仕様書から自動見積積算を行うAIシステムの構築
ご相談企業様属性
- エリア:関東
- 従業員数:1,001人〜
要件・技術整理内容
電気通信設備の見積積算業務において、仕様書・数量表・図面・特記事項など複数のドキュメントをもとに手作業で積算を行っており、見積作成に時間がかかる点が課題となっていました。特に既存の積算パッケージでは対応できない独自記号や線情報、図面の読み取りが必要なケースが多く、自動化が進んでいない状況です。
そのため、PDF図面やCAD図面、仕様書などの非構造データを統合的に解析し、機器構成や数量を抽出した上で見積を自動生成する仕組みを希望されていました。また、3Dスキャンデータから図面を生成し、その情報を積算に連携するフローも将来的に検討されています。
カスタマイズ前提で図面意味理解まで含めた長期的な開発を視野に入れた相談となっていました。
② 食品工場の入場前作業(コロコロ・毛髪除去)の行動遵守チェックAI
ご相談企業様属性
- エリア:関東
- 従業員数:1,001人〜
要件・技術整理内容
食品工場の入場時に実施するコロコロクリーナーや毛髪除去などの衛生工程について、作業が確実に実施されているかをAIカメラで確認したいという相談です。現在は監視カメラ映像を人が確認しており、確認作業に工数がかかる点や見逃しが発生する点が課題となっていました。
求められているのは、特定の作業を行っていない人物の検知や、作業時間の不足、工程逸脱などを自動で検出する仕組みです。リアルタイム解析だけでなく、録画映像の後解析にも対応し、将来的には複数工程に横展開できる行動定義の登録機能も希望されています。
また、防護服やマスク着用状態での人物識別、複数人同時入場時の動作判定など、実環境に合わせた行動認識精度が求められていました。
③ 配電盤のネジ締め・コネクタ接続不良のスマホ画像検知アプリ
ご相談企業様属性
- エリア:関東
- 従業員数:1,001人〜
要件・技術整理内容
受配電キャビネット内部のネジ締め不良やコネクタ接続不良を検知するため、スマートフォンで撮影しながら点検を支援するアプリの検討相談です。配電盤内には数百点の確認箇所があり、目視点検では見落としが発生する可能性があるため、品質向上のための補助ツールとしての導入を希望されています。
固定カメラではなく作業者がスマートフォンを持って撮影し、画面上で即時判定される仕組みを想定しています。スプリングワッシャーの潰れ具合やネジの緩み、配線の抜けなど微細な状態を画像から判定し、異常箇所を提示する機能が求められています。
また図面や3Dモデル情報と連携し、点検対象箇所の抜け漏れを防止する仕組みも将来的な要望として挙げられていました。
④ 液体残量の変化を画像から測定するスマートフォン解析アプリ
ご相談企業様属性
- エリア:関東
- 従業員数:1,001人〜
要件・技術整理内容
ビニール袋状や筒状容器に入った液体の残量を、スマートフォンで定期撮影した画像から測定し、残量ゼロまでの時間を算出するアプリの開発相談です。容器は減少に伴い形状が変化するため、単純な液面検出ではなく、形状変化量から体積を推定する必要があります。
袋型容器では変形量の解析、筒状容器ではメモリ位置やピストン位置の認識など、容器タイプごとの計測ロジックが必要とされています。複数容器を同時管理し、残量低下時のアラート通知や将来的なシステム連携も視野に入れた要件です。
また正面・側面の複数画像やマーカー付与など、精度向上のための撮影条件も検討されています。
⑤ 製品本体画像・型番シールからSKUを特定する画像検索・OCRシステム
ご相談企業様属性
- エリア:関東
- 従業員数:101〜500人
要件・技術整理内容
多数の製品SKUの中から、スマートフォンで撮影した本体画像や型番シール画像をもとに該当品番を特定し、部品検索システムに連携する仕組みを検討されていました。色違いやサイズ違いなど外観差異が小さい製品が多く、誤案内を避けるため高精度な特定が必要とされています。
本体画像からの類似検索だけでなく、底面シールの文字情報を読み取りSKUを特定する方法も並行して検討されています。コンシューマ向けWebサービスへのAPI連携を前提とし、撮影ガイドUIや画像トリミングなどユーザー操作を簡略化する設計も求められています。
過去製品を含む数千SKU規模での検索精度と、部品検索サイトへの自動連携が要件として挙げられていました。
AI Marketでは、上記のように、様々な企業・教育機関からのAI活用相談を受け付けています。
生成AIツールを用いて、AI企業の選定をAIに相談するケースも増えています。しかし、実際のAI導入では、機密情報の取り扱い、実装可能性の判断、企業選定など、人が介在しないと判断が難しい要素も多く存在すると考えています。
だからこそAI Marketでは、実際の人間である専門のAIコンサルタントが直接お客様と対話し、ヒアリングから企業選定までを支援し、実現性の高いAI導入をサポートしています。
貴社でもAI活用をご検討中の際は、ぜひご相談ください。
画像認識に強いAI会社の選定・紹介を行います
今年度AI相談急増中!紹介実績1,000件超え!
・ご相談からご紹介まで完全無料
・貴社に最適な会社に手間なく出会える
・AIのプロが貴社の代わりに数社選定
・お客様満足度96.8%超
・物体検出、異常検知、類似画像検索等
完全無料・最短1日でご紹介 画像認識に強いAI会社選定を依頼する
画像認識にAIを導入するメリットは?
画像認識AIは、単なる技術トレンドではありません。貴社のビジネスを根幹から変えて、新たな成長軌道に乗せる可能性を秘めた戦略的ツールです。
主なメリットとして、以下の点が挙げられます。
- 業務効率化とコスト削減
- 品質向上と顧客満足度の改善
- 新サービス創出と競争優位の獲得
これらのメリットをさらに詳しく掘り下げていきます。
業務効率化とコスト削減
多くの企業にとって、画像認識AI導入の最も直接的で分かりやすいメリットは、業務プロセスにおける圧倒的な効率化と、それに伴うコスト削減効果でしょう。
人間が行ってきた「目で見て判断する」作業は集中力や体力を要し、時間的制約も伴います。画像認識AIは、これらの定型的な視覚タスクを継続的かつ高速に処理でき、特定の条件やタスクでは人間と同等以上の精度を実現できる場合があります。
これにより、以下のような効果が期待できます。
- 人件費の削減
- 生産性の向上
- ヒューマンエラーや見落としの低減
- 人材の最適配置
例えば、検査工程の時間が半減すれば、生産ライン全体のスピードアップに繋がります。また、不良品の流出や手戻り作業に伴う損失(時間・コスト)を大幅に削減します。
さらに、ルーティンワークから解放された従業員を、企画、開発、顧客対応といった、より高度な判断や創造性が求められるコア業務へと再配置することが可能になります。
関連記事:「画像認識AIの導入・運用費用内訳を徹底解説!ROIの考え方と向上させる方法は?」
品質向上と顧客満足度の改善
画像認識AIは、コスト削減や効率化といった「守り」の側面だけでなく、企業の生命線ともいえる「品質」の向上においても絶大な効果を発揮します。そして、その品質向上は、顧客満足度(CS)の向上という形で、明確なビジネス成果へと直結します。
例えば、製造業では人間の目では検出が困難なμm(マイクロメートル)単位の微細なキズや異物混入、色むらなどをAIが高精度で検知します。これにより、不良品率が劇的に低下し、製品品質の安定化・均質化が実現します。
結果として、クレーム削減、ブランドイメージ向上、顧客からの信頼獲得に繋がります。
新サービス創出と競争優位の獲得
画像認識AIの導入効果は、既存業務の改善だけに留まりません。むしろ、その真価は、これまでにない新しいサービスやビジネスモデルを創出し、競合他社に対する明確な優位性を確立する「攻め」の戦略において発揮されると言っても過言ではありません。
既存製品にAIを組み込むことで、その機能性や利便性を飛躍的に高め、競合製品との差別化を図ります。
例えば、店舗内のカメラ映像から顧客の動線、滞在時間、手に取った商品などを分析し、これまで把握できなかった顧客インサイトから、全く新しい商品開発やサービス事業の着想を得ることも可能です。
これらの取り組みは、単なる業務効率化とは異なり、企業の新たな収益源を生み出し、市場における独自のポジション(競争優位性)を築くための強力な武器となります。
画像認識に強いAI会社の選定・紹介を行います
今年度AI相談急増中!紹介実績1,000件超え!
・ご相談からご紹介まで完全無料
・貴社に最適な会社に手間なく出会える
・AIのプロが貴社の代わりに数社選定
・お客様満足度96.8%超
・物体検出、異常検知、類似画像検索等
完全無料・最短1日でご紹介 画像認識に強いAI会社選定を依頼する
AIによる画像認識の種類は?
AI画像認識の種類には、以下のようなものがあります。
- 分類
- 物体検出
- セグメンテーション(領域検出)
- 異常検知
- 姿勢推定・動作認識
- キャプション生成・視覚的質問応答
- 顔認証
- 文字認識(OCR)
- 検索
- 変化検出
それぞれの特徴について、詳しく解説します。
分類
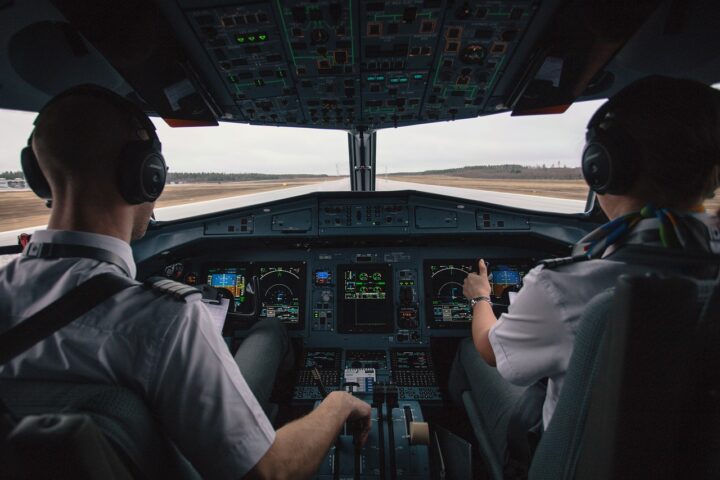
分類は、画像に写るものをカテゴリ(ラベル)として判定する技術です。また、全体の特徴から「屋内」「道路」「工場」「店舗」といったシーンを分類する用途にも活用されます。
例えば、ある画像に「多くの計器」「左右に座る制服姿の男女」「空の背景」などが写っているとします。これらの要素の組み合わせから、一般的に「飛行機の操縦室」であると推定できます。
このように、分類・シーン理解は画像全体の意味を掴む入口として、多くのAIの土台になります。
活用されている分野
- 視覚支援(視覚障害者向け:今いる場所・状況の説明)
- ロボット工学(周辺環境の把握→行動選択)
- 自動運転・ADAS(道路状況の認識:市街地/高速/工事区間など)
- 製造業(工程状態の分類:正常/要注意、設備稼働状態の識別)
- 医療(画像所見の分類:疾患候補の一次スクリーニング)
- クマ、シカ、カラスなどの害獣検知
物体検出
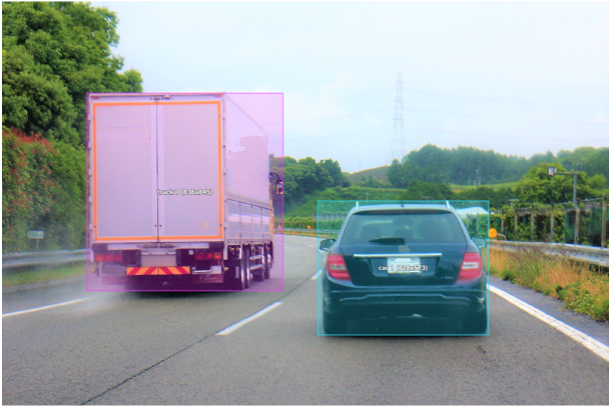
物体検出は、「何があるか」だけでなく「どこにあるか」まで特定する技術です。主に、物体の位置を矩形(バウンディングボックス)で表します。
近年、この技術は画像検査AIによる個数カウントでも大きく進展しています。単なる検出にとどまらず、追跡(トラッキング)まで含めて“数える・追う・異常を拾う”運用が一般化しました。
またセキュリティカメラ映像では、人物検出→追跡→異常行動検出や人数カウント(人流解析)に活用されます。店舗のAIカメラでは、棚の商品やレジ通過品など、個々の物体識別にも応用されます。
現場ではYOLOのような高速なアルゴリズムが重宝される一方、より複雑なシーンでは、画像全体の関係性を捉えるVision Transformer(ViT)系の採用も増えています。
活用されている分野
- 製造業(外観検査の前段:欠陥候補の位置特定、部品カウント)
- 小売(棚割・在庫監視、レジレス、万引き抑止の補助)
- 交通(自動運転・ADAS:車両/歩行者/標識の検出)
- 建設(重機・作業員の検出、安全帯未着用の検出補助)
- セキュリティ(侵入検知、人物追跡、群衆検知)
セグメンテーション(領域検出)
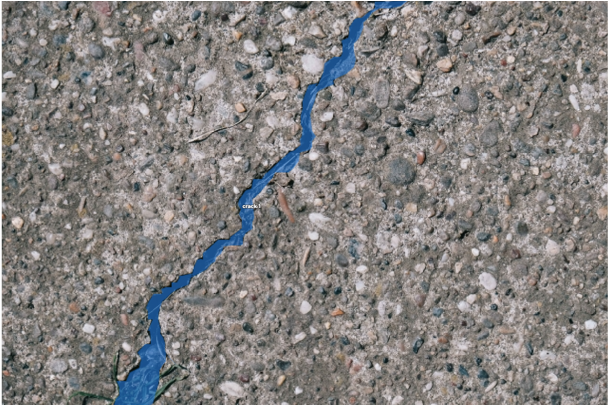
セグメンテーションは、画像中の各ピクセルが「どの物体/背景に属するか」を分類する技術です。物体検出よりも境界が正確に取れるため、形状・面積・輪郭が重要な業務で効果を発揮します。
例えば、道路や壁面のひび割れの位置・形状の抽出、医療画像で病変部位の正確な範囲推定などに使われます。自動運転でも、道路/歩道/車線などを分離し、運転環境をより正確に理解するために用いられます。
セグメンテーションには主に以下の種類があります。
- セマンティックセグメンテーション:同種の物体を同じグループとして識別(例:車は全部「車」)
- インスタンスセグメンテーション:同種の物体でも個体ごとに分離(例:車A/車B)
活用されている分野
- 製造業(塗りムラ・欠け・傷の範囲抽出、寸法推定の補助)
- 医療(腫瘍・臓器領域の抽出、手術支援の前処理)
- 建設・インフラ(ひび割れ・腐食の範囲抽出、補修量の見積支援)
- 自動運転(道路領域・走行可能領域の推定)
- 農業(病斑領域の抽出、収穫対象の範囲推定)
異常検知
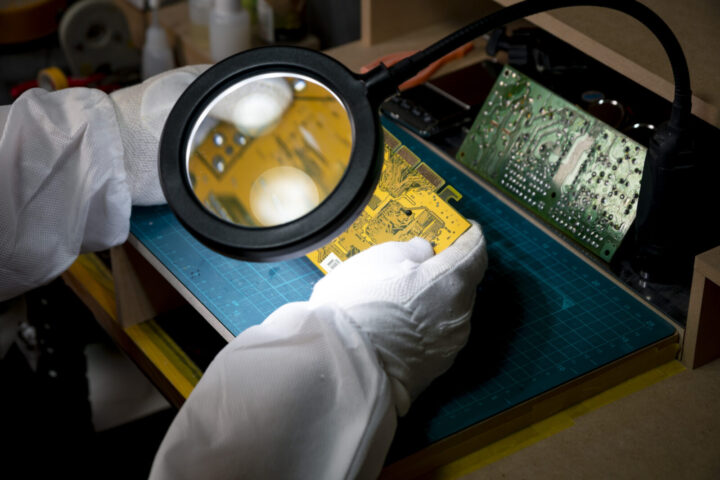
画像認識の中でも多く活用が進んでいるのが異常検知です。これは「正常のパターン」を学習し、そこからの逸脱を検出する考え方で欠陥検出に強いアプローチです。さらに、色検査も重要な応用分野として注目されています。
製造ラインの外観検査では、従来目視で判定していた傷・汚れ・欠けなどを、高精度に判別します。
また2D画像だけでなく、Lidarや3Dカメラを用いて、立体形状の異常(歪み・欠け・凹み)まで検査するケースも増えています。医療分野ではCT/MRIから異常組織の検出などにも活用されます。
活用されている分野
- 製造業(外観検査:傷・欠け・異物・汚れ・印字不良)
- 食品(異物混入、焼き色ムラ、形状不良)
- インフラ(設備点検:腐食・漏れ・ひび割れ)
- 医療(画像所見の異常候補検出)
- 物流(仕分けミス・ラベル不備・梱包不良の検知補助)
姿勢推定・動作認識
姿勢推定は、主に人物画像から骨格・関節の位置(キーポイント)を特定し、人物がどのような姿勢・動きをしているかを推定する技術です。代表的なライブラリとして以下があります。
- OpenPose:定番ライブラリで、関節を「点」で結ぶ
- Meta SAM 3D Body:人体全体を3Dメッシュとして復元し、ひねりや隠れ部位の推論が強い
プロスポーツ選手のフォーム解析、工場スタッフの動線・作業姿勢の改善など「人の動き」を数値化したい領域で強力です。
活用されている分野
- スポーツ(フォーム解析、怪我予防、戦術分析)
- 製造・物流(作業姿勢の改善、安全動作の監視)
- 自動車(居眠り・脇見・急病兆候などの検知補助)
- 介護・医療(転倒検知、リハビリ動作評価)
- エンタメ(モーションキャプチャ、AR/VR)
キャプション生成・視覚的質問応答
キャプション生成は、画像を説明する文章を自動生成する技術です。画像に写る物体だけでなく、状態・行動・関係性まで文章化できます。
また、画像に関する質問に答えるVisual Question Answering(VQA)も同系統で、画像×言語の相互理解を深めます。
視覚障害者支援アプリでは、写真を撮るだけで内容を音声で説明できます。SNSやECでは、自動生成キャプションを検索・整理に活用できます。
この領域では、VLM(Vision-Language Model)が中核技術として急速に普及しています。
活用されている分野
- アクセシビリティ(画像内容の読み上げ・説明)
- EC/メディア(自動タグ付け・検索性向上)
- カスタマーサポート(写真付き問い合わせの内容理解)
- 製造・点検(現場写真の要約、異常候補の言語化)
- 教育(教材の説明・QA)
顔認証
顔認証は、顔の特徴を数値化し、個人を特定・照合する技術です。セキュリティゲートやスマートフォンのロック解除など、本人確認のUXを大きく変えました。
活用されている分野
- 入退室管理(オフィス・工場・研究施設)
- 本人認証(スマホ・決済・会員サービス)
- 監視・防犯(要注意人物の検知補助)
- 空港・施設(搭乗・入場のスムーズ化)
文字認識(AI-OCR)
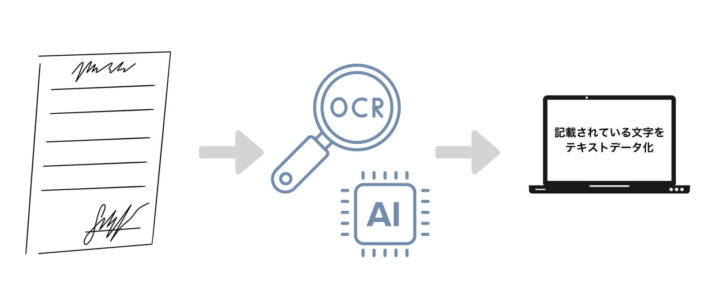
文字認識は、印刷文字や手書き文字を識別し、画像内の文字をテキストに変換する技術です。従来OCRにAIが加わり、AI-OCRとして精度が大きく改善しました。
AI-OCRは、データ入力自動化、郵便物仕分け、チェック(マーク)読み取り、図面読み取りなどで活躍します。
近年は生成AI連携により、読み取った文字列を「日付」「金額」などの項目として理解・整形する運用が現実的になっています。
活用されている分野
- 経理・会計(領収書/請求書の入力自動化)
- 金融(本人確認書類、申込書のデータ化)
- 物流(伝票、ラベル読み取り、仕分け)
- 製造(検査成績書、帳票、図面のデジタル化)
- 医療(紹介状・問診票のデータ化)
検索
画像検索(Image Retrieval)は、大量のデータベースから類似画像を検索・取得する技術です。テキスト検索だけでは説明しづらい「見た目が近い」を直接探せる点が強みです。
一般的には、画像から色・形状・テクスチャなどの特徴を抽出し、CNNやTransformerで高次元ベクトルに変換します。ベクトル検索により類似度を計算し、関連性の高い画像をランキング表示します。
活用されている分野
- EC(類似商品検索、コーデ提案)
- 製造(類似不良の検索、過去事例参照)
- メディア(写真整理、重複検出、素材管理)
- 医療(類似症例検索、参考画像検索)
- セキュリティ(特定人物・車両に類似する映像の探索)
変化検出
画像変化検出は、同一の場所や対象を異なる時点で撮影した画像を比較し、変化を検出する技術です。単発画像の理解ではなく、時間変化という文脈まで扱うのが特徴です。
例えば建設現場の定点カメラでは、建物形状の変化や資材移動などを検出し、進捗管理・安全管理の精度を上げられます。
活用されている分野
- 建設(進捗管理、資材移動検知、安全管理)
- インフラ(橋梁・道路の経時劣化監視)
- 防災(浸水・土砂崩れ・倒壊の把握)
- 農業(生育差・病害の早期検知)
- 製造(工程前後の差分検査、組付けミス検知)
画像認識に強いAI会社の選定・紹介を行います
今年度AI相談急増中!紹介実績1,000件超え!
・ご相談からご紹介まで完全無料
・貴社に最適な会社に手間なく出会える
・AIのプロが貴社の代わりに数社選定
・お客様満足度96.8%超
・物体検出、異常検知、類似画像検索等
完全無料・最短1日でご紹介 画像認識に強いAI会社選定を依頼する
画像認識に使われるAIモデル・アーキテクチャは?
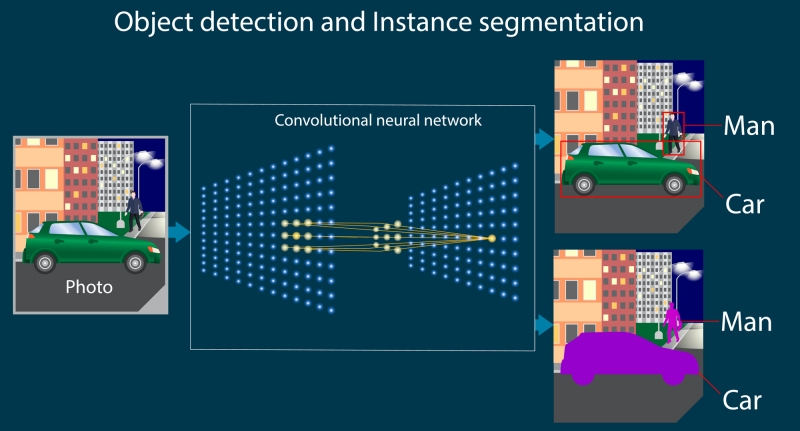
画像認識では、目的に応じてさまざまなAIモデルやアーキテクチャが利用されています。
従来から使われているCNN系モデルや物体検出モデルに加え、現在ではVision Transformer(ViT)、Vision Foundation Model、汎用セグメンテーションモデル、VLM(Vision-Language Model)なども実用化が進んでいます。
代表的なモデル・アーキテクチャは以下のとおりです。
- CNN系モデル(ResNet、EfficientNetなど)
- 物体検出モデル(YOLO、Faster R-CNNなど)
- Vision Transformer(ViT)系モデル
- Vision Foundation Model(DINOv3など)
- 汎用セグメンテーションモデル(SAM 3.1など)
- VLM・マルチモーダルモデル(CLIP、Geminiなど)
以下では、モデルの基本構造と用途別のモデルを整理して紹介します。各区分は相互に重なり、例えば物体検出やセグメンテーションのモデルにも、CNNやTransformerが利用されています。
CNN系モデル(ResNet、EfficientNetなど)
CNN(Convolutional Neural Network:畳み込みニューラルネットワーク)は、画像の局所的な特徴を段階的に学習するニューラルネットワークです。
分類や特徴抽出をはじめ、物体検出やセグメンテーションなど、長年にわたりコンピュータビジョンの基盤技術として利用されてきました。
代表的なCNN系モデルには、ResNetやEfficientNetなどがあります。
ResNet
ResNetは2015年に提案されたCNNアーキテクチャです。
スキップ接続(Residual Connection)を導入することで、非常に深いニューラルネットワークでも学習しやすくした点が特徴です。分類だけでなく、物体検出やセグメンテーションなどのバックボーンとしても広く利用されてきました。
EfficientNet
EfficientNetは2019年にGoogleの研究者によって提案された分類モデルです。
ネットワークの深さ、幅、入力画像の解像度をバランスよく拡大する「Compound Scaling」を採用し、比較的少ないパラメータ数で高い性能を目指したモデルです。
軽量なモデルも用意されており、モバイル端末やエッジ環境での認識にも利用されています。
物体検出モデル
物体検出モデルは、画像内に何が写っているかだけでなく、その物体がどこに存在するかまで特定するモデルです。
製造業の外観検査、人物検出、車両認識、商品カウントなど幅広い用途で利用されています。
代表的なモデルにはYOLOやFaster R-CNNなどがあります。
YOLO
YOLO(You Only Look Once)は、高速な物体検出を得意とする代表的なモデルシリーズです。
画像全体を効率的に処理できるため、監視カメラ、製造ライン、自動運転、ロボットなど、リアルタイム性が求められる用途で広く利用されています。
YOLOシリーズは継続的に進化しており、YOLO11(2024年)やYOLO26(2026年)などの新しいモデルも登場しています。
モデルを選ぶ際には、単純な精度だけでなく、推論速度、処理コスト、使用するハードウェア、誤検知と見逃しのどちらを重視するかなどを考慮する必要があります。
Faster R-CNN
Faster R-CNNは2015年に提案された代表的な物体検出モデルです。
画像から特徴を抽出したうえで物体候補の領域を検出し、それぞれの物体クラスや位置を推定します。
YOLOのようなリアルタイム性を重視するモデルとは設計思想が異なり、用途や求める精度・速度に応じて使い分けられています。
Vision Transformer(ViT)系モデル
Vision Transformer(ViT)は、自然言語処理で利用されてきたTransformerを画像認識へ応用したアーキテクチャです。
画像を小さなパッチに分割し、それぞれをTransformerで処理することで、画像内の離れた領域同士の関係も捉えやすいという特徴があります。
2020年のViT登場以降、Transformer系のアーキテクチャは分類だけでなく、物体検出、セグメンテーション、画像生成、Vision Foundation Modelなど幅広い分野へ利用が広がっています。
CNNが画像認識の中心だった時代から、現在ではCNNとTransformer系モデルを用途に応じて使い分ける形へと変化しています。
関連記事:「Vision Transformer(ViT)とは?仕組み・CNNとの違い・メリット・限界を徹底解説!」
Vision Foundation Model
近年は、大量の画像を事前学習することで汎用的な視覚特徴を獲得したVision Foundation Model(視覚基盤モデル)の活用が進んでいます。
従来は、分類、物体検出、セグメンテーションなどの用途ごとに専用モデルを学習することが一般的でした。一方、Vision Foundation Modelでは、大規模な事前学習によって得た汎用的な画像表現を、複数の認識タスクへ転用できます。
代表例のDINOv3は、Metaが2025年に公開した自己教師あり学習ベースのVision Foundation Modelです。ラベルの付いていない大量の画像から汎用的な視覚表現を学習し、分類、物体検出、セグメンテーション、動画内の物体追跡など幅広いタスクに利用できます。
また、事前学習済みのバックボーンをそのまま利用し、比較的少量の教師データで用途ごとのモデルを構築しやすい点も特徴です。
こうしたVision Foundation Modelの普及によって、画像認識AIの開発では「大量の教師データを用意してゼロからモデルを学習する」以外の選択肢が広がっています。
汎用セグメンテーションモデル
汎用セグメンテーションモデルは、画像や動画内の対象物をピクセル単位で抽出するための基盤モデルです。代表的なモデルがMetaのSegment Anything Model(SAM)シリーズです。
従来のセグメンテーションでは、対象となる物体ごとに大量の教師データを用意して専用モデルを学習するケースが一般的でした。一方、SAMシリーズでは大規模な事前学習を行ったモデルに対して、クリックや領域指定、テキストなどのプロンプトを与えることで、さまざまな対象を抽出できます。
2026年に公開されたSAM 3.1では、画像だけでなく動画内の複数物体について、検出・セグメンテーション・追跡を効率的に行えるようになっています。
関連記事:「Segment Anything Modelとは?Metaのセグメンテーションモデルの特徴、活用事例を徹底解説!」
VLM・マルチモーダル基盤モデル
VLM(Vision-Language Model)やマルチモーダル基盤モデルは、画像とテキストなど複数の情報を組み合わせて扱えるAIモデルです。
この領域には、画像とテキストの対応関係を学習して画像検索やZero-shot分類に使われるモデルから、画像の内容を自然言語で説明したり、質問に回答したり、複数の情報を踏まえて推論できる汎用的なモデルまで含まれます。
代表的なモデルには以下があります。
- CLIP:画像とテキストを共通のベクトル空間で扱うモデル。画像検索やZero-shot分類などに利用
- Gemini:テキスト、画像、音声など複数のデータ形式を扱えるマルチモーダル基盤モデル
- GPT系のマルチモーダルモデル:画像を入力し、内容の説明、質問応答、文書理解、推論などに利用
一方で、VLMやマルチモーダル基盤モデルがすべての画像認識用途に適しているわけではありません。
例えば、製造業の外観検査やリアルタイム物体検出のように、決められた対象を高速かつ安定して判定する用途では、CNNやYOLOなどの専用モデルが適している場合があります。
そのため、画像認識AIを導入する際は、VLMやマルチモーダル基盤モデルの柔軟な画像理解能力と、専用モデルの精度・速度・コスト特性を比較し、用途に応じて使い分けることが重要です。
業界別活用方法は?
製造、小売、物流、医療など、業界ごとの代表的な用途を紹介します。より詳しい事例は、業界別の活用事例をご覧ください。
製造業
| 活用方法 | 活用方法の説明 |
|---|---|
| 不良品の検知(外観検査) | 製造ラインにおいて、製品の外観を分析し、傷や変形などの不良を自動的に検出 画像認識AIを活用して、製品や部品の外観を自動的に検査 |
| 設備劣化の判定(予知保全) | 工場内の機械設備や生産ラインの状態を監視し、劣化や異常を早期に検出 |
| 図面の読み取りと管理 | 図面データベースから必要とする図面を迅速かつ高精度で検索する |
| 作業分析 | 作業手順を分析し、無駄な動作をなくして生産性を向上 |
| 部品の識別や検索業務 | 類似画像検索システムを導入することで、外観が類似した部品を瞬時に特定でき、在庫管理や調達業務の負担を軽減 |
| 倉庫でのピッキング | ビンピッキング:部品や製品などが無造作に入れられた容器(ビン)から、必要な対象物をロボットが取り出す工程の自動化 |
関連記事:「製造業での画像認識AI導入事例は?効果や活用事例を徹底解説!」
自動車・交通
| 活用方法 | 活用方法の説明 |
|---|---|
| 自動運転支援 | 車載カメラからの映像をリアルタイムで分析し、道路状況、他の車両、歩行者などを認識 ※オプティカルフロー技術やセンサーフュージョン技術も活用 |
| 横断歩道の検出 | 地図データとを組み合わせて横断歩道を正確に検出し、歩行者の安全確保に貢献 |
| 設計作業の支援 | CADにAIを統合することで、設計プロセスを自動化できるほか、データの解析やパターン認識を通じて設計提案 |
Eコマース・小売
| 活用方法 | 活用方法の説明 |
|---|---|
| 顧客の視線解析(アイトラッキング) | 顧客が商品棚のどこを見ているか、どのように見ているか等を分析 |
| 購買行動分析 | 顧客行動分析やパーソナライズされた商品レコメンデーション、ビジュアル検索機能の提供 |
| ビジュアル検索機能 | 参考画像をアップロードするだけで視覚的に近い商品を類似画像検索 |
| 真贋判定 | 対象となる製品や情報が本物であるか、それとも偽物・模造品であるかを見極める |
関連記事:「小売業・スーパーのAI活用事例12選!メリット・需要予測・マーケティング・流通の課題を解決」
関連記事:「EC業界でのAI活用方法は?メリットや注意点、活用事例を徹底解説!」
流通・物流
| 活用方法 | 活用方法の説明 |
|---|---|
| 在庫管理 | 店舗の棚やバックヤードの画像を分析し、商品の在庫状況をリアルタイムで把握 |
| 荷崩れ防止 | トラックなどに積載された荷物の荷姿を画像認識して輸送中の荷崩れを防止する |
| 通関書類処理 | 多様なフォーマットや言語で記載された品名、数量、金額、契約条件などを高精度に読み取り、システムへ自動入力 |
関連記事:「物流業界向けAI導入・活用事例!メリットや課題、倉庫・配送・検品管理向けサービス」
セキュリティ
| 活用方法 | 活用方法の説明 |
|---|---|
| 生体認証 | 顔認識や虹彩認識などの生体情報を分析し、個人を特定 |
| 防犯カメラ | 危険エリアや進入禁止エリアなどへの侵入検知や不審行動検知 |
建設・インフラ・公共事業
| 活用方法 | 活用方法の説明 |
|---|---|
| インフラ点検 | ドローンで撮影した橋梁や建築物の画像を分析し、ひび割れや腐食を検出 |
| 安全管理 |
|
| 非破壊検査 | 水道管やガス管の内部を撮影した画像を分析し、腐食や亀裂などの異常を検出 |
| 図面の読み取りと管理 | 図面データベースから必要とする図面を迅速かつ高精度で検索する |
| 設計作業の支援 | CADにAIを統合することで、設計プロセスを自動化できるほか、データの解析やパターン認識を通じて設計提案 |
| 排水処理 | 排水処理の遠隔化 |
| 水質検査 | 水中に含まれる化学物質や微生物の濃度などを測定し、水の安全性・衛生状態を評価する |
| 防災 | 治水監視 |
関連記事:「建設業におけるAIの活用と導入について、最新の開発状況と具体的な用途」
環境保護
| 活用方法 | 活用方法の説明 |
|---|---|
| 生態系モニタリング |
スポーツ
| 活用方法 | 活用方法の説明 |
|---|---|
| パフォーマンス分析 | 選手の動作を高精度カメラで撮影し、姿勢、スピード、角度などを詳細に分析。フォームの改善点や怪我のリスクを特定し、トレーニング計画の最適化に活用。 |
| 戦術分析 | 試合映像から選手の動きのパターン、ポジショニング、チーム全体の戦術的傾向を自動で分析。対戦相手の特徴や弱点を把握し、効果的な戦術立案に活用。 |
| 審判の判定支援 | 高速カメラと組み合わせて、人間の目では判断が難しい接近したプレーや瞬間的な事象を正確に判定 |
関連記事:「スポーツとAIの融合で可能になる未来と事例、メリット・デメリットを紹介」
文化財保護・芸術
| 活用方法 | 活用方法の説明 |
|---|---|
| 文化財管理 | 美術品の真贋判定や文化財の劣化状態モニタリング |
教育
| 活用方法 | 活用方法の説明 |
|---|---|
| 学習支援 | 学習者の表情・姿勢分析による集中度の測定や手書き文字の認識による採点支援 |
関連記事:「教育業界に強いプロ厳選AI開発会社」
農業
| 活用方法 | 活用方法の説明 |
|---|---|
| 作物管理 | ドローンや衛星画像を用いた作物の生育状況モニタリング、病害虫の早期発見 |
関連記事:「農業にAIを導入することに対するメリット/デメリットや、具体的な活用事例」
医療・介護
| 活用方法 | 活用方法の説明 |
|---|---|
| 画像診断支援 | X線やMRI画像の分析による腫瘍や異常の検出、皮膚がんの早期発見 |
| 患者モニタリングシステム | 患者のバイタルサインや身体活動などの情報をリアルタイムで把握し、異常の早期発見や治療判断を支援 |
| 転倒検知 | 利用者にデバイスを装着させることなく転倒を自動検知 |
関連記事:「医療・製薬業界に強いプロ厳選おすすめAI開発会社」
エンターテインメント・メディア
| 活用方法 | 活用方法の説明 |
|---|---|
| コンテンツの自動タグ付けと分類 | コンテンツ内の人物、物体、シーン、感情表現などを自動で認識し、適切なタグを付与 |
| 著作権侵害コンテンツの検出 | 著作権で保護されたコンテンツの無断使用や改変を自動的に検出 |
| 視聴者の感情分析 | 視聴者の表情や反応をリアルタイムで分析し、感情の変化を追跡 |
関連記事:「テレビ・ラジオ業界のAI活用方法は?メディアでの活用事例・導入事例」
企業が導入する手順は?
画像認識AIの導入方法は、既存のクラウドサービスやマルチモーダル基盤モデルを利用する場合と、自社データで専用モデルを構築する場合で異なります。
専用モデルを開発する場合は、目的設定、データ整備、モデル選定・構築、PoC、実装、継続改善という流れが一般的です。
以下では、専用のモデルを開発する際のそれぞれのステップについて説明します。
関連記事:「AI開発の手順は?AIシステム構築の流れを徹底解説!失敗しない為の注意点もわかる完全ガイド」
導入する目的と必要な精度を明確にする
画像認識モデルの導入を計画する最初のステップは、その目的と必要な認識精度を明確にすることです。
自動運転や医療画像診断など人命に関わる目的であれば、高い精度が求められます。逆に、一部の書類の文字認識などに用いる場合は、ある程度の精度が担保されていれば、コストを抑える方向性もあります。
精度に関しては、社内でも以下のような誤解が広まらないように正しいスタンスを周知することが重要です。
| 精度に関するよくある誤解 | 正しい見解 |
|---|---|
| 常に100%正確である | 精度は撮影条件や学習データ、対象物、判定基準などによって変動します。最新のアルゴリズムを使用しても、条件によっては誤判定が発生します。 |
| 人間よりも常に劣っている | 特定のタスクにおいては、AIが人間の能力を上回ることがあります。 |
| 精度は単一の数値で表すことができる | 精度は、用途や設定した判定閾値によって大きく変わります。例えば、法執行機関の使用では高い精度閾値が設定されますが、エンターテイメント目的では低い閾値でも十分な場合があります。 |
導入目的によって必要な精度は変動するため、この段階で具体的な目標を設定することが重要です。
画像認識ソリューションの選び方
画像認識技術の導入方法としては、クラウドサービス、オープンソース、カスタム開発など複数のアプローチが存在します。
自社の目的やリソース、必要な柔軟性に応じて最適なソリューションを選ぶために、以下の表を参考にしてください。
| ソリューション | 手法 | メリット | ポイント |
|---|---|---|---|
| クラウドサービス | 既存の画像認識API(例:Google Cloud Vision、AWS Rekognition、Azure AI Vision等)を利用 | 短期間で導入可能、初期投資が少なく済む | 迅速に導入したい場合。最新の技術更新が自動的に反映される点も魅力だが、カスタマイズ性が低い場合も多い。精度向上が難しい。 |
| オープンソース | Tensorflow、PyTorch、OpenCVなど、無料で利用できるライブラリの活用 | 柔軟性が高く、コミュニティでのサポートが豊富 | 自社で技術開発が可能な場合や、カスタマイズ性を重視する企業。ライセンスや保守、セキュリティ面の検討が必要。 |
| カスタム開発 | 自社または専門開発会社と協力して、ゼロから開発 | 業務ニーズに最適化された専用ソリューションが構築できる | 特定の業務要件や高い精度・独自機能が必要な場合。初期投資や開発期間が長くなるが、長期的には競争優位性を確立できる可能性が高い。 |
データ収集
画像認識AIでは、用途や採用するモデルに応じて必要な画像データを準備します。
独自モデルをゼロから学習する場合には一定量の画像データが必要ですが、現在は事前学習済みモデルや転移学習、自己教師あり学習、Few-shot Learning、Vision Foundation Modelなどを活用することで、比較的少ないデータから開発を始められるケースも増えています。
データの収集方法は主に以下の2つに分かれます。
- 公開データセットの利用:CIFAR-10、ImageNet、COCO等の既存のデータセットを活用
- 独自データの収集:自社製品や特定の対象物の画像を収集
重要なのは単純な画像枚数ではなく、実際の利用環境を十分に反映したデータを用意できるかどうかです。
関連記事:「AI学習用のデータ収集代行会社プロ厳選おすすめ」
データの加工
画像データの前処理は、モデルの学習効率と精度向上に重要です。以下のような処理を行います:
- リサイズ:すべての画像を同じサイズにリサイズ
- 正規化:ピクセル値を0-1の範囲に正規化
- データ拡張:回転、反転、ズーム等の変換を適用
モデルの選定・構築
データの収集・前処理が終わったら、用途や求める精度・処理速度に応じてモデルを選定・構築します。事前学習済みモデルの活用や、自社データによる追加学習などを検討します。
開発にはPythonがよく用いられ、OpenCVやPillowで画像を処理し、TensorFlowやKerasなどでモデルの構築・学習・評価を行います。
関連記事:「PythonがAI開発で使われるのはなぜ?理由・メリット・デメリット・活用例を徹底解説!」
PoC(概念実証)の実施
十分なデータの用意が整ったら、小規模なPoC(Proof of Concept:概念実証)を行います。これは本格導入前にAIが自社課題を解決できるかを試す実験段階です。
限られた範囲でプロトタイプの画像認識モデルを構築し、例えば「工場ラインの一工程だけで不良検知AIを試す」「店舗の一部商品カテゴリで欠品検知を試行する」といった具合に実施します。
PoCの目的は技術的実現性の確認だけでなく、得られる効果の測定と課題の洗い出しです。結果をもとに精度が目標に達しているか、処理速度や現場との相性に問題はないかを評価します。
もし結果が思わしくなければ、この段階でモデルの改善(追加データ学習やパラメータ調整)やアプローチの見直しを行います。経営層に対しては、PoCフェーズで早期にリスクを検知・対応することで、無駄な投資を抑えつつ成功率を上げるステップであることを説明します。
成功したPoCは社内のAI導入機運を高める材料にもなるため、小さく成功体験を積むことの重要性も強調します。
実装・検証
モデルの学習が完了したら、実際にそれを使用して画像認識を試みます。画像データを学習用とテスト用に分け、テスト用データを用いてモデルの性能を検証します。
その結果を基に、モデルの改善点を明らかにし、必要に応じて調整を行います。
- テストデータでの評価:精度、適合率、再現率等の指標を確認
- 過学習の確認:訓練データと検証データでの性能比較
- ハイパーパラメータの調整:学習率、バッチサイズ、層の数等を最適化
- モデルのファインチューニング:転移学習を適用し、特定のタスクに適応
継続改善
モデルの評価と調整を行った後は、再度学習を行い、その結果を元にモデルを改善していきます。このプロセスを繰り返すことで、徐々にモデルの性能を向上させていくことが可能になります。
AI画像認識を活用する際の注意点
AI画像認識を活用する際の注意点は以下です。
| 注意点 | 概要説明 |
|---|---|
| データの量とクオリティ | 必要なデータ量は、用途やモデル、事前学習済みモデルの利用有無によって大きく異なる。単純な枚数だけでなく、実際の利用環境を反映したデータ品質や偏りの少なさが重要。 |
| 学習・検証期間の確保 | 独自モデルの学習だけでなく、撮影条件の調整、評価、再学習、モデル更新などを含めた継続的な検証が必要。 |
| コンセプトドリフト | 照明・カメラ・製品仕様・背景が変わると精度が落ちる 監視指標(不良率/再検査率)と再学習ルールを最初から決める |
| 撮影環境の整備 | カメラの質や設置位置が重要。適切な撮影環境を整えないと、精度が低下する可能性がある。 |
| 情報セキュリティとプライバシー | 個人情報保護や肖像権に配慮が必要 適切なセキュリティ対策が求められる。 |
| 機能の適切な選択 | 自社ビジネスに必要な機能を把握し、適切なAI画像認識を選択することが重要。 |
| 誤認識の可能性 | 完全に誤認識を排除することは難しく、対策が必要。 |
| ブラックボックス問題 | AIの判断根拠が不明確な場合、結果の信頼性が問われる 説明可能AIの開発が進んでいる。 |
| 再学習時の品質管理 | 新たなデータ学習時に以前の学習内容を忘れる現象 |
| バイアスの問題 | 学習データや設計者のバイアスにより、AIの判断に偏見や差別が含まれる可能性がある。 |
| 説明可能性の確保 | AIの判断プロセスを人間が理解・説明できるようにする必要がある。 |
| プライバシー侵害のリスク | 個人情報の目的外利用や漏洩のリスクがあり、適切な管理が必要。エッジAIの活用も検討される。 |
注意点を踏まえて、画像認識においてAIが得意とすること、不得意とすること、現状の課題に対する解決策をこちらの記事で解説しています。
画像認識AIの導入で押さえるべき法令・ガバナンス
画像認識は、対象によっては個人情報・生体情報・監視に該当し、技術より先に運用ルールが必要になります。
日本(個人情報保護法/APPI)では、顔などの身体的特徴をデータ化したものは「個人識別符号」に該当し得ます。つまり「映っている」だけでなく、照合可能な形で扱う時点で管理水準が上がると考えるのが安全です。
EU AI Actでは、用途によっては「禁止」または「高リスク」に分類され、透明性・リスク管理・記録・人の監督などが強く求められます。特に生体認証や公共空間の監視は要注意領域です。
企業としては、法令対応を“現場で回る形”にするために、最低限次を決めておくと導入がスムーズです。
- 目的:何のために撮り、何を判定し、誰が使うか
- 保管:保存期間、アクセス権、匿名化/マスキング
- 監督:誤判定時の人手レビュー手順
- ログ:いつ、何を、どう判定したか(監査可能性)
さらに、AIガバナンスを社内制度として整えるなら ISO/IEC 42001(AIマネジメントシステム) を参照すると、属人的な運用から抜けやすくなります。
最新の画像認識技術動向
認識精度と適用範囲を大きく広げる可能性を秘めている技術を紹介します。また、自然言語処理など他のAI分野との融合により、マルチモーダルな理解も可能になってきています。
一方で、実世界への応用には、データの収集やアノテーション、モデルの解釈性など、まだ多くの課題が残されています。今後のさらなる研究と発展が期待されます。
ロボティクスの融合
視覚情報を取得・分析する技術は、ロボティクスの分野でも欠かせない要素です。主に以下の用途で活用されています。
- 物体認識を用いたロボットマニピュレーション
- 環境理解に基づくロボットナビゲーション
- 人とロボットのインタラクションにおける視覚情報の活用
特に、Metaのスマートグラス「Aria Gen 2」などを活用し、人間が見ている世界や手の動きを一人称視点でデータ化することで、ロボットが人間の行動を模倣したり、意図を汲み取ったりする研究が加速しています。
Few-shot Learning
Few-shot Learning は、少量のデータから効果的に学習するための手法です。従来の機械学習では大量のデータを必要としましたが、Few-shot Learning ではメタ学習の考え方を取り入れ、わずかな例から新しいクラスを認識できるようにします。
この手法を用いることで、データが少ない場合でも高精度な画像認識が可能になります。
関連記事:「Few Shot Learning入門:ファインチューニングとの違いは?どんな分野で使う?失敗しない注意点を解説」
Zero-shot Learning
Zero-shot Learning は、学習時に一度も見たことがないクラスを認識する手法です。属性情報や言語情報を利用して、未知のクラスに対する認識能力を獲得します。
例えば、「黄色くて長い」という属性情報から「バナナ」を認識するような場合に用いられます。Zero-shot Learning により、画像認識の適用範囲が大きく広がることが期待されます。
Zero-shot Learningの仕組み、活用事例をこちらの記事で詳しく説明していますので併せてご覧ください。
自己教師あり学習(Self-supervised Learning)の進化
自己教師あり学習(SSL:Self-supervised Learning)は、教師なし学習の1つで特徴表現を学習する手法です。画像の一部を隠して復元させたり、画像の変換に対して不変な特徴を学習させたりすることで、ラベルのない大量の画像データから汎用的な特徴表現を獲得します。
事前学習モデルを用いることで、少量のデータでも高精度な画像認識が可能になります。
3D情報や複数のセンサーを組み合わせた画像認識
画像認識では、通常の画像に加えて、深度や立体形状などの情報を組み合わせ、2D画像だけでは捉えにくい特徴を判定に利用する方法も活用されています。
例えば、外観検査では画像の色や模様と深度情報を組み合わせ、傷や汚れだけでなく、凹みや変形などの検出に役立てます。姿勢推定でも、画像から人体の立体的な姿勢を推定し、作業動作やスポーツのフォーム分析に利用する技術が研究・開発されています。
また、高速に動く対象を捉える用途では、明るさの変化を検出するイベントカメラなど、撮影機器の特性を活かした認識方法もあります。対象や検出したい異常に応じて、画像だけで十分か、追加のセンサー情報が必要かを検討することが重要です。
合成データによる学習データの補完
画像認識AIの開発では、シミュレーションや画像生成技術を用いて合成データを作成し、実際に収集した画像を補う方法があります。
例えば、製造業では不良品の発生頻度が低く、傷や欠けなどの画像を十分に集められない場合があります。そのような場合に、欠陥や撮影条件の違いを人工的に再現し、学習データの多様性を補います。
ただし、合成画像と実際の現場画像には違いがあるため、合成データを増やすだけで精度が向上するとは限りません。実際の利用環境で撮影した画像を用いて、見逃しや誤検知への影響を確認する必要があります。
画像認識と社内データ・RAGの連携
画像認識の結果を、社内のマニュアルや製品情報、過去の対応事例などと組み合わせ、業務に必要な回答や説明を生成する仕組みへの応用も進んでいます。
例えば、製品画像から類似する部品を検索し、部品データベースの仕様情報と合わせて候補を提示したり、現場写真から読み取った情報をもとに関連マニュアルを検索し、確認手順を案内したりする使い方があります。
こうした仕組みでは、画像検索やVLMによる画像理解に、関連情報を検索して回答に利用するRAG(検索拡張生成)を組み合わせます。画像からの読み取り結果と、検索した資料に基づく情報を区別し、参照元を確認できる設計にすることが重要です。
関連記事:「RAG(検索拡張生成)とは?導入相談事例・LLMとの連携シーン・メリット・システム構築の注意点を徹底解説!」
エッジデバイスでの展開
モデルの軽量化や処理の最適化により、スマートフォンや工場内の端末などで画像認識を実行する方法が活用されています。
例えば、製造ラインの画像を現場の端末で解析することで、クラウドへの送信に伴う遅延や通信量を抑えられます。画像を外部に送信しない構成も可能です。
関連記事:「エッジAIとは?メリット・クラウドとの使い分け・相談事例や活用事例を徹底解説」
画像認識についてよくある質問まとめ
- AI画像認識はどのような業務に向いていますか?
AI画像認識は、製品の外観検査、人物や車両の検出、在庫確認、異常検知、文字認識、画像検索、作業行動の分析など、目視確認や画像・映像の判定が発生する業務に向いています。
特に、判断基準をある程度定義でき、一定量の画像や映像を継続的に取得できる業務では導入効果を期待しやすくなります。
- 画像認識AIの精度はどのくらい出ますか?
画像認識AIの精度は、対象物、撮影環境、画像データの質、モデル、判定基準などによって大きく異なります。
そのため、一律に「何%の精度が出る」とは言えません。実際の導入では、精度だけでなく、誤検知と見逃しのどちらを重視するか、処理速度やコストまで含めて評価することが重要です。
- 画像認識AIの導入には大量の画像データが必要ですか?
必ずしも大量の画像データが必要とは限りません。独自モデルをゼロから学習する場合は一定量のデータが必要ですが、現在は事前学習済みモデル、転移学習、Vision Foundation Model、Few-shot Learningなどを活用し、比較的少ないデータから開発を始められるケースもあります。重要なのは枚数だけでなく、実際の利用環境を反映した質の高いデータを用意することです。
- VLMやVision Foundation Modelを使えば従来の画像認識モデルは不要になりますか?
従来の画像認識モデルが不要になるわけではありません。VLMやVision Foundation Modelは、画像の意味理解や自然言語による検索・説明などに強みがあります。一方、製造業の外観検査やリアルタイム物体検出など、特定対象を高速かつ安定して判定する用途では、CNNやYOLOなどの専用モデルが適している場合があります。用途に応じた使い分けが重要です。
- 画像認識AIを導入する場合、既存サービスとカスタム開発のどちらを選ぶべきですか?
一般的な物体認識やOCRなどであれば、クラウド型の画像認識APIや既存サービスを利用することで短期間・低コストで導入できる場合があります。
一方、自社固有の製品や微細な欠陥、特殊な撮影環境などに対応する場合は、カスタム開発が必要になることがあります。必要な精度、導入期間、コスト、カスタマイズ性を比較して選定することが重要です。
導入する際は専門会社へ
画像認識AIは、製品検査や在庫管理、セキュリティなど、幅広い業務の自動化・高度化に活用できます。
Amazon RekognitionやAzure AI Visionのように、比較的短期間で試せるサービスも増えています。一方で、必要な精度や撮影環境、データ整備、法令・プライバシーへの対応は用途ごとに異なります。
自社だけで要件や技術方式を判断することが難しい場合は、画像・映像解析に詳しい専門会社へ相談するとよいでしょう。
AI Market 運営、BizTech株式会社 代表取締役|2021年にサービス提供を開始したAI Marketのコンサルタントとしても、お客様に寄り添いながら、現場のお客様の課題ヒアリングや企業のご紹介を5年以上実施しています。これまでにLLM・RAGを始め、画像認識、データ分析等、1,000件を超える様々なAI導入相談に対応し、参加累計8,000人を超えるAIイベントを主催。AIシステム開発PM歴8年以上。AI Marketの記事では、AIに関する情報をわかりやすくお伝えしています。(JDLA GENERAL 資格保有)
▶ 監修者の実績・経歴を詳しく見る
AI Market 公式𝕏:@AIMarket_jp
Youtubeチャンネル:@aimarket_channel
TikTok:@aimarket_jp
運営会社:BizTech株式会社
掲載記事に関するご意見・ご相談はこちら:ai-market-contents@biz-t.jp
お電話で無料相談

