

LLMとは?活用相談事例・AIエージェントとの連携・導入方法とコスト・代表的モデルを徹底解説!
最終更新日:2026年09月07日
記事監修者:森下 佳宏|BizTech株式会社 代表取締役
生成AI(ジェネレーティブAI)の発展に伴い、「LLM(大規模言語モデル)」への関心が高まっています。特に、ChatGPTの急速な普及によりメディアでも非常に多く取り上げられています。
多くの企業が導入を検討する一方で、どのモデルを選べばいいのか、自社開発は必要なのか、どう活用できるのかといった疑問を抱えています。
この記事では、LLMとはなにか、正しい理解と具体的な活用方法、導入コストの分析、さらには、AI Marketで実際に開発企業の紹介を行った事例についてもわかりやすく解説します。適切な選定と活用がどう自社の成長につながるのかを理解できるでしょう。
LLM・RAG開発が得意なAI開発会社について知りたい方はこちらで特集していますので併せてご覧ください。
目次
LLM(大規模言語モデル)とは?
LLM(Large Language Models)とは、多くのテキストデータから学習し、人間のような文章を生成できるAIモデルの一種です。自然言語処理(NLP)の分野で最先端の技術であり、昨今注目されている生成AIの代表格と言えます。日本語では、「大規模言語モデル」と言われます。
AIモデルにどんな種類があるかこちらの記事で詳しく説明していますので併せてご覧ください。
ほとんどのLLMはインターネット上の膨大なテキスト情報からパターンを学び取ります。自然言語処理(NLP)の分野の一種であり、人々が普段使う言語を理解し生成する能力を持ちます。
大量のデータと複雑なアルゴリズムに基づいて動作し、多岐にわたるタスクで使用されることが一般的です。
LLMの歴史
自然言語処理の初期の段階では、ルールベースや統計ベースの手法が主に用いられました。
2010年代初頭ごろから、ディープラーニング(深層学習)の進展に伴い、単語の埋め込みやRNN、LSTMなどのアーキテクチャが開発されました。また、word2vecもこの時期に登場し、従来の自然言語処理技術に革新をもたらしました。
2017年、Googleの研究者らはLLMの基盤となったTransformerアーキテクチャを提案しました。このアーキテクチャは、文中の単語どうしの関係を捉える自己注意機構(Self-Attention)を中心に、再帰や畳み込みを用いずに構成されており、自然言語処理の発展を大きく促し、その後の普及の基盤となりました。
このTransformerをベースに、BERTやGPTのような有力モデルが登場しました。特に、GPTシリーズは大規模なパラメータを持つモデルとして注目されています。
2020年代に入ると、より大規模なモデルが開発され、LLMが主流となりました。OpenAIのGPT-3、GPT-4などが代表例です。
ChatGPTはLLM?
ChatGPTは直接的にLLMそのものではなく、それを基に構築された対話型AIのサービスです。OpenAIのGPTシリーズが裏側で動いており、質問への回答、文章生成、会話シミュレーションなどを行います。
このように、ChatGPT自体はLLMそのものではなく、それをベースとし、コミュニケーションを取りやすいインターフェースを持つ対話型サービスというのが正確な表現です。
関連記事:「ChatGPTとは?できることは?どのように活用できるのか?ChatGPTの基本を徹底解説」
LLMに強い会社・サービスの選定・紹介を行います
今年度LLM相談急増中!紹介実績1,000件超え!
・ご相談からご紹介まで完全無料
・貴社に最適な会社に手間なく出会える
・AIのプロが貴社の代わりに数社選定
・お客様満足度96.8%超
・GPT、Claude、Gemini、Llama等の複数モデルに対応
完全無料・最短1日でご紹介 LLMに強いAI会社選定を依頼する
実際にAI MarketにいただいたAI活用相談事例
AI Marketには、製造業、教育機関、EC、小売関連部門など幅広い組織から、LLMやRAG、AIエージェントを活用した業務効率化や社内ナレッジ活用に関する相談を多くいただいております。
お客様から寄せられたご相談は以下のようなもので、AI Marketでは、コンサルタントがお客様の課題感をヒアリングし、適した技術・ソリューションを保有する企業をご紹介致しました。
- 気象画像のテキスト化と原稿照合を行う業務補助ツールの構築
- ECカスタマーセンターにおける返信支援・オペレーター支援の導入検討
- 社内資料レビューを支援するLLM活用環境の検討
- 大学部門向けAI+RAG検索・分析基盤の構築検討
- 品質保証・技術伝承を支える対話型ナレッジ検索基盤の整備
- 少数ファイルから始める生成AI活用検証と比較導入の検討
※実際のお客様からのご相談内容のため、企業特定に繋がる情報は伏せています。
① 気象画像のテキスト化を行う業務補助ツールの構築
ご相談企業様属性
- エリア:中部
- 従業員数:非公開
要件・技術整理内容
業務効率化を目的として、AIを活用した業務補助ツールの開発を検討されている企業様からのご相談です。主な要件は、天気予報で使用される画像を入力し、地点名、気温、天気などの情報をテキストとして抽出し、その抽出結果と別のテキストデータを比較して一致・不一致を判定できるようにしたいという内容でした。
単なる画像認識だけでなく、画像内の情報を業務で扱える形式に整えたうえで、別データとの照合作業まで含めて効率化したい意向がありました。
このご相談では、画像からの情報抽出、構造化データ化、比較判定、利用可能なAI基盤の制約整理までを一体で設計する必要があるケースでした。
② ECカスタマーセンターにおける返信支援・オペレーター支援の導入検討
ご相談企業様属性
- エリア:関東
- 従業員数:1,001人〜
要件・技術整理内容
ECサイトのカスタマーセンター業務において、業務効率改善につながるシステム導入を検討されている企業様からのご相談です。
中心機能は、メールや有人チャットで受ける問い合わせに対して、問い合わせ内容を読み取り、適切な回答候補や返信文を提示するオペレーター支援です。既存のメールシステム上では定型文を活用しているものの、問い合わせ文脈に応じた返答案の提示や、担当者がそのまま下書きに使える文章生成まで対応したいという意向がありました。
対象となる問い合わせは、お届け状況、商品詳細といった典型的な顧客対応が中心で、メールと有人チャットの両方を改善対象として検討されていました。
③ 社内資料レビューを支援するLLM活用環境の検討
ご相談企業様属性
- エリア:中部
- 従業員数:1,001人〜
要件・技術整理内容
社内資料のレビュー業務への活用を検討したいというご相談です。対象とする文書は日報・週報など多岐にわたり、文書の内容確認やレビュー負荷の軽減を図りたいというご意向がありました。
利用するLLMについては、特定ベンダーのモデルを前提としつつ、社内利用しやすい形にしたいイメージをお持ちでした。つまり、モデル選定そのものよりも、社内文書を安全に扱いながら、レビュー支援として実用的に使える操作画面や運用設計が重要な論点となっていました。
この種のレビュー業務では、誤字脱字の確認だけでなく、記載漏れ、表現の不統一、必要観点の抜け、形式面の整合性など複数の観点を同時に扱う必要があります。文書レビュー支援の対象範囲を定めたうえで、利用モデル、社内向けフロント、権限制御や運用ルールまで含めて検討する必要があるケースでした。
④ 品質保証・技術伝承を支える対話型ナレッジ検索基盤の整備
ご相談企業様属性
- エリア:近畿
- 従業員数:〜100人
要件・技術整理内容
製造業の品質保証部門において、過去に発生したクレームの原因や対処方法、原因特定の手法、自社製品への理解を技術伝承の観点から体系的に残したいというご相談をいただきました。
紙資料や電子データとして蓄積されてきた情報を読み込み、対話形式で必要な知見を引き出せる仕組みを構築したいという意向がありました。いわゆる社内向けの生き字引のような役割を担うシステムを想定しており、特にクレーム対応や品質問題の再発防止に活かしたいという背景があります。
現状では、古い紙資料をスキャンしたPDFも存在し、新しい資料には表やグラフも含まれているため、単純な全文検索では必要な情報を探しにくい状況でした。
検索性の低い過去資料を活用可能な知識資産に変えつつ、メーカー系の品質保証・技術伝承業務に合う検索と対話の仕組みを整えることが重要なケースでした。
⑤ 製品問い合わせ対応を支援する対話型AIの構築
ご相談企業様属性
- エリア:関東
- 従業員数:1,001人〜
要件・技術整理内容
製品購入前の問い合わせ対応チャットボット、購入後の使い方に対応するチャットボットの開発を検討されている企業様からのご相談です。対象製品はソフトウェアで、購入検討中のユーザーへの案内から、導入後の操作方法の支援まで顧客接点を広くカバーしたいという意向がありました。
購入前の問い合わせでは、営業担当の代わりに製品横断で候補を案内したり、特定製品について何ができるかを詳しく説明したりする役割が想定されていました。主な利用シーンはWebサイト上での対応で、利用者層や質問の深さに応じた案内設計が重要になるご相談でした。
購入後の使い方支援については、過去のマニュアル類を活用しながら、製品の操作方法や利用時の疑問に対話形式で回答できる仕組みを検討されていました。単にマニュアルを検索するのではなく、質問内容に合わせて必要な情報を取り出し、ユーザーが理解しやすい形で返せるかが重要な論点でした。
AI Marketでは、上記のように、様々な企業・教育機関からのLLM活用相談を受け付けています。
生成AIツールを用いて情報収集や比較を進める企業も増えています。しかし、実際の導入では、機密情報の扱い、既存システムとの接続、RAGの必要性、運用ルール整備、社内定着のしやすさなど、サービス選定だけでは決めきれない論点が多くあります。
だからこそAI Marketでは、実際の人間である専門のAIコンサルタントが直接お客様と対話し、要件整理から企業選定までを支援し、実務に合わせた導入をサポートしています。
貴社でも、LLMやRAG、AIエージェントを活用した業務改善をご検討中の際は、ぜひご相談ください。
LLMに強い会社・サービスの選定・紹介を行います
今年度LLM相談急増中!紹介実績1,000件超え!
・ご相談からご紹介まで完全無料
・貴社に最適な会社に手間なく出会える
・AIのプロが貴社の代わりに数社選定
・お客様満足度96.8%超
・GPT、Claude、Gemini、Llama等の複数モデルに対応
完全無料・最短1日でご紹介 LLMに強いAI会社選定を依頼する
LLMの特徴
特徴は以下の通りです。
| 特徴 | 特徴がもたらすメリット・デメリット |
|---|---|
| 規模 | パラメータ数はモデルによって異なり、数億規模から数百億規模まで多様 |
| 訓練データ | 広範なドメインと言語で訓練されており、多岐にわたるタスクに対応可能 |
| 汎化能力 | 大規模なパラメータとデータにより、新しいデータやタスク(未見のデータ)に対して正確に予測や分析を行える |
| コスト | 訓練と実行は非常にコストがかかり、専門的なハードウェアと人員が必要 |
上記の特徴が、複雑で高度なタスクを実行できる理由を説明しています。
ただし、パラメータをとにかく大きくしようとする時代も限界が見え始めているという意見もあります。パタメータ数を少なくし、特定用途に特化したSLMや、量子技術を用いて計算量を抑制することで高性能なハードウェアを不要とする量子LLMも既に実用化されています。
LLMと世界モデルの違い
LLMは、膨大なテキストデータを学習し、文章生成や要約といった言語タスクに特化したAIです。いわば「言葉の世界」の専門家であり、テキストのパターンを理解して、次に来る確率が最も高い単語を予測することで機能します。
一方、世界モデルは言語に留まらず、動画などの多様なデータから物理法則や因果関係といった世界の仕組み自体を学習し、内部でシミュレーションするAIです。これにより、「この行動を取ったら、次に何が起こるか」といった未来を予測し、より現実に即した計画を立てることを目指します。
つまり、LLMがテキスト上の文脈を扱うのに対し、世界モデルは物理的な文脈や状況を理解しようとします。世界モデルは、より汎用的な知能の実現に向けた壮大なアプローチであり、その中でLLMが世界を理解・表現する要素の一つとして活用される関係にあります。
関連記事:「世界モデルとLLMの違いは?定義・ベース技術・活用シーンの比較や相互補完する関係性を徹底解説!」
LLMで何ができる?
LLMは、以下の主要な機能を提供しています。尚、モデルによって実際に提供されている機能は異なります。
| 機能 | 概要 |
|---|---|
| テキスト生成 | 物語や記事など、特定のテーマに基づいて文章を作成する能力 ニュース記事の自動生成などに利用 |
| 文章の理解と解釈 | 与えられた文章の意味を理解し、特定の質問に答えることや要約を提供する能力 |
| 機械翻訳 | 英語から日本語など、異なる言語間での文章の翻訳が可能 |
| 感情分析 | レビューなどの文章から、人々が商品やサービスに対してどのように感じているかを分析する能力 |
| マルチタスク学習 | 複数の異なるタスクを一つのモデルで学習する能力で、効率的な学習が可能 |
| 音声認識と生成 | 音声データをテキストに変換したり、逆にテキストから音声を生成したりする機能は、音声認識モデル、音声合成モデル、または音声入出力に対応したマルチモーダルモデルによって提供 |
| 画像認識 | 画像を理解してそれに関する質問に答える能力 画像と言語を組み合わせて処理するVLM(Vision-Language Model)では、画像の内容説明や視覚的な質問応答にも対応 図面読み取りや帳票OCRなどにも活用されています。 |
| ベクトル検索 | テキストや画像などのデータを埋め込みモデルで数値ベクトルに変換し、それらの類似性を計算して関連情報を検索する技術 ベクトルデータベースや検索基盤と組み合わせ、検索結果をLLMに渡すRAGで外部知識を参照するために利用されます。 |
GPTやGeminiのモデル群には、画像入力を扱えるマルチモーダルモデルが含まれています。
また、画像と言語の理解に加えて、ロボットなどが実行する行動まで扱うVLA(Vision-Language-Action)の研究・開発も進んでおり、視覚情報と自然言語による指示をもとに実世界での動作につなげる技術として活用が広がっています。
データ分析は、モデル単体ではなく、コード実行やファイル処理などのツール・実行環境と組み合わせて行われます。
AIエージェントを支えるのもLLM
LLMは、現在のAIエージェントにおいて、ユーザーの指示の解釈、推論、対話文の生成を担う中核コンポーネントです。
AIエージェントが自律的にタスクを処理し、ユーザーと自然に対話するためには、LLMによる言語理解・推論・文章生成に加え、ツールやAPIへのアクセス、検索・メモリ、エージェントループ、権限管理、実行結果の検証が不可欠であり、これらのうち、ユーザーの意図の解釈、推論、対話文の生成を担います。
具体的に、AIエージェントに対して以下のような形で貢献します。
まず、ユーザーの指示や意図の理解です。AIエージェントは、LLMが持つ優れた自然言語解釈能力を活用することで、人間からの曖昧な表現や複雑な要求内容を的確に把握します。
これにより、エージェントは「何をすべきか」を正確に認識できます。
次に、タスク遂行のための計画立案と推論です。学習データから得た広範な知識と文脈理解能力を基に、目標達成に向けたステップを論理的に組み立てたり、状況に応じた判断を下したりする能力を持ちます。
そして、自然な対話によるコミュニケーションです。タスクの進捗報告、必要な情報の問い合わせ、あるいはユーザーへの提案など、AIエージェントが人間と円滑に意思疎通を図るために、LLMの高度な文章生成能力が活用されます。
このように、AIエージェントの「頭脳」や「対話インターフェース」として機能し、その自律性と実用性を支える基盤技術と言えます。
LLMの仕組み
LLMの基本的な仕組みは「次に来るトークン(単語やその一部など)を予測すること」です。
与えられた文脈(例えば「今日は天気が」)に続く最も適切な単語(この場合「いい」など)を確率的に予測し、その積み重ねで文章を生成します。
この予測は、過去に学習した膨大なテキストデータをもとに、「次にどんな言葉がくる可能性が高いか」を判断することで行われます。
また、ポストトレーニングでは、人間のフィードバックによる強化学習(Reinforcement Learning from Human Feedback: RLHF)を取り入れる場合があります。
これは、人間が生成された文章に対して「良い」「悪い」と評価を与えることで、より人間にとって自然で有用な出力ができるようにモデルを調整していく手法です。
このプロセスにより、単なる確率的な予測だけでなく、文脈や意図を考慮した応答ができるようになります。
これらの仕組みを実現する内部では、以下のような技術で構成されています。
| LLMの仕組み | 概要 |
|---|---|
| Transformer | 文章内の単語間の関係を捉えるための特別な設計です。 単語同士がどう関連しているかを理解し、より人間に近い文章の生成を可能にします。 |
| ディープラーニング(深層学習) | 多くの層を持つニューラルネットワークを使用して、人間の脳のように情報を処理します。 多くの層があるほど、より複雑なパターンを学ぶことができます。 |
| 転移学習 | 一般的な知識を学ぶために大量のデータで訓練した後、特定のタスクに対して追加の学習を行う方法です。 これにより効率的な学習が可能になります。 |
LLMで使用されるアルゴリズム
以下は、動作を支える主要なアルゴリズムと技術です。
| アルゴリズム | 概要 |
|---|---|
| 自己注意(Self-Attention)機構 | 単語が文中の他の単語とどのように関連しているかを理解するための技術。 例えば、「彼は」が誰を指しているのかを特定します。 |
| 位置エンコーディング(Positional Encoding) | 位置符号化とも呼ばれる。単語の順序(どの単語が先に来るかなど)をコンピューターに教えるための情報。 言語は順序に敏感なので、これは重要な概念です。 |
| マルチヘッドアテンション (Multi-head Attention) | 入力を複数の異なる表現空間へ写像し、各ヘッドで並列に注意計算を行う機構。 異なる関係を捉えた結果を統合します。 |
| 正則化技術 | モデルが訓練データだけでなく、未知のデータに対してもうまく機能するように調整する技術。 |
| 最適化アルゴリズム | 訓練プロセスを速く効率的に進めるための数学的な手法。モデルが迅速に学ぶのを助けます。 |
これらの機能と仕組みは、LLMを非常に強力で多岐にわたるタスクをこなせるツールにしており、その応用範囲は今後も広がりを見せるでしょう。
LLMに強い会社・サービスの選定・紹介を行います
今年度LLM相談急増中!紹介実績1,000件超え!
・ご相談からご紹介まで完全無料
・貴社に最適な会社に手間なく出会える
・AIのプロが貴社の代わりに数社選定
・お客様満足度96.8%超
・GPT、Claude、Gemini、Llama等の複数モデルに対応
完全無料・最短1日でご紹介 LLMに強いAI会社選定を依頼する
企業での活用事例
LLMは人材育成から製品開発まで、幅広い分野で企業の効率と革新を向上させる重要なツールとなっています。企業はこれらの機能をうまく活用することで、市場での競争力を強化し、未来への成長を促進することが可能です。
LLMをビジネス活用するためのアイデアを以下で提案します。
カスタマーサポートの自動化と効率化
LLMの使用は、カスタマーサポート業務を革新的に変革しています。チャットボットは、顧客からの質問に24時間365日対応することが可能で、人的リソースの削減と応答時間の短縮が実現しています。
また、多言語対応が可能で、異なる言語を話す顧客へのサポートも効率的に提供できます。
特に、RAG(検索拡張生成:Retrieval-Augmented Generation)と呼ばれる技術を用いて、企業独自の内部データ(例えば製品に関するよくある質問と回答など)を元に回答を行えるようにすることで、企業ごとに適切なカスタマーサポートを実現することが可能になります。
さらに、エンタープライズサーチを併用することで、内部情報の有効活用とサポート業務の最適化が図れます。
オリジナルの回答を行うLLMを構築する手法として、ファインチューニングと呼ばれる手法もありますが、外部に保管したデータを参照しながら回答を生成するRAGのほうが一般的にコストメリットが優れているため、多くの企業がRAG技術を取り入れています。
そして、顧客の過去の対話履歴を活用したり、購買履歴データと組み合わせることで、より個人個人に合わせたサポートを提供することも可能です。
コンテンツ生成とマーケティングの強化
マーケティング領域でも、LLMの力を借りることで多くの進展が見られます。この技術は、コンテンツライターと連携して、効率的に高品質なコンテンツを生成することができます。
そして、顧客の嗜好や行動を解析し、ターゲットに合った広告内容を自動生成することが可能です。ソーシャルメディア戦略では、ソーシャルメディア上のトレンドを分析し、最適なタイミングでの投稿やキャンペーンの設計が可能になります。
ただし、特性として、ハルシネーションと呼ばれる「もっともらしく嘘をつく(事実に基づかない情報を生成する)」という性質があるため、コンテンツを提供する前に専門家による人力チェックなどの工程が欠かせませんので注意が必要です。
データ分析とインサイト抽出の最適化
データドリブンな決定を支援するためにも、LLMの活用が進んでいます。さらに、Chain-of-Thoughtプロンプティングを取り入れることで、分析プロセスの透明性と精度が向上する可能性があります。大量のデータを処理し、意味のある可視化を提供することで、企業はより迅速な意思決定が可能になります。
ChatGPT等を通して活用可能なデータ分析機能では、データの中から重要なパターンやトレンドを自動的に特定し、ビジネス戦略の構築に活用することができます。さらに、過去のデータから未来のトレンドを予測し、供給チェーン管理や販売予測など、さまざまな業務で使用することができます。
LLMは、それらの分析結果を適切な表現で言葉で出力することができます。
例えば、アンケート内容の分析など、多くのテキストデータからマーケットニーズや顧客の声を可視化することも可能です。
人材育成と教育プログラムのサポート
LLMは、人材育成と教育の分野にも影響を与えています。
学習者の能力や興味に応じたカスタマイズされた学習プランを生成できます。これにより、各個人のニーズに合わせた効率的な学習が可能になります。複雑なテーマや専門知識を要する分野でも、容易に理解できる教材やチュートリアルを生成できます。
さらに、ロールプレイングと組み合わせることで、学習者に対してリアルタイムでフィードバックを提供し、学習プロセスを強化します。
また、LLMを議事録用にカスタマイズすることで、研修やミーティングの内容を整理した議事録として出力することも可能になります。そして、多言語対応のモデルを使用することで、世界中のさまざまな言語を話す学習者にも、均等な教育の機会を提供できます。
また、LLMは、熟練者の経験や暗黙知を効果的に形式知化する能力を持っています。例えば、熟練者との対話を分析し、その知識を構造化された形で抽出することができます。これにより、長年の経験に基づく微妙なニュアンスや判断基準を、より明確な形で後継者に伝えることが可能になります。
関連記事:「技能伝承でのAI活用は?継承が進まない原因やAIを導入するメリット、活用事例を徹底解説!」
製品開発とイノベーションの推進
LLMは、製品開発とイノベーションの推進にも貢献しています。クリエイティブなプロセスを支援するために、新しいアイデアやコンセプトをスピーディーに提案できます。
LLMの解析と提案能力により、企業は新しいテクノロジーの探求や既存製品の改善をより迅速に行えるようになります。
例えば、SWOT分析やPEST分析など、戦略を検討するための分析を行うことなども可能です。
LLMはインターネット上の大量のデータから、市場トレンドや競合分析を迅速に実行し、製品開発の方向性を提供します。さらに、商用利用も可能なオープンソースのLLMOpsプラットフォームDifyを活用することで、プロトタイプ開発の効率向上が期待できます。
そして、技術的なドキュメントや設計ガイドラインを解釈し、エンジニアとデザイナーがプロトタイプを効率的に開発するのを助けることができるでしょう。
サプライチェーン管理とロジスティクスの改善
LLMをサプライチェーン管理とロジスティクスに適用することで、サプライヤーとの通信(例えばメール連絡など)を自動化し、情報共有の効率を上げ、協力関係を強化することもできます。
他にも、サプライチェーンに影響のある政治的な状況などを、ニュースから分析して、リスク管理を行うことなども可能になります。
法規制とコンプライアンスのモニタリング
法規制とコンプライアンスの分野でも非常に役立つツールです。例えば、世界中の異なる司法管轄で変わる法規制の最新情報を効果的に追跡するのをサポートし、企業が常にコンプライアンスを維持できるようにします。
多国籍企業の場合、異なる国の法規制を同時に追跡し、必要に応じてその地域の言語で対応することが可能になるでしょう。
また、契約書や企業内ポリシーなどの文書を分析し、法規制や業界基準との整合性を自動でチェックします。法的リスクの評価を自動化し、企業がリスクを最小限に抑えるための対策を策定できるように支援されるでしょう。
マテリアルズインフォマティクスでも活用
GPTなどのLLMは、マテリアルズインフォマティクス(材料科学)の複雑な知識構造やデータフレームを自動的に学習し、レビュー論文からの情報抽出に利用されています。
材料科学における適用は、エンティティ認識(NER)、関係抽出(RE)などの自然言語処理(NLP)技術と組み合わせて使用されます。これにより、材料名、物性、合成パラメータなどの情報を科学文献から効果的に抽出し、材料の性能を評価する際に必要な関係を抽出することが可能になります。
特許検索
特許検索におけるAI検索技術は、LLMを中心に急速に進化しています。
ユーザーが自然言語で入力した検索クエリを理解し、適切な検索キーワードや特許分類に変換します。また、特許文書の意味や文脈を理解し、類似技術や関連特許を高精度で抽出するセマンティック検索が可能です。
LLMを使えば、異なる言語間での特許検索を可能にし、グローバルな特許調査を効率化可能です。
論文検索
研究者や技術者にとって、論文調査は研究活動の根幹をなす重要な業務です。しかし、従来のキーワード検索では、情報過多な現代において必要な論文を見つけるまでに膨大な時間を要し、関連性の低い論文に埋もれてしまうことも少なくありません。
そこで近年、急速に活用が進んでいるのが、LLMを搭載したAIによる論文検索です。高度な自然言語処理能力によって、論文の内容を深く理解し、単なるキーワードの一致にとどまらず、文脈や意味、関連性を考慮した検索を実現します。
これにより、研究者は効率的に必要な情報にアクセスし、研究開発の加速化、新たな発見につなげることが期待されています。
文書管理
企業内には報告書やマニュアル、議事録など膨大な文書が存在しますが、それらが各所に散在し、必要な情報がすぐに見つからないという課題は深刻です。特に、熟練者の経験則やコツといった言語化されにくい「暗黙知」は、個人の退職などによって組織から失われるリスクを常に抱えています。
LLMを文書管理に活用することで、これらの課題解決に繋がります。この技術は、社内のあらゆるデータを横断的に検索するエンタープライズサーチを次世代のレベルへと進化させます。
従来のキーワード検索とは異なり、文章の文脈や意図を理解するため、「過去の類似トラブルの対処法は?」といった自然な問いかけで、関連文書を瞬時に探し出すことが可能です。
これにより、これまで個人の頭の中にしかなかった「暗黙知」を文書データから引き出し、誰もが活用できる形式知へと変換します。若手社員がベテランの知見に容易にアクセスできる環境は、円滑な技能伝承を促し、組織全体の技術力向上に貢献します。
企業導入に伴う課題とリスク
ビジネスでの活用において、業務改善の実現性を高めてくれますが、企業で本格的に導入する際にはいくつかの注意点とリスクが存在します。
以下に代表的な課題を挙げ、導入時に注意すべきポイントを解説します。
ハルシネーションのリスク
LLMは時に事実と異なる情報を、もっともらしい言い回しで生成する(ハルシネーション)という性質があります。これは、次の単語を確率的に予測する、という仕組みで動いているためです。
例えば、社内問い合わせチャットボットに活用しているケースで、「制度改定前の古いルールを正しい情報として回答してしまう」などが起きると、大きな混乱やクレームにつながる恐れがあります。
このため、重要な情報提供に用いる際には、人間の確認プロセスや事実確認の仕組みを設けたり、正確な情報以外の回答を生成しない仕組みを構築するなどの対策が不可欠です。
機密情報漏えいの懸念
クラウド型のLLMサービスを利用する場合、入力した社内情報が外部に送信されるリスクも考慮する必要があります。
例えば、社内文書や顧客情報を入力すると、サービスや利用する機能、契約・設定に応じて、入力・出力が不正利用監視ログやアプリケーションの状態として保持されたり、外部ツールへ送信されたりする場合があります。このようなデータ処理条件を把握せずに利用すると、情報漏えいやコンプライアンス違反につながる可能性があります。
特に機密性の高い業務では、軽量型LLM(=SLM)を含むLLMのオンプレミスサーバやローカルでの運用に加え、学習利用制限、データ保持の制御、データレジデンシー、暗号鍵管理などに対応する管理型クラウドLLMの利用、プロンプト制御・マスキングを組み合わせた情報保護の仕組みが求められます。
導入コストやROIへの不安
LLMの自前開発や高度なカスタマイズには莫大なコストがかかる可能性があり、初期投資に見合う効果が出せるかどうか、ROIに不安を抱く企業も少なくありません。
特に、業務改善やコスト削減効果がすぐに現れにくい用途では、「本当に導入すべきか」の判断が難しくなります。
LLMの導入に際しては、必ず導入後のオペレーションを設計し、導入前と比較した検証を行うようにしましょう。
社内人材・体制の問題
LLMを活用するには、AIやデータの知識を持つ専門人材が必要ですが、そうしたAI人材が社内にいない、あるいは不足しているという課題は多くの企業が抱えています。
また、現場に導入しても「使い方がわからず活用されない」「一部の担当者しか使えない」といった宝の持ち腐れ状態になるケースも見られます。組織全体での受け入れ体制や、運用ルールの整備も行うようにしましょう。
導入を成功させるためのポイント
上記のようなリスクを理解しつつ、導入を成功に導くためには、以下のポイントを押さえることが重要です。
導入目的とKPIの明確化
まず、「何のために導入するのか」「どんな成果を期待するのか」を具体的に定義することが不可欠です。
例えば、「カスタマーサポートの対応時間を30%短縮する」「社内ナレッジ検索の精度を向上させる」など、経営課題と結びついたKPIを設定することで、プロジェクトの成功確率が高まります。
小規模なPoC(実証実験)から開始
LLMに限らず、AIプロジェクト全体で共通していますが、いきなり全社導入をするのではなく、まずは限定的な範囲でPoCを実施し、効果や課題を検証しましょう。
例えば、「社内FAQの一部をチャットボット化して応答精度を測定する」といった方法が有効です。応答精度が求めている精度(業務で使えるレベル)として判断できるのであれば、対応範囲を広げていく、といった形です。
このような段階的なアプローチにより、リスクを抑えつつ、現場からのフィードバックを得て改善を進めることができます。
関連記事:「LLMの精度を評価・改善するテクニックとは?データ戦略のポイントも徹底解説!」
社内体制の整備と教育
LLMを導入する際は、運用体制の整備と人材教育が欠かせません。
利用者向けの操作トレーニングだけでなく、プロンプトの書き方や、情報管理に関するガイドライン(AIガバナンス)も整備する必要があります。
技術を「使える環境」に加えて、組織として「使いこなせる文化」を醸成することが導入成功の鍵となります。
専門パートナーの活用
社内にAI人材がいなかったりして十分な知見がない場合は、LLM導入に精通した外部のAIパートナーと連携することも有効です。
技術支援だけでなく、ユースケース設計やPoCの実施、セキュリティ設計などをトータルでサポートしてもらうことで、導入リスクを低減しつつ、より高い成果を得ることが可能です。
特に、RAGを活用したプロジェクトでは、精度の問題が発生するケースが多いため、こういったケースでは、RAG活用に長けた企業とパートナーシップを組んで進めていくことをおすすめします。
LLMに強い会社・サービスの選定・紹介を行います
今年度LLM相談急増中!紹介実績1,000件超え!
・ご相談からご紹介まで完全無料
・貴社に最適な会社に手間なく出会える
・AIのプロが貴社の代わりに数社選定
・お客様満足度96.8%超
・GPT、Claude、Gemini、Llama等の複数モデルに対応
完全無料・最短1日でご紹介 LLMに強いAI会社選定を依頼する
代表的なLLM
商用利用可能な商品を含めて、主要なモデルには以下があります。
OpenAI GPTシリーズ
GPT(Generative Pre-trained Transformer)シリーズは、OpenAIが開発する生成AIモデルファミリーです。大規模なデータで事前学習したTransformerベースのモデルとして発展し、文章生成、要約、翻訳、質問応答などの言語処理に加えて、画像や音声を含むマルチモーダル処理、推論、コーディング、ツール利用などへ対応範囲を広げてきました。
GPTシリーズは、ChatGPTの基盤モデルとして利用されたことで一般利用が急速に広がり、生成AIの普及を大きく促したモデルファミリーの一つです。
初期はテキストを中心としたLLMとして発展しましたが、GPT-4以降は画像入力への対応が進み、GPT-4oでは音声や画像などを含むマルチモーダル処理がさらに強化されました。
その後は、複雑な問題を段階的に処理する推論能力や、コーディング、外部ツールの利用、AIエージェントによる複数ステップの処理なども強化されています。
GPTシリーズでは、世代ごとに性能や処理コストの異なる複数のモデルが展開されてきました。
関連記事:「ChatGPTとは?何ができる?機能・モデル一覧を徹底解説!」
Anthropic Claudeシリーズ
Anthropic Claudeシリーズは、OpenAIの元研究幹部らが設立したAnthropicが開発する生成AIモデルファミリーです。Anthropicは「Helpful, Honest, and Harmless(有用、誠実、無害)」なAIを重視しており、明文化した原則に基づいてモデルの振る舞いを調整するConstitutional AI(憲法AI)の考え方を採用してきました。
Claudeシリーズは、長い文章の理解を重視した初期モデルから、画像理解、推論、コーディング、ツール利用、長時間のAIエージェント処理などへ対応範囲を広げてきました。
GmailやGoogle Calendar、Google Driveなどに保存された情報をClaudeから参照できるようになっています。
関連記事:「Claudeとは?機能・料金プラン・モデル一覧・ChatGPTやGeminiとの違いを徹底解説」
Google Gemini
Geminiとは、Google DeepMindが開発する生成AIモデルファミリーです。テキストだけを扱うモデルを後から拡張したものではなく、設計段階からマルチモーダルを前提としており、テキスト、画像、音声、動画、コードなど複数の種類の情報を扱えるMLLM(マルチモーダルLLM)として開発されています。
Geminiの特徴の一つが、異なる形式の情報を組み合わせて理解・処理できる点です。文章と画像を同時に読み取る、動画や音声の内容を理解する、大量の文書やコードを参照しながら回答するといった処理に対応しています。
また、世代を重ねる中で、長いコンテキストの処理、推論、コーディング、ツール利用、AIエージェントによる複数ステップの処理なども強化されてきました。
GeminiはGoogleの各種製品・サービスでも活用されているほか、Google CloudのAI開発環境やGoogle AI Studio、Gemini APIを通じて、Geminiを組み込んだアプリケーションを開発できます。
関連記事:「Geminiとは?どんな特徴があるか?」
Google Gemmaファミリー
GoogleのGemmaファミリーは、Google DeepMindが開発するオープンモデルファミリーです。Geminiの開発で培われた研究や技術を基盤としており、小型端末で動作する軽量モデルから、より高度な推論やマルチモーダル処理に対応するモデルまで、用途や実行環境に応じて選択できるモデルが展開されています。
Gemmaの特徴の一つが、クラウド環境だけでなく、PCやスマートフォン、エッジデバイスなど幅広い環境で利用できる点です。
モデルの規模だけでなく、DenseモデルやMoE(Mixture of Experts)モデルなど異なるアーキテクチャも採用されており、必要な性能や計算資源に応じてモデルを選択できます。
例えば、Gemma 4では、以下のようなモデルが展開されました。
- 高性能なDenseモデルである31B
- 推論時に一部のパラメータを有効化するMoE構成の26B A4B
- テキスト・画像・音声を単一のTransformer内で処理する12B Unified
- モバイル端末やIoT機器などでの利用を想定したE4B・E2B
26B A4Bの「A4B」は、推論時に約40億相当のパラメータを有効化する構成を表しており、Gemmaではモデル規模だけでなく計算効率も考慮した設計が採用されています。
Gemmaモデルファミリーの主な変遷
| 発表時期 | モデル/世代 | 主な特徴・位置づけ |
|---|---|---|
| 2024年2月 | Gemma | Geminiの研究・技術を基盤としたオープンモデルとして登場。比較的小さなサイズで、開発者が自身の環境で利用・調整できるモデルとして公開された。 |
| 2024年6月 | Gemma 2 | 初代Gemmaからモデル性能と計算効率を強化し、複数サイズを展開。より幅広い開発環境や用途で利用できる構成となった。 |
| 2025年3月 | Gemma 3 | テキストに加えて画像を扱うマルチモーダル処理、多言語対応、長いコンテキストの処理などを強化。オンデバイスでの利用も重視された。 |
| 2026年 | Gemma 4 | 推論、コーディング、AIエージェントによる処理、マルチモーダル理解などを強化。31BのDenseモデル、26B A4BのMoEモデル、E2B・E4Bなど、実行環境や計算資源に応じた複数の構成を展開。 |
| 2026年 | Gemma 4 12B Unified | テキスト・画像・音声を専用エンコーダーで分離せず、単一のTransformer内で処理するマルチモーダル構成を採用。 |
このようにGemmaは、モデルサイズを拡大して性能を高めるだけでなく、オンデバイス利用、MoEによる計算効率の向上、マルチモーダル処理など、異なる実行環境や用途に対応する方向へ発展してきました。
用途に特化したGemmaモデル
Gemmaファミリーでは、汎用モデルだけでなく、特定の技術課題を研究するためのモデルも公開されています。
その一つが「DataGemma」です。DataGemmaは、LLMが事実と異なる情報を生成するハルシネーションへの対応を目的として、Google Data Commonsに収録された公開統計データを利用するモデルです。
RAG(検索拡張生成)に加えて、生成中に統計情報を外部データと照合するRIG(Retrieval Interleaved Generation)などの手法を用い、数値や統計に関する回答を実際のデータに基づかせることで、回答の事実性を高めることを目的としています。
一方、VaultGemmaは、プライバシーを考慮したモデル学習を研究するために開発されたオープンモデルです。学習時に差分プライバシーを適用し、学習データに含まれる個別情報がモデルから推測されるリスクを抑えるための数学的なプライバシー保証を持たせています。
また、Gemmaファミリーでは生成方式そのものを研究するモデルも開発されています。DiffusionGemmaは、一般的な自己回帰型LLMのようにトークンを1つずつ生成する方式とは異なり、拡散モデルの考え方をテキスト生成に取り入れた実験的なオープンモデルです。
このようにGemmaファミリーは、汎用的な生成AIモデルだけでなく、オンデバイス処理、計算効率、データに基づく回答生成、プライバシー保護、新しい生成方式など、さまざまな技術課題に対応するモデルを展開している点が特徴です。
Meta Llamaシリーズ
Llamaは、Metaが開発し、モデルウェイトを公開しているLLMファミリーです。開発者がモデルを自社環境やローカル環境で実行し、用途に応じてファインチューニングやカスタマイズできる点を特徴としています。
Llamaはモデル世代ごとのCommunity Licenseに基づいて提供されており、研究だけでなく商用利用も可能です。ただし、OSI(Open Source Initiative)が承認するオープンソースライセンスではなく、一定規模を超えるサービスでの利用などには追加条件があります。
また、モデル世代や利用地域によって条件が異なる場合があるため、実際に利用する際は対象モデルのライセンスを確認する必要があります。
Llamaシリーズは、モデル規模の拡大だけでなく、長いコンテキストへの対応、多言語処理、ツール利用、スマートフォンなどでのオンデバイス推論、画像理解、MoE(Mixture of Experts)などへ対応範囲を広げてきました。
また、Llamaファミリーには用途に特化した派生モデルもあります。Llama Guardは、AIへの入力や生成された回答に安全上の問題が含まれていないかを判定するためのセーフティモデルです。
一方、Code Llamaは、コード生成やコード理解などソフトウェア開発用途に特化して開発されたモデルです。
関連記事:「Llamaの詳細な特徴、使い方を解説」
Mistral AI Mistralシリーズ・Mixtralシリーズ
Mistralシリーズ・Mixtralシリーズは、フランス発のAI企業Mistral AIが開発するAIモデルファミリーです。Mistral AIは、モデルの性能だけでなく、推論時の計算量や運用コスト、利用環境の柔軟性も重視しており、オープンウェイトで公開されるモデルと、APIなどを通じて利用できる商用モデルの両方を展開しています。
Mistral AIのモデルは、文章生成や要約、翻訳、多言語処理、コード生成、推論、ツール利用など幅広い用途に対応しています。また、テキストだけでなく画像や音声などを扱うマルチモーダルモデルも提供しており、用途に応じて異なる種類のモデルを選択できます。
モデル規模についても、高い処理能力を重視した大規模なものから、処理速度やコストを抑えた小型なものまで幅広く展開されています。
クラウド上での利用に加えて、オンプレミスやエッジLLM環境での実行を想定したモデルもあり、企業が利用目的や計算資源、データ管理の要件に応じて実行環境を選択しやすい点も特徴です。
Mixtralは、Mistral AIが採用してきたMoE(Mixture of Experts)アーキテクチャを代表するモデル系列です。MoEでは、モデルが持つすべてのパラメータを毎回利用するのではなく、入力内容に応じて一部のExpertを選択して処理します。
これにより、全体の規模を大きくしながら、推論時に必要な計算量を抑えることができます。
Mistral AIは、モデルウェイトを利用して自社環境で実行・調整できるモデルを積極的に提供している点でも特徴があります。用途に合わせたファインチューニングやカスタマイズ、自社インフラへの導入が可能なほか、Mistral AIのAPIを通じてモデルを利用することもできます。
関連記事:「Mistral AIの魅力や提供モデル、特徴を詳しく解説し、その活用方法についてご紹介」
Amazon Nova
Amazon Novaは、Amazonが開発する生成AIの基盤モデルファミリーです。Amazon Bedrockを通じて利用でき、AWS上の生成AIアプリケーションや業務システムに組み込むことができます。
Amazon Novaでは、テキストだけでなく画像、文書、動画、音声など複数形式の情報を扱うモデルが展開されています。文章生成や要約、質問応答、文書分析、画像・動画の理解、コード処理など幅広い用途に利用でき、リアルタイムの音声対話を行うspeech-to-speechモデルも提供されています。
モデルは、複雑な処理を重視するものから、高速・低コストな大量処理を想定したものまで、用途や必要な性能に応じて選択できるよう設計されています。
また、推論やツール利用、複数の手順を必要とするAIエージェントの構築にも対応しており、一部のモデルではWeb上の情報を参照するグラウンディングやコード実行などの機能も利用できます。
Amazon Novaは、企業が生成AIを本番環境で利用する際のコスト効率、カスタマイズ性、AWSサービスとの連携も重視しています。
Amazon Bedrockを通じたAPI利用に加えて、企業独自のデータや用途に合わせてモデルを調整するための仕組みも提供されており、顧客対応、文書処理、情報検索、ソフトウェア開発、AIエージェントなど幅広い業務への活用が可能です。
IBM Graniteシリーズ
Graniteは、IBMが開発する企業向けのオープンモデルファミリーです。企業での利用を前提に、モデルの性能だけでなく、透明性、ガバナンス、安全性、運用効率も重視して設計されています。
Graniteは一般的な自然言語処理だけでなく、コード生成やコード理解、文書・画像の理解、時系列予測、地理空間データの解析など、企業が扱うさまざまなデータや業務に対応するモデルを展開しています。
また、RAGやセマンティック検索に利用できるEmbeddingモデルや、AIシステムへの入力・出力に伴うリスクを評価するGuardianモデルなども提供されています。
モデルは用途や実行環境に応じて異なる規模や構成が用意されており、必要な計算資源や運用コストを抑えやすい設計も重視されています。モデルウェイトを利用した自社環境での実行や、企業独自のデータ・業務に合わせたカスタマイズにも対応しやすい点が特徴です。
特にGranite Guardianは、有害な入力や出力、RAGで参照する情報の妥当性など、生成AIを業務で利用する際のリスクを評価するための安全性モデルです。こうした用途特化モデルも含め、Graniteは生成能力だけでなく、企業がAIを継続的に管理・運用するための仕組みまで考慮したモデルファミリーとなっています。
Graniteの多くのモデルはApache 2.0ライセンスなどのオープンな条件で公開されており、ライセンス条件の範囲内で商用利用や改変、カスタマイズが可能です。
また、モデルウェイトを直接利用する方法に加えて、IBM watsonxを通じて企業向けAIアプリケーションに組み込むこともできます。
関連記事:「IBMの生成AIモデルGraniteとは?できること・特徴・料金プラン・他モデルとの比較まで徹底解説!」
DeepSeek
DeepSeekは、中国のAI企業DeepSeekが開発するLLMファミリーです。複雑な推論、コーディング、知識処理などを重視しながら、モデルの計算効率や提供コストを抑えることにも力を入れています。
DeepSeekの特徴の一つが、MoE(Mixture of Experts)アーキテクチャの活用です。
MoEでは、モデルが持つすべてのパラメータを毎回利用するのではなく、入力内容に応じて一部のExpertを選択して処理します。これにより、大規模なモデル能力を維持しながら、推論時に必要な計算量を抑えることができます。
また、DeepSeekは教師あり学習に加えて大規模な強化学習を活用し、モデルが複数の手順を踏んで問題を処理する推論能力を高める研究を進めています。数学、プログラミング、論理的な問題解決など、複雑な推論を必要とするタスクへの対応を重視している点も特徴です。
DeepSeekは、モデルウェイトや技術情報を公開するオープンな開発方針も採用しています。
主要モデルの一部はMITライセンスで公開されており、ライセンス条件の範囲内で商用利用や改変が可能です。また、大規模モデルが持つ推論能力をより小型のモデルへ移す蒸留にも取り組み、より少ない計算資源で高度な推論モデルを利用するための研究成果も公開しています。
DeepSeekのモデルは公式APIを通じて利用できるほか、公開されたモデルウェイトを利用してローカル環境や自社インフラで実行することもできます。このようにDeepSeekは、高度な推論能力、計算効率、オープンなモデル公開を組み合わせたモデル開発を特徴としています。
関連記事:「DeepSeek-R1とは?OpenAI o1に迫る高性能モデルの料金・アーキテクチャの特徴、使い方、注意点を徹底解説」
Cohere Commandシリーズ
CohereのCommandシリーズは、企業向けの生成AI活用を重視して開発されているモデルファミリーです。文章生成や要約、推論、多言語処理に加えて、外部ツールの利用やAIエージェントの構築、文書や画像の理解など、業務システムへの組み込みを想定した機能が展開されています。
特にCohereが重視しているのが、企業内の文書やデータベースなどを検索し、その情報を回答に反映するRAG(検索拡張生成)です。
RAGを重視したCommandシリーズでは、検索で取得した情報を参照しながら回答を生成できるため、社内ナレッジ検索や問い合わせ対応、文書調査などに利用できます。
Cohereは、回答を生成するCommandシリーズだけでなく、文書や検索クエリをベクトル化するEmbeddingモデルや、検索結果と質問との関連性を評価して並べ替えるRerankモデルも提供しています。
これらを組み合わせることで、検索対象から候補となる情報を取得し、関連性の高い情報を選別したうえで、その内容を根拠として回答を生成するRAGシステムを構築できます。
また、文書や画像を理解するマルチモーダルモデルも展開されており、テキストだけでなく、表やグラフ、スキャン文書などを含む業務資料の処理にも対応できます。
多言語での生成や検索、翻訳にも対応するモデルが提供されているため、複数の言語を扱う企業システムにも利用できます。
さらに、CohereのRerankモデルは、検索エンジンなどが取得した複数の情報を質問との関連性に基づいて再評価し、生成モデルへ渡す情報の優先順位を整える役割を担います。
RAGでは検索結果の質が回答内容に大きく影響するため、検索・再評価・生成までを一体的に構成できる点はCohereの特徴の一つです。
Cohereは、APIを利用した導入だけでなく、企業のセキュリティやデータ管理要件に応じた利用形態にも対応しています。このようにCommandシリーズは、単体で文章を生成するモデルとしてだけでなく、企業データの検索、関連情報の選別、回答生成、ツール利用などを組み合わせた業務向けAIシステムの中核として利用できる点を特徴としています。
Qwen
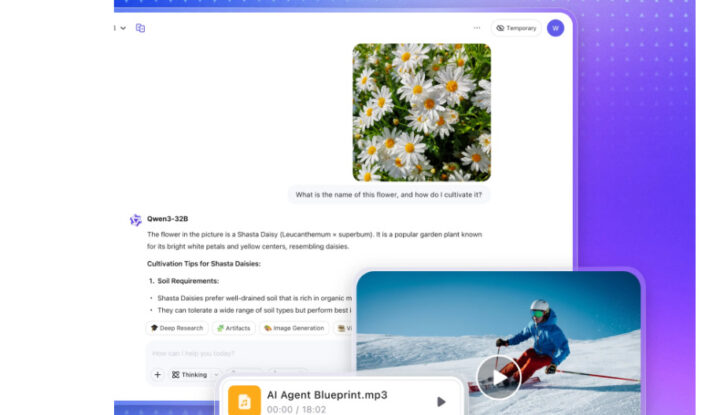
Qwen(クエン)は、Alibaba Cloudが開発する生成AIモデルファミリーです。
単一のモデルではなく、汎用的な対話モデルから、コーディング、視覚理解、音声処理、翻訳などに対応するモデルまで、多様な用途や規模のモデルが展開されています。
Qwenは、文章生成や要約、推論、コード生成、多言語処理など幅広いタスクに対応しています。また、テキストだけでなく画像、音声、動画など複数形式の情報を扱うマルチモーダルモデルも提供されており、長い文書や大量の情報をまとめて処理する用途にも対応しています。
ソフトウェア開発向けには、コード生成やコード補完、コード理解などに対応するモデルが展開されているほか、外部ツールやAPIを利用しながら複数の処理を進めるAIエージェントの構築にも活用できます。中国語や英語をはじめとする多言語での生成・理解・翻訳にも対応するモデルが提供されています。
QwenはAlibaba Cloud Model Studioなどを通じてAPIから利用できるほか、モデルウェイトが公開されているオープンモデルも多数展開されています。
公開モデルは、それぞれのライセンス条件に従って研究やファインチューニング、自社環境への導入などに利用できるため、企業独自のデータや業務に合わせたAIシステムを構築する際の基盤モデルとしても活用されています。
Alpaca 7B
Alpaca 7Bは、Stanford Universityの研究チームが2023年に公開した命令追従型の研究用言語モデルです。Metaが公開したLLaMA 7B(70億パラメータ)を基盤とし、人間から与えられた指示に沿って回答する能力を高めるためのファインチューニングが行われました。
Alpacaの開発では、52,000件の命令追従データを用いてLLaMA 7Bを追加学習しています。
大規模な基盤モデルをゼロから開発するのではなく、既存の比較的小規模なモデルを高品質な命令データでファインチューニングすることで実用的な命令追従能力を持たせられる可能性を示しました。
また、比較的少ない研究予算と計算資源で命令追従型モデルを構築できることを示した点でも注目され、その後のオープンLLMやInstruction tuningに関する研究が広がる一つの契機となりました。
Alpaca 7Bは研究目的で公開されたモデルで、商用利用を想定したものではありませんでした。現在の生成AIと比べると規模や性能は限定的ですが、既存の基盤モデルを用途に合わせて追加学習する方法の有効性を示したオープンLLM研究の歴史上重要なモデルの一つです。
Cotomi
NECは、日本語に特化した生成AIであるCotomiを開発し、それに関連したサービスをトータルで提供すると発表しました。Cotomiは、130億パラメーターを持ち、世界最大級の日本語に特化したモデルとされています。
Cotomiの最大の特長は、性能で海外製のLLMを凌駕しつつ、非常にコンパクトで超軽量化されている点です。パラメータサイズは海外製と比較して13分の1に抑えられており、標準的なサーバーでも動作可能な設計になっています。これにより、アプリのスムーズな動作や電力消費、サーバーコストの削減が可能になります。
Cotomiの性能は、日本語言語理解の評価システム「JGLUE」で確認され、知識量で81.1%、文書理解で84.3%のスコアを記録しました。これは「世界トップレベルの性能」と評され、従来、日本語のLLMがほとんど存在しなかった中で、あらゆる業界の業務に適応可能なモデルとなると期待されています。
関連記事:「日本語特化LLMおすすめ徹底解説!なぜChatGPTだけでは不十分?現状と今後の期待」
Grok
Grokは、xAIが開発する生成AIモデルファミリーです。対話や文章生成に加えて、複雑な推論、コーディング、画像理解、外部ツールの利用など、幅広いタスクに対応するモデルが展開されています。
Grokの大きな特徴の一つが、Web検索やX上の情報検索と組み合わせて利用できる点です。モデル内部の学習データだけに依存せず、必要に応じて外部情報を参照しながら回答を生成できるため、時事的な情報の確認や複数の情報源をもとにした調査にも利用できます。
また、Grokは複数の手順を必要とする推論やコーディング、外部ツールの呼び出しなどにも対応しています。テキストだけでなく画像などの情報を扱うマルチモーダルモデルも展開されており、文章と視覚情報を組み合わせた分析にも利用できます。
DeepSearchでは、WebやX上の複数の情報源を調査し、取得した情報を整理しながら回答を生成できます。このようにGrokは、単純な文章生成だけでなく、外部情報の検索や分析を伴うリサーチ用途にも対応しています。
GrokはX上のサービスとして利用できるほか、xAIのAPIを通じてアプリケーションや業務システムへ組み込むこともできます。また、GrokはxAIが展開するオンライン百科事典「Grokipedia」などのサービスにも活用されています。
BitNet b1.58
BitNet b1.58は、Microsoft Research AsiaとChinese Academy of Sciencesの共同研究チームによって開発された軽量LLMモデルです。2024年2月27日に論文『The Era of 1-bit LLMs: All Large Language Models are in 1.58 Bits』で発表されました。
主な特徴を以下に挙げます。
- 量子化技術:各パラメータを-1、0、+1の3値で表現する1.58ビット量子化技術を採用しています。
- メモリ使用量:70Bモデルの推定比較では、FP16 LLaMA系モデルの約7.16分の1です。
- 推論速度:論文の比較設定では、70BモデルでFP16 LLaMA系モデルの最大約4.1倍です。
- エネルギー効率:論文の行列乗算に関する推定比較では、FP16 LLaMA系モデルの最大約71.4分の1です。
- 性能:従来の32ビットや16ビットモデルと同等の性能を発揮しつつ、大幅な効率化を実現しています。
- スケーラビリティ:モデルサイズが大きくなるほど、効率性が向上する傾向があります。
BitNet b1.58は、LLM(大規模言語モデル)の軽量化と効率化に大きな可能性を示しており、AIの社会実装を加速させる潜在力を持っています。ただし、現時点では研究段階にあり、実用化にはさらなる開発と検証が必要です。
この技術の進展により、モバイルデバイスでのAI実装やクラウドインフラの効率化など、様々な分野でのイノベーションが期待されています。
関連記事:「1ビットLLMの衝撃!BitNet b1.58の概要と活用方法について徹底解説!」
OpenELM
Apple OpenELM(Open-source Efficient Language Model)は、2024年4月にAppleが公開したエッジデバイス向けオープンソースLLMです。iPhoneやiPad上でローカル実行可能な設計が特徴で、自然言語処理タスクを端末内で効率的に処理します。
「270M・450M・1.1B・3B」の小規模なパラメータ構成のシリーズが提供されています。しかし、性能は十分で、実際に行われたベンチマークでは同規模のモデルよりも高性能な推論結果を示しています。
関連記事:「OpenELMとは?Appleの狙い・商用利用・始め方・メリット・注意点を徹底紹介!」
Omnilingual ASR
Metaが2025年に公開した「Omnilingual ASR」は、1,600以上の言語に対応する自動音声認識モデル群です。最大70億(7B)パラメータまで拡張された自己教師あり音声エンコーダ「Omnilingual wav2vec 2.0」と、CTCデコーダまたはTransformerベースのデコーダを組み合わせています。
これにより、従来の技術では学習データ不足で実用化が困難だったロングテール言語においても、強力な言語知識で補完し、高精度な認識を実現しました。対応言語数は驚異の1,600以上に及びます。
Apache 2.0ライセンスで公開されているため、企業は商用利用や自社データでのファインチューニングが容易であり、多言語ビジネス展開においてOpenAIのWhisperと並ぶ重要な選択肢となっています。
LLMは自社開発するより既存モデルをカスタマイズする方がよい?
LLMの導入方法は、基盤モデルをゼロから開発する方法だけではありません。目的に応じて、以下のように複数の選択肢があります。
- 既存のモデルをAPIから利用する
- 社内データを参照させるRAGを構築する
- 外部ツールや業務システムと連携する
- ファインチューニングする
- オープンモデルを自社環境で運用する
多くの企業では、基盤モデルをゼロから事前学習するよりも、既存の基盤モデルとなるLLMを利用し、必要な部分だけを自社向けにカスタマイズする方が開発期間・費用・運用負荷を抑えやすいでしょう。
基盤モデルそのものを開発する場合、大規模なGPUなどの計算基盤だけでなく、学習データの収集・整備、分散学習環境、モデル評価、安全性対策、推論基盤、専門人材、継続的なモデル更新なども必要です。
そのため、自社独自の基盤モデルを開発する必要性が明確な企業を除けば、既存モデルを活用した方が投資対効果を判断しやすくなります。
ただし、カスタマイズも最初から大規模に行う必要はありません。まず既存モデルとプロンプトだけで目的を達成できるかを評価し、不足する部分に応じてコンテキスト追加、RAG、ツール連携、ファインチューニングなどを段階的に追加する方法が実践的です。
LLM導入で発生する主なコスト
LLM導入の費用は、モデル利用料だけでは判断できません。データ整備、システム統合、評価、安全対策、継続運用まで含めて総コストを確認する必要があります。
| コスト種類 | 概要 |
|---|---|
| モデル利用・計算基盤 | APIを利用する場合の入力・出力トークンやツール利用などに応じた従量課金、自社環境でモデルを稼働する場合のGPU・サーバー・クラウド推論費用 |
| データ整備 | RAGで利用する文書の収集・整理、アクセス権限の設定、Embedding生成、検索インデックスやデータベースの構築・更新にかかる費用 |
| 開発・システム統合 | プロンプト設計、RAG、ツール連携、API接続、ユーザーインターフェース、既存の業務システムとの統合などにかかる開発費 |
| モデルカスタマイズ | ファインチューニングやLoRAなどを行う場合の学習データ作成、計算資源、検証にかかる費用。オープンモデルを利用する場合はライセンス条件の確認も必要 |
| 評価 | テストデータの作成、自動評価、LLM-as-a-Judge、人間による評価、安全性検証などにかかる費用 |
| 運用・監視 | ログ管理、品質監視、障害対応、モデルやプロンプトの更新、RAGの検索品質改善など継続運用にかかる費用 |
| セキュリティ・ガバナンス | アクセス制御、機密情報の管理、プロンプトインジェクション対策、監査ログ、コンプライアンス対応などにかかる費用 |
開発・運用にはAI人材だけでなく業務担当者も必要
LLMシステムでは、モデルやシステムを構築する技術者だけでなく、正しい回答や業務上許容できる品質を判断できる業務担当者も必要です。
| 人件費の種類 | 概要 |
|---|---|
| 開発人件費 | AIエンジニアやソフトウェアエンジニアの人件費 |
| 業務担当者の工数 | 評価用データの作成、正解判定、業務ルールの整理、誤回答の確認など対象業務を理解する担当者が行う作業 |
| 運用人件費 | 本番環境での品質監視、検索データの更新、モデル変更時の検証、障害対応などを担当するスタッフの人件費 |
| 教育・定着支援 | 従業員がLLMを適切に利用するための研修、利用ルールの整備、社内への展開や業務フロー変更にかかる費用 |
関連記事:「AI人材とはどういう人材か、AI人材の種類や必要なスキル、今後の需要などを紹介」
LLM導入の費用対効果は3種類の指標で評価する
LLM導入の効果は、単純なAPI料金や人件費削減だけで判断するのではなく、事業成果、AIシステムの品質、運用効率を分けて確認すると判断しやすくなります。
| 評価軸 | 主な指標例 |
|---|---|
| 事業成果 |
|
| AIシステムの品質 |
|
| 運用効率 |
|
これらの指標を導入前後で比較することで、単なるコスト削減だけでなく、処理能力の向上やリスク低減、新たなサービス提供などを含めた投資対効果を評価できます。
また、本番運用ではモデルやプロンプト、RAGの検索結果、外部ツールなど複数の要素を継続的に監視する必要があります。LLMOpsの考え方を取り入れ、評価・デプロイ・監視・改善を継続できる体制を整えることが重要です。
関連記事:「LLMOpsとは?MLOpsとの違い・導入メリット・最適ツール、活用のコツを徹底解説」
LLMに強い会社・サービスの選定・紹介を行います
今年度LLM相談急増中!紹介実績1,000件超え!
・ご相談からご紹介まで完全無料
・貴社に最適な会社に手間なく出会える
・AIのプロが貴社の代わりに数社選定
・お客様満足度96.8%超
・GPT、Claude、Gemini、Llama等の複数モデルに対応
完全無料・最短1日でご紹介 LLMに強いAI会社選定を依頼する
LLMを自社向けにカスタマイズする手順
企業がLLMを導入する際は、最初からRAGやファインチューニングを実装するのではなく、最小限の構成で検証し、必要な機能だけを段階的に追加する方が、開発コストと失敗リスクを抑えやすくなります。
基本的な手順は以下の通りです。
- 業務課題と成功指標を定義する
- 基盤モデルを比較・評価する
- プロンプトとコンテキストを設計する
- 必要に応じてRAGを実装する
- ツールや業務システムと連携する
- 必要に応じてファインチューニングする
- 評価・監視・改善を継続する
業務課題と成功指標を定義する
最初に決めるべきなのは、利用するLLMではなく「どの業務をどの程度改善できれば導入成功と判断するか」です。
例えば問い合わせ対応であれば、正答率だけでなく、対応時間、人へのエスカレーション率、誤案内率、1件当たりの処理コストなども評価対象になります。
文章作成支援であれば、生成品質だけでなく、担当者が修正に要する時間や採用率まで確認すると、実際の業務効果を判断しやすくなります。
この段階で評価用の代表的な質問やタスク、期待する回答例、許容できない失敗例を準備しておくと、その後の比較や改善にも同じ基準を利用できます。
基盤モデルを比較・評価する
基盤モデルは、公開ベンチマークやパラメータ数だけで選ぶのではなく、自社の業務データや実際のタスクを使って比較することが重要です。
主な確認項目には以下があります。
- 自社タスクに対する回答品質・推論能力
- テキスト、画像、音声など必要なモダリティへの対応
- ツール利用や構造化出力への対応
- 応答速度と1処理当たりの利用コスト
- 必要なコンテキスト長
- セキュリティ、データ保持、利用地域などの条件
- API利用か自社ホストか
- ライセンスと商用利用条件
- モデル更新時の移行や再評価のしやすさ
すべての処理に同じ高性能なものを利用する必要はありません。
分類や情報抽出には低コストなもの、複雑な推論には高性能なもの、画像処理にはマルチモーダルモデルなど用途ごとに複数モデルを使い分ける方法もあります。
自社環境で利用できるモデルを検討する場合は、オープンソース・オープンウェイトLLMの特徴やライセンス条件も確認します。
また、画像を扱う自社ホスト型モデルとしては、LLaVAなどの研究プロジェクト由来のマルチモーダルモデルを利用する選択肢もあります。利用する場合は、モデル本体だけでなく基盤となる言語モデルやチェックポイントのライセンス条件も確認する必要があります。
プロンプトとコンテキストを設計する
基盤モデルを選んだら、まずはプロンプトと必要な情報を入力するだけで業務要件を満たせるかを検証します。
システムプロンプトで役割や禁止事項、出力形式を明確にし、Few-shotとして期待する回答例を提示するだけでも品質が改善する場合があります。
また、対象となる資料がモデルのコンテキスト内に十分収まる場合は、RAGを構築せず、必要な文書をそのまま入力する方が実装を単純化できることもあります。
この段階で要件を満たせない場合に、RAGやツール連携、ファインチューニングなどを検討します。
必要に応じてRAGを実装する
RAG(Retrieval-Augmented Generation)は、モデルを再学習せずに、社内文書やデータベースなどの外部知識を回答時に参照させる手法です。
例えば、社内規程、商品情報、マニュアル、FAQ、契約書、最新の業務データなどを検索し、質問に関連する情報だけをLLMへ渡すことで、自社固有の情報に基づいた回答を生成できます。
ただし、RAGを導入するだけで回答が自動的に正確になるわけではありません。必要な情報を検索できなければ、その後の生成モデルが高性能でも正しい回答を作ることは困難です。
実務では、以下のような設計がRAGの品質を左右します。
- 文書をどの単位で分割するか
- Embeddingモデルの選択
- ベクトル検索とキーワード検索の組み合わせ
- メタデータによる検索対象の絞り込み
- 検索結果のRerank
- ユーザーごとの閲覧権限の反映
- 回答根拠となった文書の引用表示
そのため、RAGでは最終回答の正答率だけでなく、必要な文書を検索できたかどうかも個別に評価する必要があります。
ツールや業務システムと連携する
LLMが回答するだけでなく、実際の業務処理まで行う場合は、社内システムや外部ツールとの連携が必要です。
例えば、顧客情報の検索、在庫確認、データベースへの問い合わせ、Web検索、コード実行、予約登録などをLLMから実行できるようにすることで複数の手順を必要とする業務を処理するAIエージェントを構築できます。
LangChainは、LLM、外部ツール、データソースなどを統合するためのフレームワークの一つです。
長時間実行する処理や状態を保持するワークフローではLangGraph、実行履歴の確認や評価ではLangSmithなどを組み合わせる方法もあります。
ただし、特定のフレームワークを利用すること自体が目的ではありません。
業務要件やシステム構成に応じて、各モデルベンダーが提供するエージェント開発環境や独自実装を含めて選択します。
また、AIエージェントに実際の操作権限を与える場合は、プロンプトインジェクションや意図しないツール実行への対策も必要です。重要な処理では、実行可能な操作や参照できるデータを制限し、人間による承認を挟む設計も検討します。
必要に応じてファインチューニングする
ファインチューニングは、既存モデルを追加学習し、特定のタスクや出力方法に適応させる手法です。
RAGとファインチューニングは役割が異なります。
更新頻度の高い商品情報、社内規程、マニュアルなどの「知識を参照させたい場合」はRAG、特定の回答形式、分類ルール、文章スタイル、ツール利用方法などの「モデルの振る舞いを変えたい場合」はファインチューニングが適しています。
ファインチューニングには、モデル全体を更新する方法のほか、LoRAなど一部のパラメータのみを学習する方法、モデル提供サービス側の学習機能を利用する方法などがあります。
必要なデータ量や計算資源、運用負荷は手法によって異なるため、プロンプトやRAGでは解決できない課題が明確になってから検討する方が効率的です。
学習データの品質は結果に大きく影響するため、LLMの学習データの収集・前処理・アノテーションも重要になります。
評価・監視・改善を継続する
LLMシステムは、開発時に一度評価して完了するものではありません。モデル、プロンプト、検索データ、外部ツールなどが変更されるたびに、同じ評価データを使って品質が維持されているか確認する必要があります。
評価方法には、正解との一致率や形式チェックなどの決定論的な評価、LLM-as-a-Judge(LLMによる評価)、人間による評価などがあります。
LLM-as-a-Judgeは、別のモデルを審判として使用し、回答の品質、適切性、一貫性などを評価する手法です。大量の回答を短時間で評価できる一方、使用する審判モデルや評価プロンプト、回答の提示順などによって結果が変化する可能性があります。
そのため、自動評価の指標だけに依存せず、重要な品質や安全性については人間による確認も組み合わせます。
さらにAIエージェントでは、最終回答だけでなく「どのツールを選択し、どの順序で実行し、必要な情報を正しく取得できたか」も評価対象です。
回答が正しくても、不要なシステムへアクセスしたり、誤ったツールを実行したりしていれば、本番業務では問題になります。
こうした評価結果や実際の利用ログを継続的に確認し、モデル、プロンプト、RAG、ツール連携を改善することでLLMシステムの品質と費用対効果を維持できます。
LLMについてよくある質問まとめ
- LLMの具体的なビジネスへの活用例は何がありますか?
LLMは、カスタマーサポートの自動応答、マーケティングでの個別化されたコンテンツ生成、製品レビューや感情分析など、多岐にわたるビジネスの現場で活用されています。そのため、業種や目的に応じて様々な活用法が考えられるでしょう。詳しくはこちらにジャンプ。
- LLMを活用するために必ず自社開発が必要なのでしょうか?
いいえ、必ずしも自社開発は必要ありません。既存のLLMサービスをRAGやLangChainなどの技術で自社の用途に適合させる方法が、多くの場合でコスト効率が良く現実的な選択肢となります。
- AI MarketではLLMに関してどんな相談ができますか?
AI Marketでは、LLM活用をご検討の企業様へ、課題解決に最適なパートナーをご紹介しています。
例えば、人事評価システムを提供する企業様には、1on1面談のログを音声認識・LLMで感情分析し、面談品質を可視化できるAI会社を紹介しました。
また、写真スタジオを運営する企業様には、予約システムと連携し、LINEからの問い合わせに自動応答するチャットボットを構築できる会社をご案内しました。
- LLMによって能力の差はありますか?
はい、LLMには明確な能力差があります。
この差は、主に学習データ量の質と量、モデルのアーキテクチャ、ファインチューニング(追加学習)の方法に起因します。
具体的な能力差としては、指示の正確な理解・実行(指示遵守能力)、複雑な論理的推論力、最新情報の知識、創造的な文章生成力などに現れます。ユーザーの特定の用途(プログラミング、翻訳、データ分析など)によって、最適なモデルは異なります。
AI Marketでは代表的なChatGPT、Claude、Geminiについて以下の観点で詳細な検証を行っています。
まとめ
本記事では、定義と概要、活用方法、導入コスト、サービスとツールを解説しました。LLMは、ビジネスの多岐に渡る分野での活用が期待されています。
しかし、適切なサービスやツールの選定は簡単ではありません。自社のニーズに合ったLLMの調査が必要とされます。また、導入コストの分析は、ハードウェア、ソフトウェア、人件費などを慎重に考慮する必要があります。
具体的なビジネスへの活用方法を計画し、開発と調整を検討する段階では、外部開発会社への委託も選択肢となるでしょう。LLMを実業に役立てたい企業経営者にとって、今すぐアクションを起こすことが、スピード感を持って効果的に活用するために必要です。
AI Market 運営、BizTech株式会社 代表取締役|2021年にサービス提供を開始したAI Marketのコンサルタントとしても、お客様に寄り添いながら、現場のお客様の課題ヒアリングや企業のご紹介を5年以上実施しています。これまでにLLM・RAGを始め、画像認識、データ分析等、1,000件を超える様々なAI導入相談に対応し、参加累計8,000人を超えるAIイベントを主催。AIシステム開発PM歴8年以上。AI Marketの記事では、AIに関する情報をわかりやすくお伝えしています。(JDLA GENERAL 資格保有)
▶ 監修者の実績・経歴を詳しく見る
AI Market 公式𝕏:@AIMarket_jp
Youtubeチャンネル:@aimarket_channel
TikTok:@aimarket_jp
運営会社:BizTech株式会社
掲載記事に関するご意見・ご相談はこちら:ai-market-contents@biz-t.jp
お電話で無料相談

