

RAGのデータ前処理はなぜ重要?精度低迷の原因となるリスク・実施方法5ステップを徹底解説!
最終更新日:2026年09月10日
記事監修者:森下 佳宏|BizTech株式会社 代表取締役
- RAGの回答精度は、参照するデータの品質が直接影響する
- データ前処理はハルシネーションを防ぎ、検索の精度と速度を高めるための不可欠
- 効果的なデータ前処理は、クリーニング、形式統一、分割(チャンキング)、ベクトル化、ラベリングという5つのステップで構成
- 扱う情報の機密性や社内知識の要否に応じて内製化し、大量のデータを扱う場合や一般的な文書の場合は専門の外部業者へ委託するなど状況に応じた判断
社内の膨大な情報を活用するためAIを導入したにもかかわらず、質問とズレた回答が返ってくる、AIが嘘をつくといった問題に直面しているなら、原因はAIに読み込ませるデータの質にあるかもしれません。
RAG(検索拡張生成)の性能を最大限に引き出し、本当に信頼できるAI応答を実現するために欠かせないのがデータの前処理です。
この記事では、なぜ前処理がRAGの精度を左右するのかという根本的な理由から、前処理の前提となるデータの種類、選定時に押さえておきたい注意点、具体的な5つの実践ステップ、さらには自社で行うべきか外部に委託すべきかの判断基準まで解説します。
LLM・RAG開発が得意なAI開発会社について知りたい方はこちらで特集していますので、併せてご覧ください。
\今年度、AI導入相談増加中!/

目次
なぜRAGではデータ前処理が重要なのか?
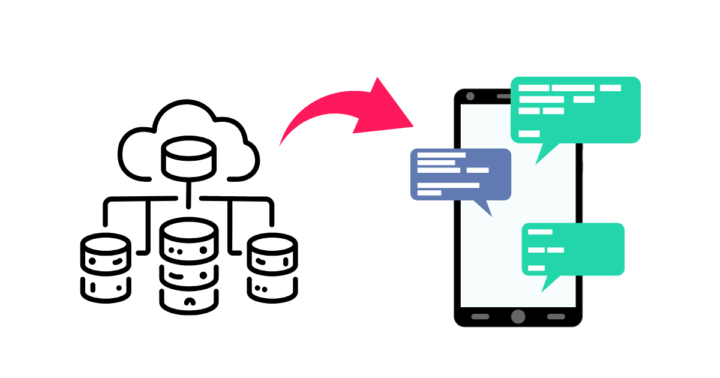
RAGでは、検索される文書の質が低いと、その後に続く生成も必然的に不正確になるため前処理が重要です。
ハルシネーション対策
RAGでは、取得された文書が曖昧・断片的な場合や必要な情報が欠落する場合に、ハルシネーション(AIが根拠のない情報をもっともらしく生成する現象)が発生する傾向にあります。
ハルシネーションの発生は、前処理によって抑制することが可能です。
例えば、文書を適切な粒度にチャンク化し、トピック単位で分類・整理することで、検索時に文脈に即した情報だけを取り出せるようになります。
さらに、ノイズや曖昧な表現の除去、冗長な記述の削減を行うことで、AIが誤認しやすい情報源そのものを排除できます。
ハルシネーションを完全に防ぐことは難しいものの、前処理によってそのリスクを最小限に抑えることは十分に可能です。
検索精度の向上
RAGは、検索で取得した文書の内容をもとに回答を生成する仕組みのため、検索結果の品質が回答の正確性を左右します。つまり、検索で適切な情報が得られないと、正確な回答はできません。
前処理を通じてセクション分けやタグ付けなど文書構造の整理を行うことで、情報の意味単位を明確にでき、検索エンジンが文書の内容を正しく把握できるようになります。また、キーワードの抽出やタイトル・カテゴリなどのメタデータを付与することで、クエリとのマッチ精度が高まり、関連性の高い文書が優先的に検索されるようになります。
適切な前処理を行うことで、本当に必要な情報へ迅速かつ正確にアクセスできるようになり、検索精度と生成精度の両方を強化できます。つまり、検索精度の向上においても、前処理は重要な施策といえます。
検索の高速化
RAGの運用においては、検索精度だけでなく検索スピードも重要です。検索が遅いと、ユーザー体験の悪化や処理待ちによる業務効率の低下を招きます。
前処理によって不要な情報やノイズを事前に除去することで、インデックスサイズの軽量化や無駄なメモリ消費やAPIコストの削減が可能です。検索のスピードアップと運用コストの削減を同時に実現でき、システム全体の効率が大きく向上します。
単なる精度改善だけでなく、スケーラビリティやコスト効率の面でもデータの前処理は重要な役割を担います。
無駄な再学習・再チューニングの防止
RAGの検索精度が低いと、取得される情報の質が不安定になり、回答の内容にもブレが生じます。その結果、プロンプトの修正やモデルの再チューニング、想定外の追加開発が必要となり、運用側に多大な負担が発生します。
特に、トラブル発生後の対応では、問題の切り分けやデバッグに時間がかかり、システム全体の信頼性にも悪影響を与える可能性があります。
こうした二次的なコストや混乱を未然に防ぐには、初期段階でのデータ前処理が有効です。文書の構造や品質をあらかじめ整えておくことで検索と生成の精度が安定し、意図しない誤答や仕様の逸脱を抑制できます。
結果として、再学習やチューニングにかかる手間を大幅に削減でき、導入後の運用効率と安定性が大きく向上します。長期運用を見据える上で、前処理はコスト最適化と品質維持の両面で重要な作業です。
検索・生成処理のコスト削減
前処理を怠ると、RAGは本来必要のない情報まで処理対象として扱うことになり、検索・生成の両フェーズで無駄な負荷が発生します。これは、計算リソースやAPI利用料といったコストに直接影響します。
例えば、検索対象に無関係な文書や重複データが多く含まれているとインデックスが肥大化し、検索アルゴリズムの効率が低下します。その結果、検索処理に余計な時間やメモリリソースが必要になります。
また、ノイズの多い文書を生成モデルが読み込むと本来回答に不要な情報までトークンとして処理されるため、APIトークン消費が増加し、運用コストが膨らみます。
これらの課題は、前処理によって大きく改善できます。不要な情報や冗長な記述、古いバージョンの文書などを除去することで、検索・生成の効率が高まり、トータルコストを最小限に抑えることが可能です。
関連記事:「RAGを導入するまでの8ステップ!プロジェクトの進め方や技術選定のポイントも徹底解説!」
セキュリティリスクの低減
前処理の段階で機密情報や個人情報を事前に排除しておくことで、RAG運用後の情報漏えいリスクを根本的に遮断できます。これは、生成モデルが不用意にセンシティブな内容を出力するリスクを防ぐ上で重要です。
また、著作権やライセンスが曖昧なコンテンツをインデックス化しないよう前処理段階で除外しておけば、後々の著作権侵害や法的トラブルの発生も防止できます。たとえば、外部から取得した文書や公開範囲が不明な資料を利用目的や出所を明確にしないまま取り込むと、企業の法務リスクを増大させかねません。
したがって、セキュリティやコンプライアンス上のリスクを未然に防ぐ上でも、前処理は重要な起点だといえます。
関連記事:「LLMとRAGで社内情報検索を効率化!検索・活用における役割やメリット、課題の解決方法」
LLM×RAGに強い会社の選定・紹介を行います
今年度RAG相談急増中!紹介実績1,000件超え!
・ご相談からご紹介まで完全無料
・貴社に最適な会社に手間なく出会える
・AIのプロが貴社の代わりに数社選定
・お客様満足度96.8%超
完全無料・最短1日でご紹介 LLM×RAGに強い会社選定を依頼する
RAGに取り込むナレッジソースの種類
RAGに取り込むナレッジソースは、構造化データと非構造化データの2種類に大別できます。それぞれのデータを目的別に組み合わせ、「検索関連度×説明力×メンテナンス容易性」の3要素を最適化することが導入効果を最大化する近道です。
以下では、それぞれの具体的なデータ例を紹介します。
構造化データ
構造化データとは、Excelの表やデータベースのように、行と列で構成され、各項目が明確に定義された整理済みのデータのことです。RAGに取り組む代表的な構造化データは、以下のとおりです。
| ソース例 | データ例 | 主な活用シーン |
|---|---|---|
| Excel・CSV ファイル | 売上実績データ、経費データ、FAQリスト、アンケート結果 | 定量情報を正確に引用したいケース |
| データベース | 顧客リスト、商品マスター、在庫管理DB、販売履歴、顧客対応ログ | リアルタイム更新が必要な業務系システム |
構造化データは、一貫したスキーマを持つため、検索ヒットの精度が高い点がメリットです。「商品コードXXXXXの現在の在庫数は?」といったピンポイントな質問に対し、データベースから正確な数値を瞬時に取得して回答する、といった用途で強みを発揮します。
また、構造化データは数値やコードがそのまま引用できるため誤写や単位ミスを防げます。事実に基づいた正確な数値や固有名詞を回答する際に不可欠なソースです。
一方、列名・カラムの意味が業務部門ごとに異なる場合は統合設計が必須です。
非構造化データ
非構造化データとは、決まった形式を持たず、文章や音声、画像など、そのままでは機械的な処理が難しいデータを指します。企業内に存在するナレッジのほとんどは非構造化データであると言われています。
RAGに取り組む代表的な非構造化データは、以下のとおりです。
| ソース例 | データ例 | 主な活用シーン |
|---|---|---|
| ドキュメントファイル | 業務マニュアル、社内規定、研究開発レポート、議事録、研修資料、提案書などのPDF, Word, PowerPoint | 手順解説や過去経緯の説明など文脈付き情報を提供 |
| コミュニケーション履歴 | メールの文面、ビジネスチャット(Teams, Slackなど)のログ コールセンターの通話録音 | 問い合わせ対応やセルフサポートチャットボット トラブルシューティング、顧客対応の状況把握 |
| Webコンテンツ | 製品カタログや公開ナレッジベース、サポート情報 | Web上から引用したいケース |
非構造化データは、以下のような曖昧で文脈依存的な質問に対して関連する文書を探し出し、内容を要約して分かりやすく回答する、といった用途で真価を発揮します。
- 「新入社員向けのPCセットアップ手順を教えて」
- 「A社との前回の打ち合わせでの決定事項は何だった?」
非構造化データは豊富な文脈情報を含むため、回答に根拠や背景を添えられ、説明力が高まります。また、企業の暗黙知を形式知化し、ナレッジとして活用する上で中心的な役割を担います。
その一方で、前処理とガバナンスを怠るとノイズになりかねません。そのため、適切な重複除去とメタデータ付与を行うことが活用のポイントです。
RAGのデータ選定で注意すべきポイント
RAGに適さないデータを取り込むと、回答精度の低下を招きます。したがって、初期段階で除外する作業が不可欠です。以下では、データの選定時で特に注意したい観点を解説します。
情報が事実に基づいているかを確認
RAGに誤情報が混入すると、生成された回答も連鎖的に誤りを含み、信頼を大きく損ないます。そのため、投入するドキュメントが客観的な事実に裏付けられているかを厳格にチェックする必要があります。
特に、以下のようなデータは排除すべきです。
- 情報が法律や制度に基づいていないデータ
- 誤記や誤訳、曖昧な記述を含むデータ
- 根拠のない推測や主観が含まれるデータ
こうしたファクトチェックを徹底することで正確性の高い回答を維持し、ユーザーの意思決定を安全にサポートできます。
データ同士の重複を避ける
RAGの検索品質は、重複データによっても低下します。同じ内容の文書が複数存在すると検索関連度スコアが分散し、適切な文書が上位に来ません。結果として生成モデルが似通ったチャンクを何度も参照し、回答の冗長化や矛盾を引き起こします。
そのため、以下のような重複データはあらかじめ除外しましょう。
- 内容が同一でファイル名や保存場所だけが違う文書
- 旧版のFAQや手順書の言い回しだけが異なる類似ドキュメント
重複を徹底的に排除し、代表チャンクに集約することで検索の的中率が高まり、RAGの回答は一貫性と信頼性を保てます。
最新データのみを選ぶ
RAGの検索精度を損なう最大のリスクは、古い情報による誤誘導です。データセットに古いデータが混在するとLLMは現行プロセスと食い違う回答を提示し、誤った業務判断につながります。
特に、社内規定や業務マニュアル、価格表などは常に最新の状態を保つことが不可欠です。
そのため、以下のような古いデータを徹底的に除外することが大切です。
- 作成・更新日が数年前で、現行ルールと齟齬があるデータ
- 廃止された製品・サービス・機能・制度の説明が残っているデータ
- 現在の社内体制・用語に合わない旧バージョンの資料
- 新しい版が存在する古い版のデータ
- 最終更新から長期間放置されているデータ
これらの基準を満たす新しい情報のみを取り込めば、常に正確な回答を維持できます。
対応策として、文書のバージョン管理ルールを定め、誰がいつ更新したかを明確にすることが重要です。そして、定期的にデータの内容を見直し、古い情報をアーカイブまたは更新するプロセスを構築します。
情報に偏りや不足がないかを確認
RAGが的確な回答を返すには、検索対象に必要な情報が偏りなくそろっている必要があります。
特定トピックが抜け落ちている場合や同じテーマの資料がバラバラに散在している場合は、LLMは断片的な根拠しか得られず回答が曖昧になります。
そのため、以下のような観点で情報の過不足をチェックしましょう。
- ユーザーが知りたい疑問を網羅し、重要トピックが抜けていないか
- 同一テーマの文書がフォルダやシステムをまたいで分断されていないか
- ある分野だけ資料が多く、別の分野は手薄といった偏りがないか
- 他部門や外部ソースと突き合わせたとき、明らかに不足している内容がないか
こうしたギャップを埋め、テーマごとに情報を集約・均質化することで、質問に対して一貫性のある根拠を提示でき、回答精度とユーザー信頼度を同時に高められます。
信頼性が高い情報を優先的に選定
RAG に不確かなソースを混入させると、生成された回答までもが信頼を失い、後工程での検証・修正コストが膨らみます。そのため、責任の所在や検証プロセスが明確な一次情報を優先し、以下のような低信頼データは初期段階で除外しましょう。
- 作成者・出所が不明で、責任の所在が曖昧な資料
- ブログ記事や SNS 投稿など、事実確認されていない二次情報
- 感想・主観・推測が多く、客観性・中立性に欠けるドキュメント
- 誤字脱字が多く、内容の正確性そのものが疑わしいデータ
- 古いルールや誤情報がベースになっているが、その旨が明記されていない資料
- ライセンスや公開権限が不明で、法的リスクを伴うコンテンツ
フィルタリングを徹底し、正式にレビュー・承認を受けた一次情報だけを採用することで、信頼性の高い回答を継続的に提供できます。
アクセス権限と機密性を保持
RAGに全社のデータを無制限に参照させると、本来その情報にアクセス権限のない従業員にまで機密情報(人事情報、未公開の財務情報など)が渡ってしまう重大なセキュリティリスクに繋がります。
既存のID管理システムと連携させ、ユーザーの役職や所属に応じたアクセス権限をデータソースに反映させることが重要です。
また、個人情報やパスワードなどの機微な情報は、あらかじめ検出し、マスキング処理(例: ***)を施すか、参照対象から除外します。
RAGを成功に導くデータ前処理5ステップ
RAGの性能を最大限に引き出すためには、前処理の各工程を目的に応じて適切に設計・実施する必要があります。ここでは、データ前処理の主なプロセスを紹介します。
関連記事:「データプレパレーションとは?AIにも重要!データ整備のためのETLツールとの違いも解説」
クリーニング
クリーニングは、重複行や意味のない改行、装飾タグなどのノイズを除去し、表記ゆれの統一や不要な文書の排除を行う工程です。例えば、重複文の削除や改行崩れの修正、「AI」「AI」などの表記記ゆれの補正などを行います。
| 前処理工程 | 具体例 |
|---|---|
| クリーニング |
|
クリーニングを実施することで、RAGが不要な情報に惑わされることなく、正しい文脈を捉えやすくなります。
形式統一
形式統一は、PDFやWord、画像などさまざまなファイル形式をAIが処理しやすいテキスト形式に変換する工程です。例えば、PDFからテキスト抽出、HTMLからプレーンテキスト化などの処理が代表的です。
| 前処理工程 | 具体例 |
|---|---|
| 形式の統一 |
|
| ファイル変換 |
|
形式の統一により、形式のばらつきによる情報の取りこぼしを防ぎ、RAG全体の一貫性と網羅性が高まります。
分割(チャンキング)
RAGが一度に扱える情報量には、コンテキストウィンドウの制限があります。そのため、長文のドキュメントを意味のある塊(チャンク)に分割するチャンキングという作業が不可欠です。
分割処理は、文書を500トークン〜1,000トークン程度の適切な粒度にスライスする工程です。
| 前処理工程 | 具体例 |
|---|---|
| 分割(チャンク化) | 500〜1,000トークン単位で文書をスライス
|
文脈を維持しつつ過不足のない情報単位に分割することで、検索ヒット率や回答の一貫性が向上します。
参考記事:「RAGにおけるチャンクとは?チャンキングの効果や分割の手法、注意点を徹底解説!」
ベクトル化(エンベディング)
チャンキングされたテキストを、AIが処理できる数値の羅列(ベクトル)に変換する必要があります。このプロセスをベクトル化またはエンベディングと呼びます。
埋め込みモデル(Embedding Model)と呼ばれる特殊なAIモデルを用いて、テキストの持つ意味や文脈を捉え、多次元のベクトル空間上の点として表現します。OpenAIのtext-embedding-3-largeなどが有名で、手軽に高い性能を得たい場合に適しています。
ベクトル化されたデータは、高速な検索を可能にするベクトルデータベースに格納され、インデックスが作成されます。意味的に近い単語や文章は、ベクトル空間上で近い位置に配置されます。
参考記事:「ベクトルデータベースとは?RAGの精度向上に欠かせない技術の仕組みや課題、活用ケースを徹底解説!」
ラベリング
ラベリングでは、各文書に対して機密区分や使用言語、更新日などの属性タグを付与します。
| 前処理工程 | 具体例 |
|---|---|
| ラベリング |
|
これらによって「最新版のみ」「日本語のみ」「公開可能な情報のみ」といった条件付きの検索や回答生成が可能になります。
RAGの前処理を自社で行うか、外部に委託するかの判断ポイント
RAGの精度や運用効率を左右するデータ前処理ですが、すべてを自社で行うべきか、それとも外部に委託すべきかは状況によって判断が分かれます。リソース・機密性・スキルセット・データの性質など、複数の観点から適切な体制を選ぶことが重要です。
以下では、RAGの前処理を自社で行うべきケースと外部委託が推奨されるケースを紹介します。
高機密・持ち出し不可なデータは自社
前処理を外部に委託する際の最大の懸念は、情報漏えいです。情報漏えいのリスクを抑えたい場合は、原則として社内対応が望まれます。
特に、以下のような機密性が高い文書を扱う場合は自社で対応しましょう。
- 社内規定、就業ルール、給与体系などの内部文書
- 顧客情報や契約書など、個人情報や取引先情報を含むデータ
- 機密保持契約上、第三者への開示が禁じられている資料
これらの文書を外注し、万が一情報漏えいが発生した場合、法的責任や信用失墜につながるリスクがあります。そのため、社内での厳重な管理体制のもとで前処理を行うことが重要です。
複雑な文脈を含むデータは自社
文書の中に社内特有の専門用語や略語、業界固有のルールや表現が多く含まれている場合は、自社対応が適しています。外部に委託すると、文脈の誤解や処理ミスが発生するリスクが高くなるためです。
具体的には、以下のようなケースが該当します。
- 製品ごとに使われる社内コードや略語が頻出する技術資料
- 説明が文脈依存で、前後の理解がなければ意味が通らない業務マニュアル
- 一般モデルでは対応できない独自構造や表記ルールを含む社内文書
このような文書を外注すると、不要な記述の誤削除やチャンク化の粒度が合わずに意味が切れる問題が生じやすく、RAGの回答精度に悪影響を与えます。
そのため、文脈の正確な理解と意味の保持が重要な文書は、社内のドメイン知識を持つ担当者が主体的に前処理を行いましょう。専門性の高い情報を正確に処理することで、検索・生成の品質を高い水準で維持できます。
大量・短納期なら外部委託
前処理対象の文書が数千〜数万件規模に及ぶ場合、社内リソースだけで対応するのは現実的ではありません。
その点、データ前処理を専門に手掛ける企業は、OCR処理や形式変換、メタデータ付与などを自動化ツールや専用ワークフローで高速かつ大量に対応できるため、短納期でも安定した品質が期待できます。
特に、導入スケジュールがタイトなプロジェクトや短期でPoCを回したいケースでは、外部の専門業者に一括処理を委託することで大幅な時間短縮が可能です。
一般的フォーマットが中心なら外部委託
汎用的な構成や一般的なフォーマットが中心の文書では、特別な社内知識を必要とせず、外部委託でも精度の高い前処理が可能です。
例えば以下のようなケースが該当します。
- 公開済みの製品仕様書やサービスガイド
- 汎用フォーマットで作成されたFAQや手順書
- 公共データや官公庁資料、業界共通用語で構成された文書
特殊なドメイン理解が不要な文書は、文脈が単純かつ構造も明確であるため、外注先でも対応しやすく、コストパフォーマンスも良好です。
LLM×RAGに強い会社の選定・紹介を行います
今年度RAG相談急増中!紹介実績1,000件超え!
・ご相談からご紹介まで完全無料
・貴社に最適な会社に手間なく出会える
・AIのプロが貴社の代わりに数社選定
・お客様満足度96.8%超
完全無料・最短1日でご紹介 LLM×RAGに強い会社選定を依頼する
RAGにおけるデータ前処理の重要性についてよくある質問まとめ
- RAGにおいて、なぜデータの前処理がそれほど重要なのでしょうか?
RAGは検索した情報を基に回答を生成するため、元のデータの品質が回答の正確性に直結するからです。質の低いデータは、主に以下の問題を引き起こします。
- ハルシネーションの誘発
- 検索精度の低下
- コストの増大
定期的な見直しが必要です。文書の更新や新規追加に対応するため、前処理ルールや対象データの再確認・再処理が欠かせません。特に最新版の反映は重要です。
- RAGのデータ前処理は、自社で行うべきですか、それとも外部に委託すべきですか?
データの性質や状況に応じて判断するのが最適です。
自社で行うべきケース:
- 顧客情報や人事情報など、機密性が高く外部に出せないデータを扱う場合
- 社内特有の専門用語や複雑な文脈が多く、社内の人間でないと正確な処理が難しい場合
外部委託を推奨するケース:
- 処理対象のデータが数千〜数万件と大量にあり、短納期で対応したい場合
- 公開情報や一般的なフォーマットの文書が中心で、専門知識が不要な場合
初期段階だけ外部に委託し、ノウハウを社内に蓄積する伴走型の支援も有効です。機密性やセキュリティ体制に配慮しつつ導入を進めましょう。
- RAGの精度を高めるためのデータ前処理には、どのようなステップがありますか?
主に以下の5つのステップで構成されます。
- クリーニング
- 形式統一
- 分割(チャンキング)
- ベクトル化(エンベディング)
- ラベリング
まとめ
RAGの運用において、精度低迷の主因となるのがデータ前処理の不足です。
特にノイズの多い文書や統一されていないフォーマットは、誤回答やハルシネーションの原因となり、無駄な再チューニングやコスト増加を招きます。
一方で、前処理を丁寧に実施することで検索精度の向上や処理の高速化、運用コストの削減など、業務全体のパフォーマンスを底上げする効果が期待できます。
しかし、最適なチャンクサイズの決定や、自社のデータ特性に合わせたベクトル化モデルの選定など、前処理には専門的な知識と判断が求められる場面も少なくありません。
もし、社内データの前処理方法に迷ったり、より高い精度を目指したいとお考えの場合は専門的な知見を持つパートナーに相談することが、成功への確実な近道となります。
AI Market 運営、BizTech株式会社 代表取締役|2021年にサービス提供を開始したAI Marketのコンサルタントとしても、お客様に寄り添いながら、現場のお客様の課題ヒアリングや企業のご紹介を5年以上実施しています。これまでにLLM・RAGを始め、画像認識、データ分析等、1,000件を超える様々なAI導入相談に対応し、参加累計8,000人を超えるAIイベントを主催。AIシステム開発PM歴8年以上。AI Marketの記事では、AIに関する情報をわかりやすくお伝えしています。(JDLA GENERAL 資格保有)
▶ 監修者の実績・経歴を詳しく見る
AI Market 公式𝕏:@AIMarket_jp
Youtubeチャンネル:@aimarket_channel
TikTok:@aimarket_jp
運営会社:BizTech株式会社
掲載記事に関するご意見・ご相談はこちら:ai-market-contents@biz-t.jp
お電話で無料相談

