

VLA(Vision-Language-Action)モデルとは?仕組み、VLMとの違い、重要モデル、メリット、課題を徹底解説!
最終更新日:2026年09月28日
記事監修者:森下 佳宏|BizTech株式会社 代表取締役
- VLA(Vision-Language-Actionモデル)は、AIが「見て(Vision)」「言葉を理解し(Language)」「行動する(Action)」を統合
- 製造業のピッキング作業やサービス業の接客・案内など、これまで自動化が難しかった非定型的な業務への応用
- Google、Tesla、NVIDIAといった大手テック企業が開発を主導
工場の生産ラインや倉庫で稼働するロボットが、あらかじめ決められた作業しかできず、少しでも状況が変わると停止してしまうといった課題に直面していないでしょうか。もし、AIと連携したロボットが人の言葉を理解し、自ら「見て・考えて・動く」ことができれば、多くの業務はより効率的になるはずです。
物理世界でロボットがタスクを遂行するためのアプローチとして、VLA(Vision-Language-Action Model)が関心を集めています。
本記事ではVLA(Vision-Language-Actionモデル)について、その仕組みから最新動向までを網羅的に解説します。従来のロボット制御やVLM(Vision-Language Model)とどう違うのか、製造、医療、自動運転といった分野でどのようなメリットをもたらすのかを具体的に紹介します。
目次
VLA(Vision-Language-Action Model)とは?
VLA(Vision-Language-Action Model)は、視覚情報(Vision)・言語情報(Language)・行動(Action)を統合的に扱い、リアルタイムで意思決定と動作を行うAIモデルです。
見る→理解する→動くを一つのモデル内で学習させることで人間のような柔軟な判断を可能にします。
VLM(Vision-Language Model)との違い
VLAと似た用語のモデルに、VLM(Vision-Language Model)があります。どちらも画像と言語を扱いますが、主な違いはロボットの動作を出力するかどうかです。
| 比較項目 | VLM | VLA |
|---|---|---|
| 主な入力 | 画像、テキスト | カメラ画像、言語による指示、ロボットの状態など |
| 主な出力 | 画像の説明、質問への回答、物体の位置など | ロボットの腕や手などを動かすための動作情報 |
| 役割 | 視覚情報を理解し、説明や推論に活用する | 視覚情報と指示を基に、作業に必要な動作を生成する |
| 利用例 | 画像に写った物体を説明する | 指示された物体をつかむための動作を生成する |
VLMもロボットの周囲を認識したり、作業手順を考えたりする用途に利用できます。
一方、VLAは画像と言語の理解をロボットの動作生成につなげます。生成された動作情報をロボットの制御システムが実行することで、物をつかむ、移動させるといった作業が可能になります。
関連記事:「VLMとは?画像認識と自然言語処理を統合処理する仕組み・メリット・デメリット・活用分野を徹底紹介!」
関連記事:「LLM・SLM・VLM・MLLM・LVM・LMM・VLAなどの重要用語の意味と違いが分かる!重要な生成AIモデル種類紹介」
参照:Google DeepMind|Gemini Robotics
従来のロボット制御の限界
従来のロボット制御は、あらかじめ設定されたルールに基づき、決められた動作を正確に繰り返すことを得意としてきました。工場の生産ラインで一定の動作を繰り返す産業用ロボットはその代表例です。
しかし、このアプローチには環境の変化に対する柔軟性が低いという課題があります。少しでも位置がずれたり、対象物の形状や背景が変化したりするとエラーが発生するという問題が残ります。
また、画像認識や自然言語処理といった個別のタスクに特化しており、情報の理解と行動をシームレスにつなぐことが難しい課題がありました。例えば、「机の上の青い本を取って」と指示されても、周囲を観察し、青い本を見つけ、取る動作はできません。
そうしたなかで、VLAはカメラやセンサーから取得した映像と言語入力を同時的に処理し、自律型ロボットやAIエージェントが現実世界で具体的な行動を取るまでを一貫して行います。
世界モデルがVLAの内的シミュレーターとして機能する一方で、VLAは世界モデルの出力を受け取ります。
つまり、VLAは世界モデルと現実との橋渡し的な役割を担い、フィジカルAIが実用化される未来シナリオを生成します。
関連記事:「自律型ロボットとは?仕組みやAI・世界モデルとの関連性、課題、応用例を徹底解説」
関連記事:「フィジカルAIとは?仕組み・メリット・活用例・注意点を徹底解説!」
ロボティクスに強いAI会社の選定・紹介を行います 今年度AI相談急増中!紹介実績1,000件超え! ・ご相談からご紹介まで完全無料 完全無料・最短1日でご紹介 ロボティクスに強いAI会社選定を依頼
・貴社に最適な会社に手間なく出会える
・AIのプロが貴社の代わりに数社選定
・お客様満足度96.8%超
VLAの仕組みをわかりやすく説明
VLAの仕組みは、視覚情報の処理・言語解釈・行動の計画と実行という3つの要素から成り立っています。以下では、それぞれの要素について解説します。
視覚情報の処理
視覚情報の処理では、カメラやセンサーから得られる画像データ・動画データを解析し、物体の情報を正確に認識するところから始まります。このとき活用されるのがLLM(大規模言語モデル)や、画像と言語を同時に扱う、マルチモーダル基盤モデルです。
マルチモーダル基盤モデルを用いて視覚エンコーダが画像中の特徴量を抽出し、物体検出やセマンティックセグメンテーションによって対象物を識別します。その結果は、言語処理モジュールや行動計画モジュールと共有され、次にどのような動作を行うべきかの判断材料となります。
VLAではこれらを統合的に扱うことで、環境変化に強く、柔軟に対応できる点が特徴です。これにより、未知の環境に対しても物理的に物体の位置関係を把握しやすくなります。
関連記事:「LLMとは?AIエージェントとの連携・導入方法とコスト・代表的モデル・活用相談事例を徹底解説!」
関連記事:「マルチモーダルAIとは?代表モデル・活用メリット・ビジネス活用事例や相談事例を徹底解説!」
言語解釈
VLAにおける言語解釈は、プロンプトの指示を正確に理解し、次の行動計画につなげる重要なプロセスです。
この際、中心的な役割を果たすのが多くのLLMが採用しているTransformerアーキテクチャです。自己注意機構(Self-Attention)を用いて指示文全体の文脈を把握し、どの語が重要かを判断できます。
Transformerはマルチモーダル基盤モデルで解析された視覚情報を照合することで、どの物体が対象かを特定し、動作計画モジュールへと渡します。
従来のルールベースの自然言語処理では、言い回しが変わるだけで認識精度が低下する課題がありましたが、Transformerでは曖昧な表現に対応した解釈が可能です。ユーザーは日常的な言葉でもロボットに指示を出すことができ、直感的なヒューマン・マシンインタラクションが実現します。
動作の生成と実行
VLAは、カメラ画像や言語による指示、ロボットの状態などを基に、作業に必要な動作情報を生成します。
例えば「机の上の赤いコップを取って」と指示された場合、画像から対象物とロボットの位置関係を捉え、アームや手先をどう動かすかを出力します。
動作の表現方法はモデルによって異なります。
RT-2は、手先の位置・向きの変化やグリッパーの状態を、文章を構成する単語のようなトークンで表現します。
一方、NVIDIA Isaac GR00Tは、ロボットの動きにつながる連続的な動作情報を生成します。VLAがすべて同じ方式で動作を出力するわけではありません。
生成された情報はロボットの制御システムに渡され、関節やモーターの動作へ変換されます。コップに手を近づけ、つかんで持ち上げる間も、カメラやセンサーから新しい情報を取得し、位置のずれなどに応じて次の動作を調整します。
このように、周囲の状況を確認しながら動作を繰り返す仕組みを閉ループ制御と呼びます。
また、作業全体の手順を考える機能と、個々の動作を生成する機能を分ける構成もあります。
Google DeepMindのGemini Roboticsでは、VLMであるGemini Robotics ER 2が複数段階の作業を計画し、VLAであるGemini Robotics 2と連携してロボットの動作につなげています。
参照:Google DeepMind|RT-2: New model translates vision and language into action
参照:NVIDIA|Develop Humanoid Robot Policies End-to-End with NVIDIA Isaac GR00T
参照:Google|Gemini Robotics 2 が実現するロボットの全身知能
VLAの活用分野と実用化によるメリット
VLAはさまざまな産業や日常生活での活用が期待されています。ここでは、具体的な分野における応用例と実用化によるメリットを解説します。
製造業
製造業では、主にピッキング作業や組み立て工程の自動化において効果を発揮します。VLAを搭載したロボットは、カメラで作業エリアを認識し、生産計画をもとに部品を探して最適な動作経路を計算した上でピッキングできます。
また、人間の作業者が行っていた確認作業や仕分けも自動化できるため、現場において以下のメリットも享受できます。
- タクトタイム短縮
- ライン停止リスクの低減
- 作業ミス削減
- 人手不足対策
- 労災リスクの低減
- 品質の安定化
特に多品種少量生産やカスタム製品の組み立てでは、VLAによる適応的な制御が大きな価値を生み、生産効率と品質の両立を可能にします。
関連記事:「ビンピッキングをAIで精度改善!自動化が難しい原因・注意点・導入実例を徹底解説」
医療・介護
医療や介護の現場では、VLAの導入によって作業負担の軽減と安全性の向上が期待できます。例えば、病院では医療ロボットによる自律的な運搬が可能です。
介護施設では、入居者の移動補助や転倒検知をロボットが行うことでスタッフがより付加価値の高いケアに専念できる環境を整えられます。
これによって、医療現場におけるミスの減少やスタッフの肉体的・精神的負担の軽減につながります。この現象は連鎖して、患者や入居者の満足度向上にもつながります。
自動運転
自動運転の分野では、VLAが車両の周囲環境を認識し、運転ルートを立てるための中核技術として活用されることが期待されます。交通標識や信号、歩行者の動きといった不規則な情報を統合的に理解し、人間らしい運転判断が可能になります。
また、音声による目的地指示や状況説明にも対応できるため、ドライバーとの自然なコミュニケーションが可能です。
関連記事:「完全自動運転に必要なAI技術は?画像認識から世界モデルの仕組み・課題を徹底解説!」
サービス業
サービス業においてVLAは、接客や案内業務、清掃といった多様なタスクを自動化・効率化するための重要な技術となります。
| 分類 | タスク |
|---|---|
| ホテル業 |
|
| 飲食業 |
|
| 小売業 |
|
| 物流・宅配サービス |
|
| 商業施設・空港 |
|
例えばホテルや商業施設では、ロボットが利用客の質問に応じて館内案内を行ったり、荷物を部屋まで運んだりすることが可能です。
VLAで視覚と音声を同時に処理できるため、混雑状況や顧客の動きを認識し、最適なタイミングで行動を取ることができます。これにより、利用者の待ち時間短縮やサービス品質の向上が期待できます。
スマートホーム・パーソナルアシスタント
スマートホーム分野において、VLAは家の状況を把握し、異常検知に基づいて自律的に行動するパーソナルアシスタントとして機能します。
高齢者や子どもの見守りではカメラやセンサーから取得した情報を解析し、転倒や異常行動を検知することが可能です。転倒後に本人の応答がない場合は照明を点灯させたり、扉を解錠するといった高度な対応も実現できます。
ロボティクスに強いAI会社の選定・紹介を行います 今年度AI相談急増中!紹介実績1,000件超え! ・ご相談からご紹介まで完全無料 完全無料・最短1日でご紹介 ロボティクスに強いAI会社選定を依頼
・貴社に最適な会社に手間なく出会える
・AIのプロが貴社の代わりに数社選定
・お客様満足度96.8%超
重要なVLAモデル
VLAの研究開発は、世界中の大手テック企業や研究機関で進められており、すでに複数のモデルが登場しています。
Gemini Robotics(Google DeepMind)
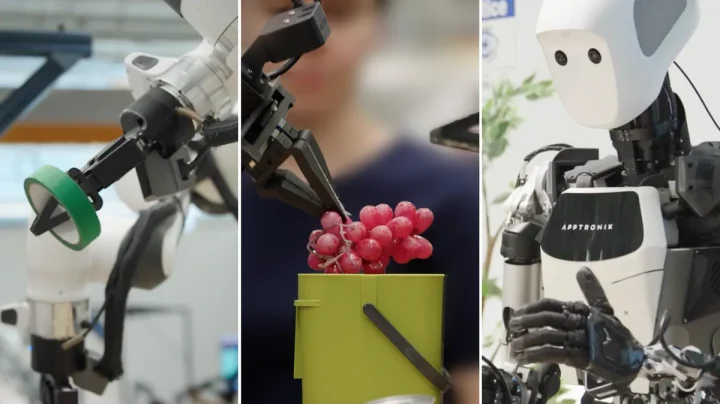
Google DeepMindは、ロボットの動作を生成するVLAモデル「Gemini Robotics」と、物理環境での推論や計画を担う「Gemini Robotics-ER」を開発しています。上の画像はGemini Robotics 1.5の発表時のものです。
現在はGemini Robotics 2、Gemini Robotics ER 2、端末上での動作を想定したGemini Robotics On-Device 2が発表されています。Gemini Robotics 2では、ロボットの手先から全身までの制御や、異なる形態のロボットへの適応が示されています。
関連記事:「Gemini Roboticsの解説記事」
参照:Google DeepMind|Gemini Robotics
RT-2(Google DeepMind)
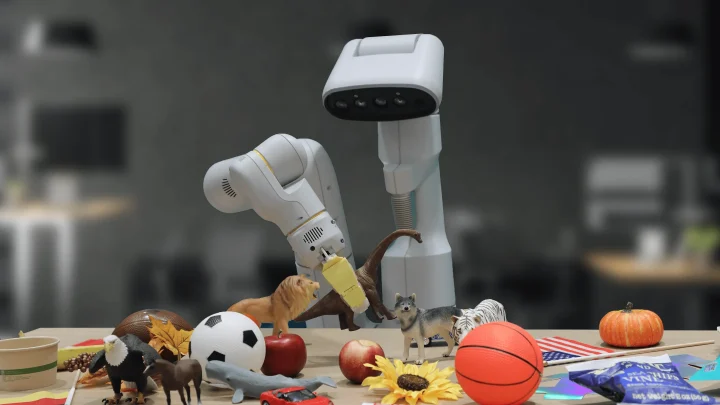
RT-2(Robotics Transformer 2)は、Google DeepMindが2023年に発表したVLAモデルです。Web上の画像・言語データで学習した視覚言語モデルに、ロボットの動作データを組み合わせています。言葉とカメラ画像を入力し、ロボットの動作を表すトークンを出力する仕組みです。
特徴は、ロボットの実演データだけでは学びにくい知識を、行動に活かせることです。Google DeepMindは、机から落ちそうな袋を取る指示や、釘を打つ道具の代わりに石を選ぶ指示などを用いて、物体の意味や状況を踏まえた動作を検証しました。
学習時に見ていない状況での実験では、RT-1の成功率32%に対し、RT-2は62%でした。Webで学んだ知識をロボットの動作へ結びつけた点で、RT-2はVLAの発展を理解するうえで重要な研究成果です。
尚、Google DeepMindが現在発表しているロボティクスモデルは、Geminiを基盤とする「Gemini Robotics」シリーズです。RT-2の開発終了は公表されていませんが、Googleの主力はGemini Roboticsシリーズになると想定されます。
参照:Google DeepMind|RT-2: New model translates vision and language into action
参照:Google|Gemini Robotics 2 が実現するロボットの全身知能
Teslaオプティマス(Tesla)
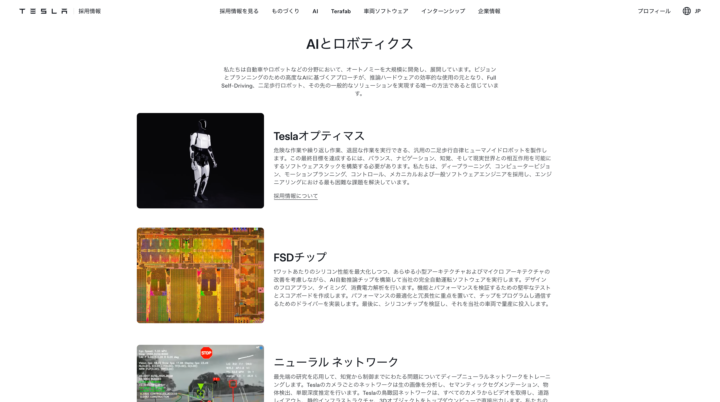
Teslaオプティマスは、Teslaが開発を進める人型ロボットで、同社の自動運転AI技術を応用して人間に近い動作を実現することを目指しています。人間と同じ二足歩行の形態を持ち、重量物の運搬や組立作業といった現場業務で活用可能です。
特に注目されるのは、Teslaが持つセンサーデータや走行データを活かして、現実世界での認識と行動を高度に統合している点です。世界中で走行する数百万台のTesla車両から収集した膨大な映像データをAIのトレーニングに活用しています。
これにより、オプティマスは周囲の状況を理解して柔軟に対応することが可能になります。
デモ動画では、洗濯物をたたむ、卵を割らずに持つといった繊細な作業やヨガのポーズで片足立ちのバランスを取るなど、AI制御による自律動作の能力が飛躍的に向上していることが示されています。
将来的には人手不足が深刻な分野で活躍することが期待されており、人間と共存する汎用ロボットとしてのポジションを確立しつつあります。
NVIDIA Isaac GR00T
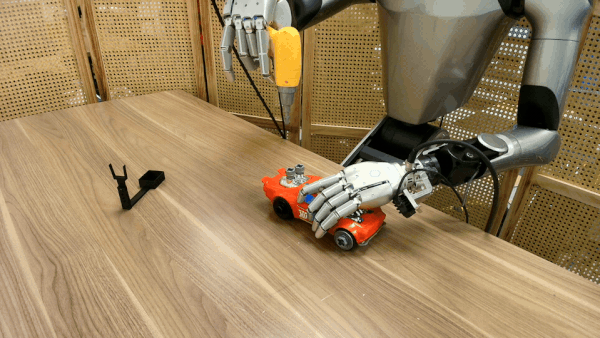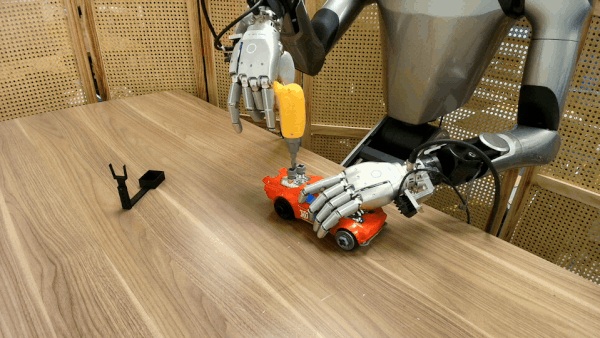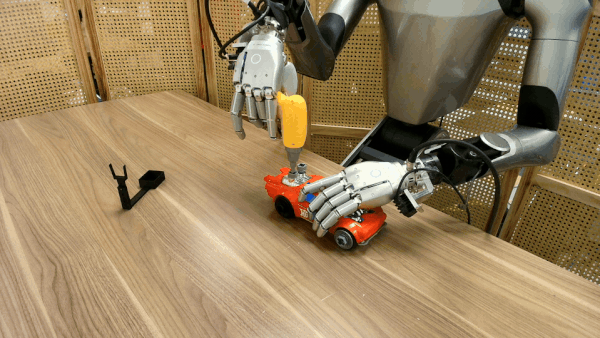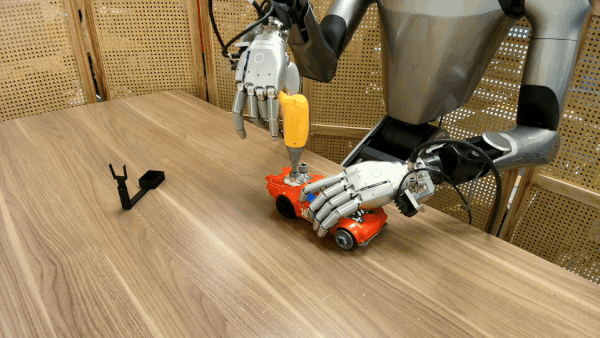
NVIDIA Isaac GR00Tは、人型ロボットの動作を開発するための基盤モデルと開発環境です。2025年に発表されたGR00T N1に続き、2026年にはGR00T N1.7が公開されました。
GR00T N1.7は、カメラ画像、言語による指示、ロボットの状態を入力し、作業に必要な動作を生成するVLAモデルです。事前学習済みのモデルを、実際のロボットや作業に合わせて追加学習できます。モデルと重みが公開されているため、開発者が自社の機体で動作を検証できる点も特徴です。
NVIDIAはモデルに加え、実機やシミュレーションでの動作データ収集、追加学習、動作評価、実機への導入までをつなぐ開発環境も提供しています。
参照:NVIDIA|エージェント型 AI、フィジカル AI、ヘルスケア AI の次世代を支えるオープン モデル ファミリーを拡大
参照:NVIDIA|Develop Humanoid Robot Policies End-to-End with NVIDIA Isaac GR00T
Helix(Figure AI)
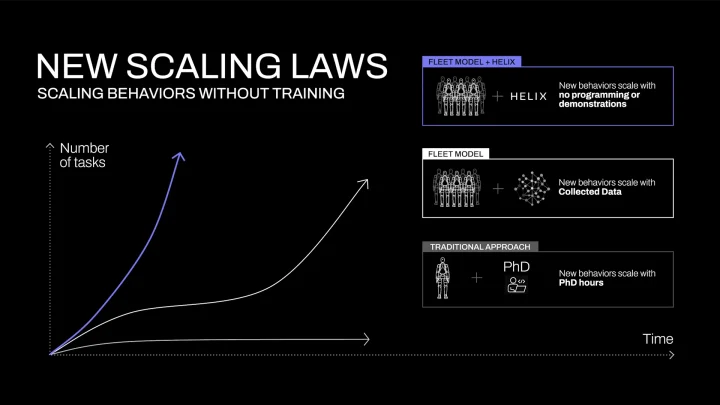
Helixは、Figure AIが開発する人型ロボット向けのAIモデルです。Helix 02では、歩行と物体操作を組み合わせた全身の動作に対応しました。Figureは、Helix 02を搭載したFigure 03がBMWの工場で部品を扱う様子も公開しています。
2026年9月に発表されたHelix 2.5では、事前にデータを収集していない30軒の住宅で、部屋の片付け、タオルを畳む作業、ベッドを整える作業を検証しました。環境が変わっても作業を進められるかという、汎化性能の向上に取り組んでいます。
Helixの注目点は、家庭での未知の環境への対応と、BMWの工場での作業検証を並行して進めていることです。研究上の汎化性能が、異なる現場でどこまで実用的な動きにつながるかを追えるモデルといえます。
参照:Figure|Helix 2.5: Zero-Shot 30-Home Generalization
参照:Figure|F.03 Arrives at BMW
πシリーズ(Physical Intelligence)
Physical Intelligenceは、2024年に設立されたロボティクス分野の企業です。Google DeepMind出身のKarol Hausman氏や、大学でロボット研究に携わる研究者らが設立に参加しました。
Physical Intelligenceでは、画像と言語による指示からロボットの動作を生成するVLAモデル「πシリーズ」を開発しています。最初のπ0に続き、未知の環境への対応を強化したπ0.5、実機で得た経験を学習に活かすπ*0.6、複数の作業やロボットへの汎化を進めたπ0.7を発表しました。
πシリーズの特徴の一つが、事前学習したモデルを少量の実演データで特定のロボットや作業に適応させるFew-shot(フューショット)学習です。Physical Intelligenceはπ0について、同社の実験では1~20時間分のデータでさまざまな作業向けに追加学習できたと報告しています。
また、π0.5以降は、学習時に見ていない環境や物体への対応も重視しています。こうしたZero-shot(ゼロショット)の評価は、個々の現場に合わせてデータを集め直す負担を減らせるかを見るうえで重要です。
π0のコードとモデルが公開されている点も、πシリーズの魅力です。
研究者や開発者が自分のロボットで追加学習を試せるため、モデルの性能を論文上の結果だけでなく、異なる機体や作業環境で検証できます。汎用ロボットの実現に向けて、今後も動向を追いたいモデルです。
参照:Physical Intelligence|Open Sourcing π0
参照:Physical Intelligence|π0.5: a VLA with Open-World Generalization
参照:Physical Intelligence|π0.7: a Steerable Model with Emergent Capabilities
OpenVLA(スタンフォード大学など)
OpenVLAは、スタンフォード大学やカリフォルニア大学バークレー校などの研究者が開発した、オープンソースのモデルです。カメラ画像と言語による指示を受け取り、ロボットが実行する動作を生成します。
約97万件のロボット動作データを用いて事前学習されており、異なるロボットや作業に合わせた追加学習が可能です。モデルの重みと学習用コードが公開されているため、研究者や開発者が自分の環境で性能を検証できます。
OpenVLAは、VLAの研究成果を公開し、ほかの開発者が改良や比較を進められるようにした代表的なモデルです。企業が発表するロボットの実演だけでなく、実際に試して発展させる動きを知るうえでも注目のモデルです。
参照:OpenVLA|OpenVLA: An Open-Source Vision-Language-Action Model
VLAの実装に向けた技術的課題
VLAを実際の現場に導入するには、いくつかの技術的課題が残されています。
学習データの不足
VLAの性能を引き出すためには視覚・言語・行動の3要素を網羅したデータが必要です。しかし、汎用的に応用できるマルチモーダルデータセットはまだ十分に整備されていません。
特に行動データは収集コストが高く、ロボットによる実環境での試行やシミュレーションを通じて集める必要があるためデータが不足しがちです。データの不足はモデルの学習バイアスや汎化性能の低下を招き、未知の状況に適応できない原因となります。
この課題への対処方法として、シミュレーション環境での大量データ生成や模倣学習・自己教師あり学習を組み合わせる手法が最適です。また、企業固有の作業環境に合わせたファインチューニングによって、不足分を補完可能です。
安全性
ロボットが誤った行動を取れば人や設備に損害を与えるリスクがあるため、安全に動作するシステム構築が不可欠です。例えば、人間が近くにいる状況では速度を自動的に制御し、衝突や転倒を防げるようにしなければいけません。
現場で安全に運用するためには、複数のレイヤーでリスクを低減する仕組みが必要です。有効とされる対策は、以下の通りです。
| 手法 | 詳細 |
|---|---|
| リアルタイム監視 | センサーやカメラで周囲の状況をモニタリングし、緊急停止や速度制限を即座に実行 |
| シミュレーションによる事前検証 | NVIDIA OmniverseやIsaac Simのようなシミュレーション環境でテストし、衝突や誤作動のリスクを事前に排除 |
| 信頼性評価と出力検証 | モデルが生成した行動計画に対して確率的信頼度を評価し、しきい値を下回る場合は人間が確認する |
| 人間との協働設計(HRI) | 作業員が近くにいる場合は協調モードに切り替え、速度や力を制御するコボット的挙動を採用する |
| サイバーセキュリティ対策 | 通信の暗号化、アクセス認証、多層防御を徹底する |
これらの対策を組み合わせることで、安全性と信頼性を担保しつつ、現実世界での稼働を拡大できます。特に産業現場や公共空間では、人とロボットの共存を前提とした多層的な安全設計が不可欠です。
汎化性能
VLAにおける汎化性能とは、学習したタスクや環境を超えて、新しい状況にも対応できる能力を指します。この汎化性能が低いと、現場ごとに再学習や再設定が必要となり、導入コストが増加してしまいます。
この課題に対しては、シミュレーションと実機データを組み合わせた学習や、少量のデータから効率的に学習するFew-shot・Zero-shot学習の活用が効果的です。
ロボティクスに強いAI会社の選定・紹介を行います 今年度AI相談急増中!紹介実績1,000件超え! ・ご相談からご紹介まで完全無料 完全無料・最短1日でご紹介 ロボティクスに強いAI会社選定を依頼
・貴社に最適な会社に手間なく出会える
・AIのプロが貴社の代わりに数社選定
・お客様満足度96.8%超
VLAについてよくある質問まとめ
- VLA(Vision-Language-Action Model)とは?
VLAは、視覚情報(Vision)と言語情報(Language)を同時に処理し、それに基づいて具体的な行動(Action)を計画・実行するマルチモーダルAIモデルです。
- VLAが従来のロボット制御と比べて優れている点は?
従来のロボットはルールに基づいて動くため、環境が変化すると再設定が必要でした。一方でVLAは視覚認識と言語理解を統合し、状況に応じて動作を調整できるため、未知の環境や新しいタスクにも対応可能です。
- VLAとVLM(Vision-Language Model)の違いは?
VLMは画像や映像を理解して言語で説明する能力を持ちますが、実際に行動することはできません。一方、VLAはVLMの能力を基盤に、得られた情報から行動計画を立てて実行します。
つまり、VLMが認識・説明に特化しているのに対し、VLAはタスクを完遂する実行能力まで備えています。
- VLAはどのような分野で活用されていますか?
VLAは幅広い分野での実用化が期待されています。
- 製造業:部品ピッキングや組立作業の自動化
- 医療・介護:薬剤運搬や患者の見守り、移動支援
- 自動運転:交通環境を理解し、安全な走行計画を立案
- サービス業:接客、配膳、清掃など顧客体験を向上
- スマートホーム:転倒検知や家庭内アシスタントとして安全性と快適性を向上
まとめ
VLAは、視覚情報と言語による指示を基にロボットの動作を生成するモデルです。RT-2はその発展を示した代表的な研究の一つで、現在はGemini Robotics、NVIDIA Isaac GR00T、OpenVLAなど、異なる設計や公開方針のモデルが登場しています。
一方で、VLAを自社の環境に導入し、その価値を最大限に引き出すためには専門的な知見が不可欠です。どのAIモデルが自社の課題に適しているのか、学習に必要なデータはどのように準備すればよいか、そして何より現場で安全に運用するための設計はどうすべきかなど検討すべき項目は多岐にわたります。
もし、導入に関する具体的なステップや、自社のユースケースにおける実現可能性についてさらに詳しく知りたい場合はAI導入の専門家へ相談することをおすすめします。
AI Market 運営、BizTech株式会社 代表取締役|2021年にサービス提供を開始したAI Marketのコンサルタントとしても、お客様に寄り添いながら、現場のお客様の課題ヒアリングや企業のご紹介を5年以上実施しています。これまでにLLM・RAGを始め、画像認識、データ分析等、1,000件を超える様々なAI導入相談に対応し、参加累計8,000人を超えるAIイベントを主催。AIシステム開発PM歴8年以上。AI Marketの記事では、AIに関する情報をわかりやすくお伝えしています。(JDLA GENERAL 資格保有)
▶ 監修者の実績・経歴を詳しく見る
AI Market 公式𝕏:@AIMarket_jp
Youtubeチャンネル:@aimarket_channel
TikTok:@aimarket_jp
運営会社:BizTech株式会社
掲載記事に関するご意見・ご相談はこちら:ai-market-contents@biz-t.jp
お電話で無料相談

