

LLMの性能評価方法とは?人手・自動評価の違い、指標・ベンチマーク・ツールを徹底解説!
最終更新日:2026年09月14日
記事監修者:森下 佳宏|BizTech株式会社 代表取締役
- LLMの評価は、結果を数値で表す定量と問題点や改善理由を整理する定性に分けられ、実施方法には人手評価と自動評価がある
- モデルの技術的な性能だけでなく、コスト削減・生産性向上・ユーザー満足度など、自社の業務成果につながるKPIも確認することが重要
- 用途に合った指標・ベンチマーク・ツールを選び、人手評価と自動評価を組み合わせて、開発から運用まで継続的に品質を検証・改善する
LLMを業務に導入する際は、公開ベンチマークのスコアだけでなく、自社の業務で必要な品質を満たし、コスト削減や生産性向上につながるかを確認することが重要です。
評価には、数値で比較する「定量評価」と、問題点や改善理由を具体的に整理する「定性評価」があります。また、方法として「人手評価」と「自動評価」があり、LLMを採点者として使うLLM-as-a-Judgeも活用できます。
これらを目的に応じて組み合わせることで、性能の比較から実運用での課題の発見まで進められます。
この記事では、LLMの評価方法、ビジネス成果を測るKPI、技術的な評価指標・ベンチマーク、評価ツールの使い分けを解説します。さらに、カスタマーサポートやRAGなどの活用シーンに応じた指標の選び方と、継続的な改善に向けた注意点を紹介します。
関連記事:「LLMとは?活用相談事例・AIエージェントとの連携・導入方法とコスト・代表的モデルを徹底解説!」
目次
LLMの評価方法は?
LLMの評価は、「人手・自動」と「定量・定性」という2つの軸で整理できます。
| 分類の軸 | 種類 | 評価方法 | 具体例 |
|---|---|---|---|
| 誰が・何で評価するか | 人手評価 | 人間が基準に沿って出力や動作を確認する | 専門家による正確性の確認、利用者による使いやすさの採点 |
| 自動評価 | プログラムや評価モデルで採点・判定する | 正答率やROUGEの計算、LLM-as-a-Judgeによる採点・講評 | |
| 結果をどう表すか | 定量評価 | 品質や成果を数値で測定・比較する | 正答率、応答時間、タスク達成率、人手による5段階評価 |
| 定性評価 | 数値だけでは伝わらない特徴や問題点を文章などで整理する | 回答の不自然な箇所の指摘、誤回答の原因分析、改善点の記録 |
これらは相互に排他的な分類ではなく、組み合わせて使うものです。例えば、人間が回答を5段階で採点し、その理由を文章で記録すれば、人手評価の中で定量評価と定性評価の両方を行えます。
LLMの定量評価とは?
定量評価は、LLMの回答品質や処理性能、業務上の成果を数値で測定・比較する方法です。同じ条件で評価することで、モデル間の違いや、プロンプト・システムの変更による改善効果を確認できます。
プログラムで計算する指標だけでなく、人間が基準に沿って付ける点数も含まれます。代表的な例は以下の通りです。
- 回答品質:正答率、情報抽出のPrecision・Recall・F1、要約のROUGEなど
- 処理性能:応答時間、一定時間内に処理できる件数やトークン数
- 業務成果:タスク達成率、作業時間の削減率、1件あたりの処理コスト
- 人手による採点:正確性、読みやすさ、業務への適合性などの5段階評価
ベンチマークを使ったモデル比較
ベンチマークは、決められた問題やデータセット、評価手順を用いてモデルの能力を比較するためのものです。定量評価の一つの方法として、モデル選定や性能改善の検証に利用されます。
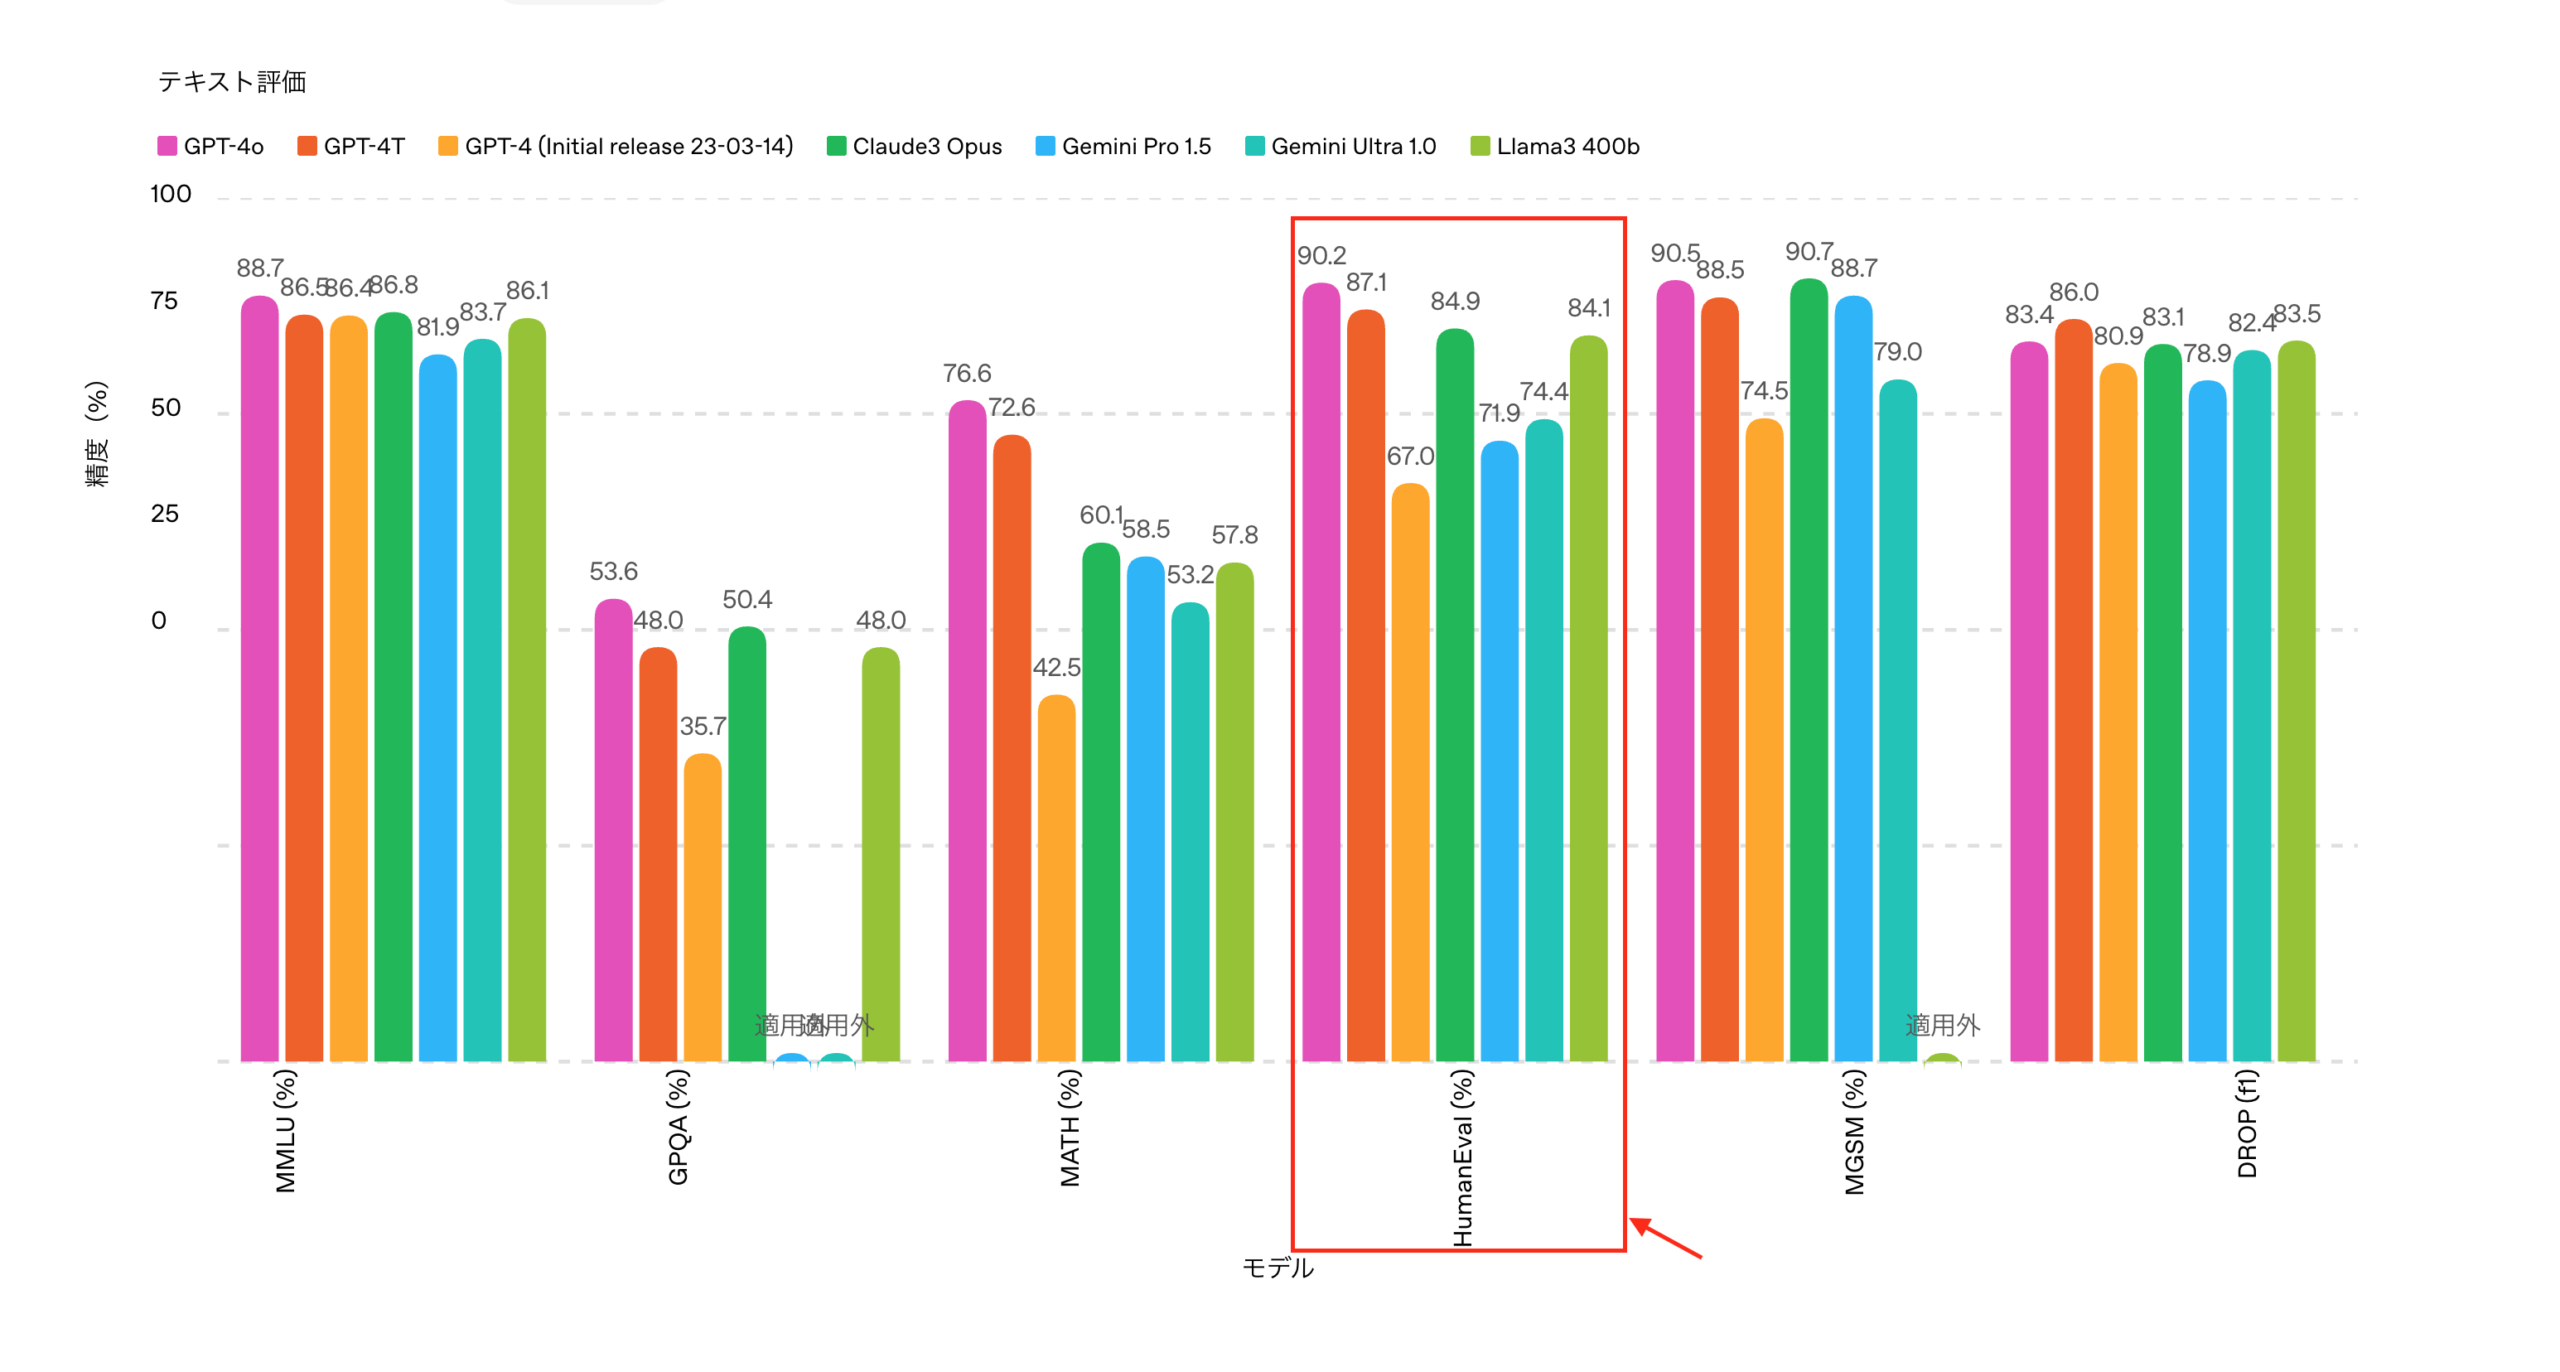
例えば、MMLUでは幅広い分野の選択式問題に対する正答率を測定します。以下は、GPT-4oの発表時にOpenAIが公開したベンチマーク結果で、左端にMMLUの評価が掲載されています。

数値の比較には評価条件と業務との関係が重要
評価スコアは、使用するデータや採点基準、モデルの設定などによって変わります。そのため、比較する際は条件を揃え、何を測った数値なのかを明確にする必要があります。
また、公開ベンチマークで高いスコアを得たモデルが、自社業務でも優れているとは限りません。例えば、要約のROUGEが高くても、業務上重要な条件や例外が抜けている可能性があります。
公開ベンチマークによる比較に加え、自社の業務データで正確性やタスク達成率、処理時間などを測定することが重要です。数値だけでは分からない問題の内容や原因は、定性評価で補います。
LLMの定性評価とは?
定性評価は、LLMの出力や動作について、良かった点、問題点、その理由などを文章や具体例で整理する方法です。点数だけでは分からない品質の特徴や、改善すべき内容を把握するために行います。
例えば、回答を「読みやすさ3点」と採点するだけでなく、「専門用語の説明がなく、初めて読む利用者には理解しにくい」と記録します。問題が生じた箇所と理由を具体的に残すことで、修正につなげやすくなります。
定性評価は人間によるレビューだけを指すものではありません。LLM-as-a-Judgeに問題点や改善理由を文章で出力させ、それを評価材料として使う方法もあります。
定性評価で記録する内容
評価対象となる出力や動作を示し、どのような問題があり、業務にどう影響するかを記録します。例えば、以下のような観点があります。
- 回答の内容:重要な条件や例外が抜けていないか
- 説明の分かりやすさ:読み手に合った用語や説明の順序になっているか
- 文脈への適合性:利用者の質問や状況を踏まえた回答になっているか
- 業務での使いやすさ:担当者による修正や追加確認がどの程度必要か
「分かりにくい」「役に立たない」といった感想だけで終わらせず、該当箇所と判断理由を具体的に記録することが重要です。
定量評価と組み合わせて改善につなげる
定量評価では問題の発生割合や改善前後の変化を把握し、定性評価では問題の内容や原因を掘り下げます。
例えば、社内FAQへの正答率が低下した場合、誤回答を確認し、「参照資料が不足している」「古い情報を使っている」「質問の条件を読み違えている」などの傾向を整理します。その結果を基に、資料の整備や検索方法、プロンプトの改善を検討できます。
定量評価で改善の必要性と効果を測り、定性評価で具体的な改善策を見つけることで、評価結果を実際の品質向上につなげられます。
評価を行う方法:人手評価と自動評価
定量・定性が評価結果の表し方を示すのに対し、人手・自動は評価を行う主体や仕組みを示します。
ここでは、それぞれの特徴と、品質・工数に応じた組み合わせ方を解説します。
人手評価(Human Evaluation)
人手評価は、人間がLLMの出力を読み、基準に沿って品質を判断する方法です。専門家や実際の利用者が確認することで、業務の背景や利用者の期待を踏まえた評価ができます。
文章で改善点を記録する定性的な方法と、正確性や読みやすさなどを点数化する定量的な方法があります。人手評価と定性評価は、必ずしも同じ意味ではありません。
人手評価で確認する品質
人手評価では、回答の正確性、流暢さ、安全性、ユーザーの意図との合致度などを確認します。特に、専門知識が必要な内容や、業務上の判断基準に沿っているかといった点は、専門家や現場担当者による確認が重要です。
例えば、カスタマーサポートでは、回答内容が正しいだけでなく、顧客の状況に合った案内になっているか、不適切な表現がないかも評価します。社内文書の要約では、重要な条件や例外が抜けていないか、担当者がそのまま業務に使えるかを確認します。
自動評価のスコアと実際の使いやすさに差がないかを検証し、業務に即した改善点を見つけられることが、人手評価の役割です。
LLMの人手評価の問題点
人手評価には、評価者の確保や作業に時間とコストがかかること、評価者の知識や経験によって判断がばらつくことなどの課題があります。
そのため、項目だけでなく、採点基準や判断例を事前に用意することが重要です。重要なケースを複数人で評価し、判断が分かれた理由を確認することで、評価基準の改善にもつなげられます。
大量のケースは自動評価で確認し、専門的な判断が必要なケースや評価が分かれるケースを人手で精査するなど、目的に応じて役割を分担すると、評価の品質と作業効率を両立しやすくなります。
自動評価
自動評価は、プログラムや評価モデルを使い、LLMの出力や動作を決められた基準で採点・判定する方法です。正解データとの照合、出力形式の検証、評価指標の計算、LLMによる採点などが含まれます。
多数のテストケースを繰り返し評価できるため、モデルやプロンプトを変更した際に、品質が改善したか、以前できていた処理ができなくなっていないかを確認する用途に適しています。
評価指標やテストによる自動採点
正解や成功条件を明確に定義できるタスクでは、生成結果をプログラムで照合して評価できます。例えば、以下のような方法があります。
- 分類・情報抽出:正解ラベルや抽出項目と照合し、正答率やPrecision・Recall・F1を計算する
- 要約・翻訳:参照文と比較し、ROUGE・BLEU・BERTScoreなどの指標を計算する
- 構造化出力:JSONの構文、必須項目、データ型が指定に合っているかを検証する
- コード生成:テストを実行し、期待する結果が得られるかを確認する
自社の業務要件に対応するテストを用意することで、変更前後の品質を継続的に比較できます。
LLM-as-a-Judge
近年注目を集めているのが、LLMが生成した回答を別のLLMが比較・採点するLLM-as-a-Judgeです。大規模なテストを効率的に実施できることから、実務でも活用が広がっています。
従来、人間が評価を行う場合は工数が膨大になり、数百から数千件のテストケースを扱う際には時間とコストが大きな負担となっていました。
これに対してLLMの場合は回答の品質や一貫性を自動的に判定できるため、効率性が飛躍的に向上します。
ただし、バイアスが入ることもあり、結果の客観性に疑問が残るケースもあります。そのため、ベンチマーク・人間の定性評価と組み合わせて利用することが望ましいとされています。
関連記事:「LLM-as-a-Judgeとは?LLMをLLMで評価するメリット・活用シーン・注意点を徹底紹介!」
人手と自動を組み合わせる方法
実務では、自動評価で広く継続的に確認し、人手評価で専門的な判断や問題の掘り下げを行う方法が有効です。
例えば、出力形式や正解との一致をプログラムで検証し、説明の分かりやすさや回答の関連性をLLM-as-a-Judgeで評価します。そのうえで、重要な業務の回答や、評価が分かれたケースを専門家・現場担当者が確認します。
自動評価で高得点だった回答も一部を抽出して人間が確認すると、評価の見逃しや採点基準の偏りを発見しやすくなります。人手評価で得た指摘をテストケースや採点基準へ反映し、評価の仕組み自体も改善することが重要です。
LLMに強い会社・サービスの選定・紹介を行います 今年度LLM相談急増中!紹介実績1,000件超え! ・ご相談からご紹介まで完全無料 完全無料・最短1日でご紹介 LLMに強いAI会社選定を依頼する
・貴社に最適な会社に手間なく出会える
・AIのプロが貴社の代わりに数社選定
・お客様満足度96.8%超
・GPT、Claude、Gemini、Llama等の複数モデルに対応
LLM導入のビジネス成果を測る評価指標(KPI)
LLMの導入効果は、回答精度だけでなく、コスト削減や生産性向上、顧客満足度などの成果で評価することが重要です。ここでは、ビジネス上の効果と実運用での成果を測る代表的な指標を紹介します。
LLM導入によるビジネスインパクトを評価する指標
このカテゴリのKPIは、LLM導入が事業の収益やコストにどれだけ貢献したかを直接的に示すもので、経営者が最も重視すべき指標です。
| KPI項目 | 具体例 | 測定方法 |
|---|---|---|
| ROI (投資対効果) | (導入による利益増 + コスト削減額) / 導入コスト | 導入にかかった総費用と、それによって得られた金銭的価値を比較します。 |
| コスト削減 | 問い合わせ対応の人件費削減率 コンテンツ作成時間の短縮による外注費削減 | LLM導入前後での特定業務にかかるコストを比較します。例えば、カスタマーサポート部門では、一次回答の自動化率をKPIとすることが考えられます。 |
| 生産性向上 | 1人あたりの報告書作成時間の短縮 営業メールの作成数増加 | 特定タスクの処理時間や処理量の変化を測定します。時間短縮 × 従業員の時給で金銭的価値に換算することも可能です。 |
| 売上向上 | AIアシスタント経由のコンバージョン率(CVR) パーソナライズされた提案によるアップセル/クロスセル率 | LLMが直接的に関与する収益機会での成果を測定します。 |
| 顧客評価(CSAT・NPS) | チャットボット対応後の満足度(CSAT) サービスに対する推奨意向(NPS)の変化 | CSATで個別の対応への満足度を測定し、NPSでサービス全体に対する推奨意向を確認します。NPSはLLM以外の要因にも左右されるため、補助指標として扱います。 |
推論性能や精度だけでなく、維持コストを含めた総合的な費用対効果を把握することがポイントです。
評価方法としては、API利用料や計算リソース使用量に対する処理件数、または1件あたりの回答生成コストを算出するアプローチが一般的です。
HELMなど包括的なベンチマークでも、コスト面が項目に含まれており、モデル選定の参考になります。
LLMの利用体験・運用成果を測る指標
ユーザー満足度
ユーザー満足度は、LLMが利用者の期待を満たし、良い体験を提供できているかを測る指標です。
方法としては、アンケートやフィードバックを通じたCSAT(Customer Satisfaction Score)や、NPS(Net Promoter Score)で測定します。
対話システムでは、会話が理解しやすかったか、期待する回答が得られたかといった観点から、ユーザーに5段階評価を求める手法も有効です。
実務においてはユーザー満足度を定性的な感覚にとどめず、KPIとして定量化し、回答精度や応答時間とあわせてモニタリングすることで、改善サイクルを回しやすくなります。
エスカレーション率
エスカレーション率は、LLMがユーザーの問い合わせやタスクを自律的に解決できたかを示す指標で、解決できずに人間の担当者へ引き継がれた割合を数値化します。
方法としては、総問い合わせ件数に対する人間オペレーターへの転送件数を算出し、一定期間で比較するのが基本です。
代表的なKPIには以下のようなものがあり、これらと併せてエスカレーション率を分析することで、LLMの実運用性能を多面的に把握できます。
- First Contact Resolution(FCR:初回解決率)
- Self-Service Rate(自己解決率)
実務では、エスカレーション率を下げることだけを目的化せず、どのような質問でエスカレーションが発生したかを分析し、ナレッジ強化やモデル改善に役立てることが重要です。
LLMの性能を測る技術的な評価指標・ベンチマーク
以下では、日本語能力や回答品質、推論能力、応答速度など、LLMの技術的な性能を測る評価指標とベンチマークを解説します。
日本語能力
日本語能力は、国内でLLMを導入する際に重視される指標です。特に日本語は文法の柔軟性や表現の多様性が高く、英語圏のデータで訓練されたモデルでは誤用や不自然な出力が生じやすいため専用のベンチマークで確認する必要があります。
| ベンチマーク名 | 特徴 | 対象分野・形式 | 評価のポイント・役割 |
|---|---|---|---|
| ELYZA-tasks-100 | 100種類のタスクを通じて日本語の生成能力を測定する評価セット | 要約、翻訳、文章生成、質問応答など多様なカテゴリ | 日本語文章の流暢さや実務における表現力を定量把握する指標 |
| JGLUE | 自然言語理解の総合力を測る標準ベンチマーク | 文書分類、文ペア類似度、含意関係推論、質問応答 | 日本語の意味理解や論理的推論の正確性を測定 |
| Japanese MT-Bench | 多段階の対話能力を評価するためのベンチマーク | 会話形式(マルチターン対話)、ロールプレイ、推論 | 人間による評価に近い結果が得られ、チャットや対話性能の検証に多用 |
| Rakuda Benchmark | 日本固有のコンテキストを含む指示応答能力に特化したテスト | 日本の地理、歴史、文化などに関する指示応答タスク | GPT-4を評価者(LLM-as-a-Judge)として活用し、国内特化の実用性を測定 |
参照:ELYZA-tasks-100(公式データセット)
参照:JGLUE(公式リポジトリ)
参照:Japanese MT-Bench(日本語版評価実装)
参照:Rakuda Benchmark(公式リポジトリ)
参照:LLM-as-a-Judge・MT-Benchの原論文
要約精度
要約精度は、主に議事録や報告書の要約、自動記事生成など業務利用に有効なKPIです。長文を的確に圧縮しつつ、主要な情報を保持できるかが成果を大きく左右します。
方法としては、生成要約と人手による参照要約を比較して一致度を測る自動評価指標が広く用いられます。
代表的な指標は以下の通りです。
- ROUGE:生成結果と参照文の単語やフレーズの重なりを定量化
- BERTScore:意味的な近さを測定
- MoverScore:文脈を考慮できる
企業利用においては、短時間で内容を理解できるかという主観的満足度も加えて測定することが望ましく、定量と定性を組み合わせた評価が効果的です。
参照:ROUGEの原論文
参照:BERTScoreの原論文
参照:MoverScoreの原論文
文法の正確性
文法の正確性は、LLMの出力が信頼できるかどうかを判断するKPIです。生成文の文法品質は、文法誤りを含む文章の割合や、敬語・助詞などの誤用件数を、人手評価や文法チェックツールで確認します。
関連する評価データセットには以下があります。
- 日本語:JCoLA(文の文法的な容認性を判定するデータセット)
- 英語:CoNLL-2014 Shared TaskやJFLEG(文法誤り訂正の評価に用いられるデータセット)
ただし、文法的に自然な文を判別する能力や、誤りを訂正する能力を測るものであり、通常の文章生成における文法品質とは区別して扱う必要があります。
実運用では、誤字脱字だけでなく、敬語の誤用や文構造の破綻といった日本語特有の課題を考慮することが重要です。
参照:JCoLA(公式リポジトリ)
参照:CoNLL-2014 Shared Task(公式サイト)
参照:JFLEG(公式リポジトリ)
出力結果の自然さ・可読性
出力結果の自然さ・可読性は、LLMが業務や顧客対応で利用される際の使いやすさを左右する指標として重要です。
自然さ・可読性は、流暢さ、簡潔さ、理解しやすさなどの基準を設け、人手評価やLLMを用いた評価で採点します。
また、読みやすさ指標としては英語圏で一般的なFlesch Reading Easeのほか、日本語向けには文の平均長や漢字比率などの基準が参考になります。
実務においては、マニュアルやFAQ生成など読み手が限られる文脈と顧客向けチャットや広告文など幅広い文脈とで求められる自然さの水準が異なります。そのため、用途に応じた基準を設けることが望まれます。
参照:Flesch Reading Easeの原論文「A new readability yardstick」
参照:LLM-as-a-Judgeによる回答品質評価の原論文
応答速度・処理能力
応答時間は、ユーザーからの入力に対して返答を生成するまでの速度を測定する指標で、業務利用における利便性やユーザー体験に直結します。
応答にかかる時間と、一定時間内に処理できる量を分けて測定します。平均値だけでなく、応答が遅いケースも含めて業務要件を満たすか確認することが重要です。
- Latency(応答遅延):入力を受け付けてから応答が完了するまでの時間
- TTFT:ストリーミング表示で最初のトークンが出力されるまでの時間
- Throughput(処理能力):単位時間あたりに処理できるリクエスト数やトークン数
出典・根拠の正確性と検索品質
出典参照の正確性は、LLMが提供する回答の信頼性を担保するために重要なKPIです。RAG(検索拡張生成)の普及とともに非常に重要性が増しています。
出典参照の正確性を評価するには、モデルが生成した回答に含まれる出典リンクや引用が、実際に提示した内容と整合しているかを検証するアプローチが一般的です。
代表的な指標には以下があります。
- Faithfulness(忠実性):回答中の主張が、取得したコンテキストに裏付けられているか
- Context Precision:検索結果の上位に、質問への回答に役立つ情報が含まれているか
- Context Recall:回答に必要な情報を、取りこぼさず取得できているか
これらはRagasなどの評価フレームワークで利用できます。
参照:Faithfulness(Ragas公式ドキュメント)
参照:Context Precision(Ragas公式ドキュメント)
参照:Context Recall(Ragas公式ドキュメント)
LLM×RAGに強い会社の選定・紹介を行います 今年度RAG相談急増中!紹介実績1,000件超え! ・ご相談からご紹介まで完全無料 完全無料・最短1日でご紹介 LLM×RAGに強い会社選定を依頼する
・貴社に最適な会社に手間なく出会える
・AIのプロが貴社の代わりに数社選定
・お客様満足度96.8%超
ハルシネーション検知
ハルシネーション検知は、LLMの出力が事実と異なる内容を生成していないかを確認するための評価指標です。
関連する評価データセットや手法には、以下があります。
- TruthfulQA:回答の事実整合性を確認
- FEVER:回答に含まれる情報検証を目的
- QAGS:要約と原文に対する質問応答の結果を比較し、要約が原文と事実的に整合しているかを評価する手法
実務上は、出力文を外部データベースや検索システムと照合し、回答に根拠があるかをスコア化する方法が効果的です。
参照:TruthfulQA(公式リポジトリ)
参照:FEVERの原論文
参照:QAGSの原論文
回答の真実性
回答の真実性は、LLMが生成する情報が、客観的事実や一次情報とどの程度一致しているかを測る指標です。
手法としては、モデル出力を参照データと照合し、正誤を定量化するFact-checkタスクが一般的です。
代表的なベンチマークには、TruthfulQAやFEVERなどがあります。日本語環境では、Wikipediaを基盤とした独自データセットや企業のナレッジベースを利用して正答率を算出する手法が採用されています。
また、真実性評価は自動指標だけでは不十分であり、回答に根拠となる出典を提示させ、参照元の信頼性も確認することが重要です。
参照:TruthfulQAの原論文
参照:FEVERの原論文
回答の一貫性・再現性
回答の一貫性・再現性は、同じ質問を繰り返した場合や、同じ意味の質問を異なる表現で入力した場合に矛盾のない回答を安定して返せるかを評価する観点です。
モデルのバージョン、プロンプト、生成設定、参照情報などの条件をそろえて複数回実行し、結論の一致率、回答間の矛盾率、品質基準を満たす割合などを測定します。
文章の完全一致だけでなく、意味や事実関係が一貫しているかを確認します。
翻訳精度
翻訳精度は、グローバルビジネスや国際取引においてLLMの活用範囲を広げる上で欠かせない指標です。言語間の表現差を正しく処理できるかが信頼性を左右します。
| 指標・手法名 | アプローチ・特徴 | 測定の仕組み・対象 | 実務上の位置づけ・メリット |
|---|---|---|---|
| COMET | 機械学習モデルを用いた意味・文脈ベース評価 | 原文・訳文・参照文を文脈レベルで包括的に照合 | 翻訳品質のデファクトスタンダード(事実上の標準)として広く普及 |
| BERTScore | 事前学習モデル(BERT)の埋め込み表現を利用した評価 | 単語やトークンの意味的類似度をベクトル比較 | 表層的な表現差に左右されず、文脈に即した意味的一致を測定可能 |
| BLEU | N-gram一致率に基づく伝統的な自動評価法 | 生成された翻訳文と参照訳(正解文)の表層的な一致度 | 業界標準として長年多用される最も一般的なベースライン指標 |
| METEOR | 語形変化や同義語まで考慮した一致度評価 | 単語の一致に加え、ステミング(語幹化)や類義語の辞書マッチング | BLEUの欠点(表現の揺らぎに対する厳しさ)を補い、人間評価に近い相関を実現 |
| TER | 参照翻訳に一致させるための編集コスト評価 | 挿入、削除、置換、単語移動の最小編集操作回数 | ポストエディット(人手による修正)に必要な労力や工数の見積もりに有用 |
単語レベルの一致を見るだけでなく、意味の正確性や自然な表現が保たれているかを多角的に確認することが求められます。
参照:BLEUの原論文
参照:METEORの原論文
参照:TERの原論文
参照:COMETの原論文
参照:BERTScoreの原論文
センチメント分析精度
センチメント分析精度は、LLMの生成テキストに含まれる感情・意図を正確に識別できるかを測定する指標です。
ポジティブ・ネガティブ・ニュートラルといったラベルとの一致率を確認する分類タスクが一般的で、代表的な指標にはAccuracy(正解率)、Precision/Recall/F1スコアが用いられます。
また、マルチクラス分類や文脈依存の感情把握を評価するために、JGLUEの感情分析タスクが利用されることもあります。
参照:JGLUE・MARC-ja(感情分析データセット)
参照:Accuracy・Precision・Recall・F1の定義(scikit-learn公式ドキュメント)
推論能力
推論能力は、LLMが複数の前提を組み合わせて新しい結論を導き出せるかを測定する指標です。手法としては、自然言語推論タスク(NLI)が代表的で、以下のようなデータセットがあります。
| ベンチマーク / データセット名 | 対応言語 | 推論タイプ・評価内容 | 特徴・検証ポイント |
|---|---|---|---|
| SNLI (Stanford Natural Language Inference) | 英語 | 自然言語推論(NLI) | 前提文と仮説文の関係(含意・矛盾・中立)を判定する標準的データセット |
| MNLI (Multi-Genre NLI) | 英語 | 自然言語推論(NLI) | 多様なジャンルのテキストを対象とし、汎用的な文間推論能力を測定 |
| JGLUE(NLIタスク) | 日本語 | 自然言語推論(NLI) | 日本語環境における文間の論理的関係(含意・矛盾など)の把握力を評価 |
| JSICK (日本語版SICK) | 日本語 | 文ペア推論・類似度判定 | 文間の含意関係判定や文の意味的類似度を検証する日本語ベンチマーク |
| DROP (Discrete Reasoning over Paragraphs) | 英語 | 段落読解・離散推論 | 文章中の情報に基づき、加減算や数値比較・計数などの離散推論能力を測定 |
| AR-LSAT | 英語 | 論理的・分析的推論 | 米国のロースクール入学適性試験(LSAT)の分析的推論問題を用いた高度な論理検証 |
参照:SNLI(公式サイト)
参照:MultiNLI/MNLI(公式サイト)
参照:JGLUE・JNLI(公式リポジトリ)
参照:JSICK(公式リポジトリ)
参照:DROPの原論文
参照:AR-LSAT(公式リポジトリ)
対話性能
対話性能は、ユーザーとの自然なやり取りをどの程度維持できるかを示す指標です。方法としては、応答の関連性や一貫性を測定する自動評価指標に加え、人手による会話の自然さ・満足度評価が広く行われています。
代表的なベンチマークは、以下の通りです。
- Persona-Chat:自然な対話力を測定する
- Dialogue NLI:対話に含まれる発言間の矛盾や一貫性を評価する
- DSTC(Dialog State Tracking Challenge):長期的な会話における一貫性を評価する
実務の現場では対話の流暢さだけでなく、ユーザーの意図把握や感情の汲み取りが求められるため、センチメント分析やユーザー満足度指標と組み合わせて評価されます。
参照:Persona-Chatの原論文
参照:Dialogue NLIの原論文
参照:DSTCの原論文
知識量
知識量は、LLMがどれだけ広範な情報を保持し、質問に対して網羅的な回答を提供できるかを測定する指標です。一般的な百科事典的知識だけでなく、業界特有の専門知識をどの程度カバーしているかが重要になります。
代表的なベンチマークとしては、以下のようなものがあります。
| ベンチマーク / データセット名 | 主な対応言語 | 評価対象・知識の領域 | 特徴・検証ポイント |
|---|---|---|---|
| MMLU (Massive Multitask Language Understanding) | 英語(多言語展開あり) | 学術・専門知識(57分野) | 人文、社会、STEMなど多岐にわたる専門分野の多肢選択問題で総合的な知識保持力を測定する業界標準指標 |
| ARC (AI2 Reasoning Challenge) | 英語 | 科学知識・論理推論 | 小学校から高校レベルの科学試験問題を用い、単なる事実暗記にとどまらない知識の活用・推論力を評価 |
| Natural Questions(NQ) | 英語 | 実用的な検索・事実知識 | Google検索に実際に投稿された自然なクエリに基づき、事実関係の網羅的な回答能力を検証 |
| TriviaQA | 英語 | 百科事典・トリビア的知識 | 雑学愛好家向けの難問を含む質問応答データセットで、広範な事実知識の保持量を測定 |
| JGLUE(QAタスク) | 日本語 | 日本語の汎用事実知識 | 日本語による質問応答タスクを通じ、国内コンテキストや一般的な事実関係への正確な回答力を測定 |
| ELYZA 知識ベースデータセット | 日本語 | 日本語特有の知識カバレッジ | 日本固有の文脈や専門領域における知識カバレッジを評価し、実務利用に足る情報保持力を検証 |
知識量の評価では情報の多さだけでなく、正確さと最新性も考慮されます。
実務においては、知識量を補強するためにRAGを組み合わせ、モデルが外部データベースを参照できる仕組みを導入する方法が有効です。
参照:Natural Questions(公式リポジトリ)
参照:TriviaQAの原論文
参照:ARC(公式データセット)
参照:MMLU(公式リポジトリ)
選択性能
選択性能とは、複数の選択肢から適切な回答を導き出せるかを測る指標であり、主に意思決定支援に直結します。代表的なベンチマークは、以下の通りです。
- MMLU(Massive Multitask Language Understanding)
- PIQA(Physical Interaction QA)
- RACE(Reading Comprehension Dataset)
方法としては、正答率(Accuracy)を中心に、複数解答が許される場合にはRecallやF1スコアも併用されます。
単に正解を選ぶだけでなく、なぜその選択肢が最適なのか、他の選択肢がなぜ不適切なのかを説明させる能力(Rationale Generation)も合わせて評価することが増えています。
参照:MMLU(公式リポジトリ)
参照:PIQAの原論文
参照:RACEの原論文
参照:Accuracy・Recall・F1の定義(scikit-learn公式ドキュメント)
数学的問題解決能力
数学的問題解決能力は、数式や数理的推論を正しく扱えるか測定する指標です。代表的なベンチマークには、以下のようなものがあります。
- GSM8K(Grade School Math 8K)
- MATH Dataset
- AQuA-RAT
手法としては正答率(Accuracy)が基本ですが、複数のステップを要する解法では、途中過程の妥当性を検証する逐次推論評価(Step-by-Step Reasoning Evaluation)も有効です。
近年は、数値を含む文章問題を理解し、適切に数式へ変換できるかが問われるケースが増えており、自然言語処理と数学的推論の両立が必要とされています。
参照:GSM8K(公式データセット)
参照:MATH(公式リポジトリ)
参照:AQuA-RAT(公式リポジトリ)
タスク達成率
タスク達成率は、与えられた指示や業務要件を正確かつ完全に遂行できたかを示す指標です。LLMをAIエージェントとして使う際の評価として現在最も活発に研究が進んでいる領域の一つです。
業務ごとの成功条件を事前に定義し、評価対象のタスクのうち、成功条件を満たしたタスクの割合を算出します。回答内容だけでなく、必要な処理が完了したか、指定した条件や形式を守ったかも確認します。
BIG-BenchやHELMはモデルの幅広い能力を比較する参考になりますが、自社業務のタスク達成率は、実際の業務に即したケースで測定する必要があります。
AgentBenchやToolBenchなど、より複雑な実世界のタスクを、LLMが複数のツールを自律的に利用しながらエージェントとして遂行できるかを評価する新しいベンチマークも登場しています。
参照:BIG-Bench(公式リポジトリ)
参照:HELM(Stanford公式解説)
参照:AgentBench(公式リポジトリ)
参照:ToolBench(公式リポジトリ)
LLMの評価を効率化するツール・フレームワーク
LLMの評価を効率化する代表的なツールと、モデル選定・開発・運用などのフェーズに応じた使い分けを紹介します。
主要な評価ツール・フレームワークの比較
LLMの自動評価指標を運用するには、複数の評価指標を一元的に実行できるツールを活用するのがおすすめです。代表的なツールとしては、以下の4つです。
| 評価ツール | 概要 | 特徴 | 適しているタスク |
|---|---|---|---|
| Hugging Face Evaluate | Hugging Faceが提供するPythonライブラリ |
| 汎用的なタスク全般に適していて、モデル比較や研究開発向き |
| OpenAI Evals | OpenAIが提供する評価フレームワーク |
|
|
| LM Evaluation Harness | EleutherAIが開発した研究者向け評価スイート |
|
|
| LangSmith | LLMアプリケーションやAIエージェントのトレース・評価・監視を行うプラットフォーム |
|
|
モデル選定・開発・運用での評価ツールの使い分け
評価ツールは、対象とするモデルやアプリケーション、評価の目的に応じて選択します。単体で利用するほか、必要に応じて組み合わせることで、開発・検証・運用の各フェーズに合わせた評価体制を構築できます。
以下は、フェーズごとの使い分けの例です。
| フェーズ | フレームワーク使い分け |
|---|---|
| モデル選定 | LM Evaluation Harnessで、候補となるモデルの総合的な基礎能力を比較 |
| 開発・プロトタイピング | LangChain & LangSmithでアプリケーションの各コンポーネントが意図通りに動いているか、トレース機能で詳細にデバッグ・評価 |
| CI/CD・リリース前 | OpenAI Evalsで定義したテストケース(重要なプロンプトなど)で性能が劣化していないか、自動で回帰テストを実行 Hugging Face Evaluateで独自の定量的指標(例:特定の用語を必ず含んでいるか)をCIパイプラインに組み込み、品質ゲートとして利用 |
| 運用・モニタリング | LangSmithで本番環境でのユーザーとのやり取りを監視し、予期せぬエラー、レイテンシーの悪化、低評価の応答などを検知 |
これらのフレームワークは競合するだけでなく、開発ライフサイクルの各段階で相互に補完し合う関係にあります。目的とフェーズに応じて適切に使い分けることが、高品質なLLMアプリケーションを迅速に開発・改善する鍵となります。
【活用シーン別】LLM性能評価で使う指標をどうやって決めるか?
LLMの評価で重視すべき指標は、利用する業務によって異なります。ここでは、代表的な活用シーンごとに、確認すべき品質と評価指標の選び方を整理します。
カスタマーサポート
カスタマーサポート業務にLLMを導入する場合、評価の焦点となるのは、「ユーザーが求める回答をどれだけ正確に迅速に返せるか」という点にあります。そのため、以下を重視する必要があります。
- 回答精度
- 一貫性
- 顧客満足度との相関
定量的には、正答率や応答速度を測定し、FAQデータベースとの照合テストを行うことで基礎的な精度を把握します。
一方で、回答のトーンが適切であるか、顧客に対して不快感を与えていないかといったように、数値では測れない要素もあります。そのため、人間による定性評価が欠かせません。
また、運用を重ねる中でユーザーフィードバックを収集し、評価フローに組み込むことも重要です。
社内情報検索(RAG活用)
社内情報検索にLLMを活用する場合、評価のポイントは「正確に必要な情報を引き出し、誤情報を混入させない」ことにあります。
定量的には、以下のような指標が重要になります。
- 必要な情報をどれだけ網羅できたか
- 正しい情報のみを提示できたか
- 回答がナレッジベースの一次情報に基づいているか
LLM品質測定において、誤引用や情報の歪曲は業務上のリスクに直結するため注意が必要です。
また、定性的評価では、回答が利用者にとって理解しやすいか、業務でそのまま活用できる具体性があるかといった観点を評価します。正しい情報を返すだけでなく、ユーザーの文脈に沿ったわかりやすい表現であるかがポイントです。
また、データ更新頻度や情報の網羅性も含めるべき項目です。社内のドキュメントやFAQが最新でなければ、いくら精度の高いモデルでも誤った出力を返す可能性があります。
コンテンツ生成
コンテンツ生成にLLMを活用する場合、評価の焦点は文章の品質と目的への適合性です。文法的に正しい文章を生成できるかだけでなく、有益で一貫性のある情報を提供できるかが特に重要です。
定量的には、文章の要約や翻訳タスクで用いられるROUGEやBLEUといったベンチマークを活用することで情報の正確性や適合度を測定できます。しかし、これらのスコアはあくまで参考値であり、実務的な評価には直結しないことも多いです。
そのため、定性的評価の役割が大きくなります。以下のような観点においては、編集者や専門家がレビューすることが必須です。
- 文章が読みやすいか
- 専門性や権威性が十分に表現されているか
- ユーザーの疑問や懸念に適切に応えているか
自動評価と人手評価を組み合わせ、数値による比較と具体的な問題点の分析を行うことで、評価の品質と効率の両立を図れます。
データ分析
データ分析の領域でLLMを活用する際には、出力される分析結果の正確性と再現性が評価基準になります。社内のBIツールやデータベースと連携し、自然言語クエリからインサイトを導くケースでは誤った数値や解釈が生じる可能性があります。
定量的には、数値の一致率やデータクエリの精度を測定することが基本です。
実際のSQLクエリやBIダッシュボードの結果と照合し、出力の正確性をスコア化することでLLM品質測定を客観的に行うことが可能です。
一方で、定性的評価では分析結果の説明が理解しやすいか、意思決定に役立つ解釈が提示されているかといった観点が重視されます。
カスタマイズLLMの評価
多くの企業では独自データを組み込み、ドメイン知識を強化したカスタマイズLLMを構築しています。カスタマイズLLMは以下の流れで評価します。
- 汎用モデルとの比較
- ユースケースに特化したテスト
- 改善サイクルの定着
カスタマイズLLMの評価では、汎用モデルとの比較が欠かせません。回答の正確性や業務適合性を比較することで、独自調整の効果を客観的に把握できます。
定量的には、既存ベンチマークに加え、社内FAQや業務シナリオを再現した独自テストデータを用いることが有効です。
次に、定性的評価では、ユーザーにとって理解しやすいか、専門性や正確性が担保されているかを確認する必要があります。
さらに、継続的な性能改善サイクルに組み込むことがポイントです。初期評価で得られた課題をもとにデータ品質やプロンプト設計を改善し、再評価を行うプロセスを定着させることでモデルの信頼性は時間とともに向上します。
LLM性能評価の注意点
LLMの性能評価を進める際には、そこに潜む落とし穴に目を向ける必要があります。
評価指標の選定ミスでユーザー満足度と乖離する
起こりやすい問題の一つが、指標の選定ミスです。特に、カスタマーサポートや社内情報検索のような実務ケースでは、回答が正しいだけでなく、迅速性・トーン・文脈理解といった要素が満足度に直結します。
これらは定量的なLLM評価指標では測りづらいため、定性評価やユーザーフィードバックを組み込むことで補完する必要があります。
また、初期段階で何を重視するのかを明確に定義しないまま評価を始めると測定結果と業務の期待値が乖離し、改善サイクルが空回りするリスクがあります。
そのため、定量と定性の両面から評価基準を組み立てることがポイントです。
ベンチマークへの過剰依存
LLMの性能評価ではベンチマークが広く活用されていますが、これらの数値だけに依存することは危険です。なぜなら、ベンチマークは業務環境や自社のユースケースを完全に反映できるわけではないからです。
そのため、ベンチマークはあくまで補助的なツールとして捉え、自社の業務に沿ったテストケースを組み込むことが求められます。
ユーザーフィードバックを反映する仕組みは必須
LLM評価を実務に結びつけるには、実際のユーザーフィードバックを取り入れることが重要です。開発時のテストだけでは捉えきれない使いにくさや、実運用で発生する問題を把握し、評価基準やテストケースへ反映します。
ユーザーフィードバックの収集方法としては、以下のような方法が挙げられます。
- 顧客サポートでの解決率や顧客満足度アンケート
- 社内検索における検索再試行率
- 生成コンテンツの編集工数
これらは数値化されるため、LLM評価基準に組み込みやすく、改善効果を定量的に示すことが可能です。
さらに、集めたフィードバックを改善サイクルに反映する仕組みを構築することも重要です。誤回答が頻発する分野のデータを補強したり、出力スタイルを調整したりすることでLLMの性能測定の実効性が高まります。
つまり、ユーザーフィードバックは評価フロー全体を現場に適合させる要で、企業が長期的にLLMを運用していくうえでの信頼性向上に直結します。
ハルシネーション(もっともらしい嘘)
LLMは、学習データに存在しない情報や誤った情報を、事実であるかのように堂々と生成することがあります。これをハルシネーションと呼びます。
例えば、顧客への回答文を生成させた際に、存在しない製品機能やサポート窓口の電話番号を生成してしまうケースが考えられます。
これは顧客満足度の低下や、企業の信頼失墜に直結する深刻な問題です。
バイアス(偏見)
LLMは、学習データとなったインターネット上の膨大なテキストに含まれる偏見を再生産・増幅してしまう可能性があります。特定の性別、人種、職業などに対する固定観念に基づいた不適切な表現を生成し、企業のブランドイメージを大きく損なうリスクを孕んでいます。
近年では、開発段階で「Red Teaming」と呼ばれる、専門家があらゆる手段でモデルの脆弱性や有害な応答を引き出そうとするテストが行われるなど安全性の確保が重要視されています。
評価環境を固定化させる
LLMの評価環境が頻繁に変わると、同じ改善施策を試しても結果が揺らぎ、改善効果を客観的に判断できなくなります。特に、クラウド環境や外部APIを利用している場合、バージョンアップや設定変更による影響を受けやすいです。
環境を固定するには、使用するデータセットを統一し、テスト条件を明文化することが重要です。初期利用した社内FAQデータやRAG用のドキュメント群を使うことで比較可能な結果が得られます。
また、ベンチマークのバージョンや手法も固定し、必要に応じて変更をログとして記録することで再現性を確保できます。
LLMの性能評価方法についてよくある質問まとめ
- LLMの性能評価はなぜ必要なのか?
LLMを導入しただけでは効果が見えにくく、業務効率化やROIを判断できません。性能評価を行うことで、改善すべきポイントを特定し、精度改善や継続的な最適化につながります。
- LLMの性能を評価する際に、特に注意すべき点は何ですか?
以下の点に注意が必要です。
- 指標の選定ミス: ビジネス上の価値とずれた指標を選ぶと、ユーザー満足度と乖離した結果になるため、指標は慎重に選びましょう。
- ベンチマークへの過信: ベンチマークはあくまで基礎体力であり、自社の業務に適合するかは別途、専用のテストで検証する必要があります。
- ハルシネーションとバイアス: もっともらしい嘘や偏見を含んだ出力をしないか、定性的なチェックが不可欠です。
- 評価環境の固定: 改善効果を正しく測定するため、テストデータや評価手法などの環境は、比較する際に必ず統一してください。
まとめ
LLMの性能評価では、モデルの技術的な性能と、自社の業務で得られるビジネス成果の両面を確認することが重要です。公開ベンチマークのスコアだけで判断せず、実際の業務に即したテストデータと評価基準を用意する必要があります。
評価にあたっては、人手と自動を組み合わせ、数値による比較と具体的な問題点の分析を行います。LLM-as-a-Judgeや評価ツールも活用することで、作業を効率化しながら、品質の変化や改善すべき箇所を把握できます。
また、導入前の検証だけでなく、運用中のユーザーフィードバックや業務成果を評価に反映し、継続的に改善することが欠かせません。品質・応答速度・コストなどのバランスを確認し、自社の目的に合った運用を目指しましょう。
自社に適した評価指標の選定や、LLMの導入・改善にお悩みの場合は、AI Marketにご相談ください。業務課題や導入目的に応じて、LLMの開発・運用を支援できるAI開発会社をご紹介します。
AI Market 運営、BizTech株式会社 代表取締役|2021年にサービス提供を開始したAI Marketのコンサルタントとしても、お客様に寄り添いながら、現場のお客様の課題ヒアリングや企業のご紹介を5年以上実施しています。これまでにLLM・RAGを始め、画像認識、データ分析等、1,000件を超える様々なAI導入相談に対応し、参加累計8,000人を超えるAIイベントを主催。AIシステム開発PM歴8年以上。AI Marketの記事では、AIに関する情報をわかりやすくお伝えしています。(JDLA GENERAL 資格保有)
▶ 監修者の実績・経歴を詳しく見る
AI Market 公式𝕏:@AIMarket_jp
Youtubeチャンネル:@aimarket_channel
TikTok:@aimarket_jp
運営会社:BizTech株式会社
掲載記事に関するご意見・ご相談はこちら:ai-market-contents@biz-t.jp
お電話で無料相談

