

ChatGPTの仕組みとは?高精度なテキスト生成の仕組みを具体的にわかりやすく解説!
最終更新日:2026年10月08日
記事監修者:森下 佳宏|BizTech株式会社 代表取締役

ChatGPTは、LLM(大規模言語モデル)を活用した対話型の生成AIで、まるで人間とやりとりしているように自然に会話できます。LINEやSlackに似たシンプルなUIなので、ほとんどの人は簡単に操作して、回答を引き出せます。
しかし、ChatGPTの仕組みが分かると、なぜ精度の高いテキストを生成できるのか?どんなことは苦手なのか?どのように使うべきか/使ってはいけないか、がもっと明確にわかり、効果的に活用できるようになります。
今回は、ChatGPTの背後にある言語処理、ディープラーニングの技術的な仕組みに注目し、詳しく解説します。
関連記事:「ChatGPTとは?機能・使い方・ビジネス活用事例を解説」
ChatGPTの活用・カスタマイズに強いAI開発会社を自力で選びたい方はこちらで特集していますので併せてご覧ください。
\今年度、AI導入相談増加中!/

目次
ChatGPTはLLM(大規模言語モデル)で動いている

ChatGPTの会話能力の背後には、GPTシリーズなどのLLMが使用されています。LLMは大量のデータから言葉や文脈のパターンを学び、入力に応じて文章を生成するAIモデルです。
このGPTは、公開されているインターネット上の情報を中心とした多くの情報で学習されています。なお、現在のChatGPTは文章だけでなく、画像や音声なども扱えるマルチモーダルとなっています。
モデルは学習を通じて調整されたパラメータと、入力された質問や会話の文脈を使い、回答を生成します。
関連記事:「LLMとは?仕組み・代表的なモデル・導入方法を解説」
参照:OpenAI|ChatGPTと当社の基盤モデルの開発方法
事前学習と事後学習
GPTのようなLLMの開発は、大きく事前学習と事後学習に分けられます。事前学習で膨大な文献等から幅広いパターンを学び、事後学習で指示への従い方や回答の有用性・安全性を調整し、出力精度を上げていきます。
事前学習
事前学習では、大量のデータに含まれる関係性を学びます。文章の場合は、文脈から次に続く語句を予測する学習などを通じて、文章の構造や表現、幅広い話題に対応する土台を作ります。
例えば、「会議の日程を変更したいので、参加者に・・・」のような文章に続く表現を予測する学習を重ねることで、言葉のつながりや文脈に応じた表現を学びます。
事後学習
事後学習では、人間が作成した回答例を使う教師あり学習や、人間による回答の評価を利用する強化学習(RLHF)などを通じて、利用者の指示に沿った応答へ調整します。
RLHFでは、同じ質問に対する複数の回答を「人間」が比較・評価し、その評価をモデルの調整に活用していく手法です。
例えば「取引先に送る日程変更のメールを書いて」という指示に対し、用件が伝わり、相手に配慮した回答が高く評価されれば、その評価された内容の特徴を持つ回答を生成しやすく調整していきます。
開発者向けの、LLMをカスタマイズするファインチューニングは、対応するモデルに学習用の入出力例(例えば業界の専門用語など)を与え、特定の用途に対しての回答精度を上げる技術です。
ただし、GPTのようなOpenAIが提供しているクローズドモデルでは、ファインチューニングを行うことは一般的にできません。ファインチューニングを行う際は、オープンソース・オープンウェイトのLLMを利用する必要があります。
関連記事:「ファインチューニングとは?メリット・デメリットやRAGとの違いを解説」
関連記事:「オープンソースLLMとは?代表モデル・ダウンロード数・比較と選び方を解説!」
参照:OpenAI|ChatGPTと当社の基盤モデルの開発方法
参照:OpenAI|Supervised fine-tuning
LLMに強い会社・サービスの選定・紹介を行います
今年度LLM相談急増中!紹介実績1,000件超え!
・ご相談からご紹介まで完全無料
・貴社に最適な会社に手間なく出会える
・AIのプロが貴社の代わりに数社選定
・お客様満足度96.8%超
・GPT、Claude、Gemini、Llama等の複数モデルに対応
完全無料・最短1日でご紹介 LLMに強いAI会社選定を依頼する
ChatGPTはどんな仕組みで動いている?

まずは、ChatGPTの基本的な仕組みについて解説します。ここでは、ChatGPTを支える技術であるディープラーニング、Transformerについて説明します。
ディープラーニング
ChatGPTに用いられているLLM(大規模言語モデル)であるGPTは、インターネット上にある巨大なテキストデータセットを用いて訓練されたディープラーニング(深層学習)モデルです。ディープラーニングとは、脳の神経細胞ネットワークからヒントを得たコンピュータアルゴリズムを用いて、データから複雑なパターンを学習する機械学習の技術です。
GPTは、人間の書いたテキストの膨大なコレクションから言語の使用パターンを学習します。この学習プロセスを通じて、ChatGPTは特定の単語やフレーズがどのような文脈で使用されるか、どのような意味を持つかを理解して振る舞うことができます。
ChatGPTの複雑な文構造を理解して適切な応答を生成する能力は、マーケティングコンテンツの生成や内部文書の自動化に活用できます。ChatGPTは、特定のトピックについてのブログ記事を生成したり、報告書のドラフトを作成することが可能です。
言語パターンを基にして新しいテキストを生成する際には、文脈に応じた適切な言葉選びや文法構造を適用することが可能になります。これはChatGPTが自然で人間らしいテキストを生成するために重要な仕組みとなります。
Transformer
GPTシリーズの基盤となるTransformer(トランスフォーマー)は、文章内の語句どうしの関係を扱うニューラルネットワークのアーキテクチャです。
その中心的な仕組みの一つがAttention機構(注意機構)です。ある語句を処理するときに、文脈中の他の語句との関係に応じて参照する情報の重みを変えます。これにより、前後の文脈を踏まえた文章生成が可能になります。
ただし、Attention機構が重要な情報を常に正しく見極めるわけではありません。自然な文章を生成できても、事実関係を取り違える場合があります。
なお、Transformerは、Googleの研究者らを中心とするチームが2017年に発表した論文「Attention Is All You Need」で提案されたアーキテクチャです。
関連記事:「Transformerとは?仕組み・特徴とChatGPTとの関係を解説」
参照:arxiv|Attention Is All You Need(Transformerの原著論文)
ChatGPTが回答するまでのプロセスとモデルの改善
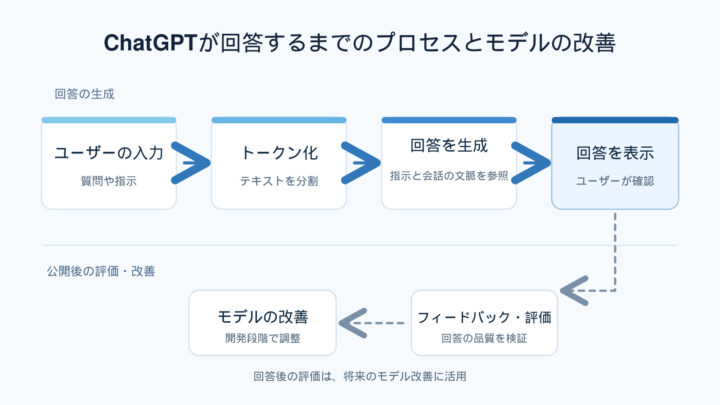
ChatGPTが入力に応じて、出力を生成して回答するまでのプロセスを説明します。あわせて、利用後の評価がモデルの改善にどう活用されるかも紹介します。この記事では文章生成に焦点を当てています。
入力されたテキストの処理
ユーザーからの入力を受け取った際、テキストはモデルが扱う「トークン」という単位に変換されます。トークンには、単語全体や単語の一部、句読点などが含まれます。
以下の画像は、文章がどのようにトークンに分割されるかを確認できるOpenAIの「Tokenizer」の画面です。例えば「おはようございます。今日もよろしくお願いします。」という文字列は以下のようにトークン化されます。
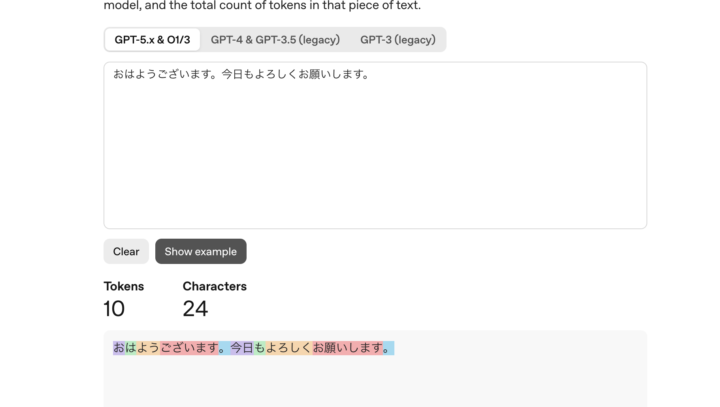
上記であれば、「お」「は」「よう」「ございます」のように、それぞれ別のトークンとして扱われていることがわかります。
文脈の把握
ChatGPTは、ユーザーの入力が何を求めているか、どのような応答が適切かを、指示や会話の文脈を踏まえて処理します。
例えば「先ほどの文章を短くして」と指示された場合は、それまでの会話にある文章を踏まえて回答を生成します。
回答の生成
入力と会話の文脈を基に、ChatGPTは回答を構成するテキストを順に生成します。学習を通じて調整されたモデルを使い、文脈に続くトークンを予測しながら文章を作ります。
質問の内容によっては、Web検索やファイル参照などのツールを利用し、得られた情報を回答に反映します。
回答の出力
生成された文章が、ユーザーに回答として表示されます。
ChatGPTは指示に沿った自然な文章を作成できますが、重要な事実や数値は元の資料や提示された出典と照合して確認することが大切です。
回答の評価と改善
ChatGPTの回答は、ユーザーからのフィードバックや評価者によるレビューなどを通じて評価されます。
こうした評価は、モデルの性能や改善点を把握するために活用されます。
モデルの改善
評価結果などを踏まえ、開発段階では必要に応じてモデルの追加学習や調整が行われます。この改善は、個々の回答を生成する工程とは別に進められます。
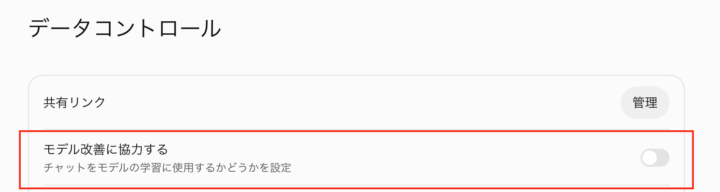
ChatGPTの設定画面にある「データコントロール」では、「モデル改善に協力する」の項目から、自分の会話をモデルの改善に利用してよいかどうかを設定できます。(ビジネス利用では、この設定はオフにしておくことで、機密情報の漏洩などのリスクを低下させることができます。)
関連記事:「ChatGPTに「学習させない」オプトアウト設定とは?機密情報を漏洩させないための手順やメリットを徹底解説!」
参照:OpenAI|ChatGPTと当社の基盤モデルの開発方法
LLMに強い会社・サービスの選定・紹介を行います
今年度LLM相談急増中!紹介実績1,000件超え!
・ご相談からご紹介まで完全無料
・貴社に最適な会社に手間なく出会える
・AIのプロが貴社の代わりに数社選定
・お客様満足度96.8%超
・GPT、Claude、Gemini、Llama等の複数モデルに対応
完全無料・最短1日でご紹介 LLMに強いAI会社選定を依頼する
ハルシネーションに注意
これまで解説した通り、ChatGPTのようなLLMは、これまで学習した情報を元に、単語の次に来る単語(トークン)を確率的に予測して文章を生成します。
この予測は確率的に行われており、出力された回答が正しい情報ではない可能性があります。このように、AIがもっともらしい誤情報を生成する現象が「ハルシネーション」と呼ばれます。
そのため、LLMを活用する際は、このハルシネーションである可能性があることを常に頭に入れておきながら活用することが重要です。
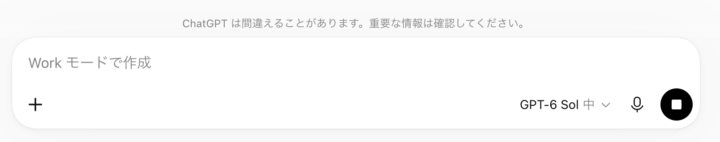
ChatGPTのテキスト入力欄にも、「ChatGPTは間違えることがあります。重要な情報は確認してください。」という注意書きがあるのもこのためです。
関連記事:「ハルシネーションとは?原因は?生成AI、LLMのリスクを抑える方法を徹底解説!」
ChatGPTの仕組みについてよくある質問まとめ
- ChatGPTはどのような仕組みで文章を生成しますか?
ChatGPTは、入力された文章をトークンという単位で処理し、質問や会話の文脈を踏まえて、次に続くトークンを予測しながら回答を生成します。
自然な文章を作れるのは、大量のデータを用いた事前学習と、人間の指示に沿うよう調整する事後学習によるものです。
- ChatGPTはなぜ事実と異なる回答をすることがありますか?
ChatGPTは文脈に続くトークンを予測して文章を生成するため、自然に読める回答でも内容が正しいとは限りません。
もっともらしい誤情報を生成する現象は「ハルシネーション」と呼ばれます。
そのため、重要な事実や数値は、元の資料や出典で確認する必要があります。
まとめ
ChatGPTの自然な対話は、Transformerを基盤とするLLMの事前学習と、人間の指示に沿った応答へ調整する事後学習に支えられています。
仕組みや生成プロセスを理解することで、革新的なAI技術をより最適かつ正確に使用することができます。AI技術は日々進化するため、引き続き学習を続けていきましょう。
ChatGPTの活用・カスタマイズに強いAI開発会社を自力で選びたい方はこちらで特集していますので併せてご覧ください。
AI Market 運営、BizTech株式会社 代表取締役|2021年にサービス提供を開始したAI Marketのコンサルタントとしても、お客様に寄り添いながら、現場のお客様の課題ヒアリングや企業のご紹介を5年以上実施しています。これまでにLLM・RAGを始め、画像認識、データ分析等、1,000件を超える様々なAI導入相談に対応し、参加累計8,000人を超えるAIイベントを主催。AIシステム開発PM歴8年以上。AI Marketの記事では、AIに関する情報をわかりやすくお伝えしています。(JDLA GENERAL 資格保有)
▶ 監修者の実績・経歴を詳しく見る
AI Market 公式𝕏:@AIMarket_jp
Youtubeチャンネル:@aimarket_channel
TikTok:@aimarket_jp
運営会社:BizTech株式会社
掲載記事に関するご意見・ご相談はこちら:ai-market-contents@biz-t.jp
お電話で無料相談

