

AIモデルとは?アルゴリズムとの違い・種類・学習方法・構築手順を解説
最終更新日:2026年10月13日
記事監修者:森下 佳宏|BizTech株式会社 代表取締役
GPT-xx、Claude xxのように最新のAIモデルのニュースを見かけることが増えた方も多いでしょう。しかし、「そもそもAIモデルって何?」と疑問に思っている方、または「AIモデルは難しそう」と敬遠している方も多いのではないでしょうか。実はその基本は非常にシンプルです。
この記事では、AIモデルとは何か、アルゴリズムやLLMとの関係、種類、構築手順、評価を解説します。
この記事を読むことで、AIモデルに対する理解が深まるだけでなく、自分自身でAIモデルを構築するする際の指針となるでしょう。
AIシステム開発の基本的な手順や流れについてはこちらの記事で詳しく説明していますので併せてご覧ください。
AI開発会社を自力で選びたい方はこちらで特集していますので併せてご覧ください。
\今年度、AI導入相談増加中!/

目次
AIモデルとは?
AIモデルはAIの中核をなす、特定のタスクを遂行することができるプログラム(いわゆる「脳」の部分)を指します。
AIモデルは膨大なデータから学習することで、未知のデータに対する予測や判断、生成を行うことができるようになります。
例えば、画像認識を得意とするAIモデル、需要を予測するAIモデルなど、多くの分野で専門的なAIモデルが活用されています。
AIモデルの進化
2022年に登場し、世界中を驚かせたChatGPTは、AIモデルの一種であるLLM(大規模言語モデル)を使っています。LLMは、「Language Model」の名の通り、特に「言語」に関するタスクに特化したAIモデルです。
このLLMでは、大量のテキストデータから学習し、人々が使う自然言語を理解・解釈し、自然な言語を生成することができます。これにより、まるで人間のような自然な応答、文章生成、テキストの要約などが可能になっています。
これまで研究されてきた自然言語処理AIモデルの性能を大幅に凌駕したことで、ビジネスでの活用も急激に進みました。
また近年では、言語だけでなく、画像や音声、数値データなど複数の種類の情報を組み合わせて扱うマルチモーダルAIも発展しており、テキストや画像、動画など、データの形式にとらわれずにAI活用をできるようになってきています。
関連記事:「LLMとは?AIエージェントとの連携・導入方法とコスト・代表的モデル・活用相談事例を解説」
関連記事:「マルチモーダルAIとは?代表モデル・活用メリット・ビジネス活用事例や相談事例を解説」
貴社ニーズに特化したAI開発に強い開発会社の選定・紹介
今年度AIシステム開発相談急増中!紹介実績1,000件超え!
・ご相談からご紹介まで完全無料
・貴社に最適な会社に手間なく出会える
・AIのプロが貴社の代わりに数社選定
・お客様満足度96.8%超
・画像認識、予測、LLM等、AI全対応
完全無料・最短1日でご紹介 AI開発に強い会社選定を依頼する
AIモデルとアルゴリズムの違いとは?
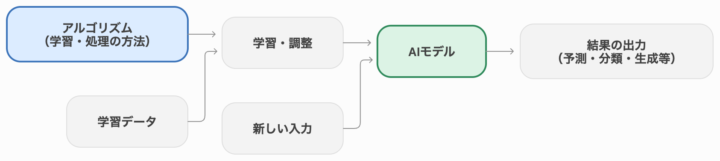
AIの世界では、「AIモデル」と「アルゴリズム」という2つの用語が頻繁に使用されますが、違いとしては、アルゴリズムは学習や処理の「方法」であり、AIモデルはアルゴリズムを用いて、データを元に学習・調整され、入力に応じて結果を出力するための仕組みと捉えるとわかりやすいでしょう。
| 用語 | 意味 |
|---|---|
| アルゴリズム | データから学習したり、情報を処理したりするための方法 |
| AIモデル | アルゴリズムを用いてデータから学習・調整され、入力に応じて結果を出す仕組み |
例えば、ランダムフォレストと呼ばれる学習に使うアルゴリズムを用いて、過去の顧客データを学習し、新しい顧客の解約可能性を予測できるようになったプログラムが、学習済みのAIモデルに当たります。
AIモデルの主な種類と用途
AIモデルは、入力からどのような結果を出すか、という軸で整理できます。代表的な用途は、分類・認識、数値の予測、文章や画像の生成です。
| 主な用途 | 出力する結果 | 例 |
|---|---|---|
| 分類・認識 | 対象の種類や特徴を判定する | 画像からの不良品検知、メールのスパム判定 |
| 数値の予測 | データを基に数値を予測する | 商品の販売数や電力需要の予測 |
| 生成 | 入力に応じて新しい内容を作る | 文章の作成、画像生成 |
尚、画像認識AIモデルなどが「識別」、データ分析AIが「予測」等を得意とする一方、LLMのように「生成」を得意とするAIが、総称して「生成AI」と呼ばれています。
関連記事:「生成AIとは?種類や使い方、メリット、企業での活用方法まで徹底解説!相談事例も紹介」
AIモデルの代表的な学習の種類
AIモデルは、いろいろな学習方法があります。下記では、代表的な学習手法と、その手法を用いた活用例を紹介します。(活用例については、あくまで代表的なものを記載した形であり、必ずその学習方法が取られているというものではありません。)
| 種類 | 学習方法 |
|---|---|
| 教師あり学習 | 入力データと、それに対応する正解 |
| 教師なし学習 | 正解ラベルのないデータ内の傾向や関係 |
| 強化学習 | 行動の結果として得られる報酬 |
教師あり学習モデル
教師あり学習モデルは、答えが分かっている問題を学びます。少し専門的な言い方をすると、ラベル付きのデータを用いて学習するモデルです。
例えば、スパムメールかどうかを判断するとき、このモデルは以前に分類されたスパムメールと普通のメールを見て学びます。その後、新しいメールがスパムかどうかを高い確率で当てることができます。
他にも、外観検査などで、傷や汚れのある不具合画像を学習することで、新しい製造品に対しての不具合を検知するシステムなどでも多く用いられています。
教師あり学習モデルが広く用いられる理由は、高い精度で予測や分類が可能なためです。その精度の高さから、多くのビジネスや研究で採用されています。
なお、前述したLLMの開発においても、教師あり学習は使われます。質問と望ましい回答の教師データを使い、最適な回答ができるようモデルを調整しています。(ただし、LLM開発では、自己教師あり学習や、事後学習での強化学習なども用いられています。)
関連記事:「教師あり学習とは?教師なし学習との違い・代表的アルゴリズムと活用方法を解説」
教師なし学習モデル
教師なし学習モデルは、答えが分かっていない問題に挑戦します。教師なし学習モデルは、ラベルのないデータからパターンを見つけ出します。
例えば、お店でよく買い物をする人たちがどんな商品を好むのかを見つけ出します。答えは最初からありませんが、このモデルが人々の買い物データを分析することで、新しい商品の提案などができます。
教師なし学習モデルが注目される理由は、未知のデータに対しても有用な知見を提供できる点です。
例えば、上記のように似た購買傾向の顧客をまとめる顧客セグメンテーションや、工場の設備から温度・振動・電流等のデータを取得し、通常値やデータ同士の関係から大きく外れた異常値を検出する異常検知などに利用されます。
関連記事:「機械学習とは?AI・ディープラーニングとの違いや、教師あり・教師なし・強化学習のアルゴリズムを解説」
強化学習モデル
強化学習モデルは、行動の結果として得られる報酬を手がかりに、試行錯誤を通じて行動の選び方を学びます。
例えば、ゲームのAIがこのモデルを使っています。最初は下手でも、何度もゲームを繰り返すことで、人間のプレイヤーに勝てるようになります。
他にも、近年注目されているフィジカルAIなどの分野において、物を掴んだり置いたりする動作の学習や、LLMにおいて、人間が回答を評価した結果を学習に活用して、望ましい応答へ調整するRLHFも強化学習が用いられています。
なお、強化学習では、環境の変化を予測する「世界モデル」を組み合わせ、将来の状態を見込みながら行動を選ぶ方法もあります。
関連記事:「AIの強化学習とは?世界モデルとの関係・アルゴリズム・活用事例を解説」
関連記事:「世界モデルとは?仕組み・従来型AIとの違い・メリット・現状課題を解説」
関連記事:「AIエージェントとは?生成AIとの違い・自律的に動く仕組み・種類・導入リスクを徹底解説!」
参照:Google DeepMind|Learning by playing
参照:OpenAI|Learning to summarize with human feedback
貴社ニーズに特化したAI開発に強い開発会社の選定・紹介
今年度AIシステム開発相談急増中!紹介実績1,000件超え!
・ご相談からご紹介まで完全無料
・貴社に最適な会社に手間なく出会える
・AIのプロが貴社の代わりに数社選定
・お客様満足度96.8%超
・画像認識、予測、LLM等、AI全対応
完全無料・最短1日でご紹介 AI開発に強い会社選定を依頼する
理解しておきたい基盤モデル
ここまで、AIモデルの概要や、AIモデルの学習手法について解説しましたが、近年のAIモデルは、独自で構築することもありますが、基盤モデルを利用することも増えています。
基盤モデルとは、大量のデータで事前学習され、さまざまな用途に応用できるAIモデルであり、LLMはその代表例と言えます。GPT-xx、Claude xxなどのモデルはまさに基盤モデルです。
企業がAIを活用する際、これまでは独自のAIモデルを構築することが多くありましたが、近年では、必ずしもモデルを一から構築する必要は少なくなってきています。
既存の基盤モデルを選び、指示の与え方を工夫したり、社内文書を検索・参照する仕組み(RAG)と組み合わせたりして、独自モデルを構築しなくてもビジネスで活用できるようになっています。
用途に応じて、主にモデルの重みやパラメータが公開され、独自にカスタマイズ可能なオープンウェイトなモデルをファインチューニングする方法もありますが、多くのケースでは、その必要はありません。
例えば、社内規程に関する質問に答えるシステムなら、基盤モデルに必要な規程を検索して渡し、その内容を踏まえて回答を生成させるシステムも構築できます。
関連記事:「基盤モデルとは?新たなAI開発の形?代表モデル・導入方法・メリット・選び方の重要性について解説」
参照:Stanford CRFM|Reflections on Foundation Models
AIモデルの構築手順
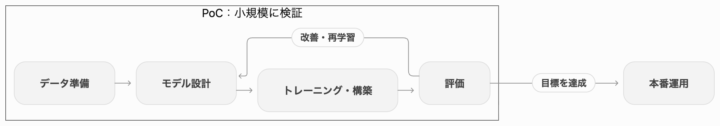
下記では、基盤モデルを活用せずに、独自のAIモデルを構築する基本的な手順について説明します。基盤モデル等も含めた、AIシステム開発の詳細については、下記記事で詳しく解説しています。
関連記事:「AI開発の進め方は?構想・PoC・実装・運用の4フェーズと生成AI時代の注意点を徹底解説」
なお、下記の一連の流れを小規模で行い、検証を行うことがPoCと呼ばれます。
PoCを通して、求めている精度が満たせる場合で、またビジネスインパクトもあると判断できる場合は、より大規模なデータを活用したトレーニング(必要に応じて)を行い、本番運用に耐えられるAIモデルへと調整を行ったり、周辺システムの開発を行ったりしていきます。
PoCの必要性と作業方法詳細をこちらの記事で詳しく説明していますので併せてご覧ください。
データセットの準備とアノテーション
AIモデルを作る最初のステップは、データセットの準備です。データセットの準備は、AIモデル開発の成功において極めて重要なステップです。
例えば、天気予報のAIを作るなら、過去の気温や湿度、風速などのデータが必要です。このデータがAIモデルの「教科書」のようなもので、これを使って学習します。
まず、データの質と量を確保する必要があります。
- データの質:ノイズが少なく、目的変数に対して有用な特徴量を多く含むデータ
- データの量:一般的にデータが多ければ多いほど、モデルの性能は向上しますが、過学習のリスクも考慮する必要があります。
次に、データセットが均衡しているかどうかを確認します。例えば、クラス分類問題において各クラスのデータが偏っていると、モデルが一部のクラスに過度に適合してしまう可能性があります。
アノテーションについては、特に教師あり学習においては不可欠です。アノテーションの精度が低いと、モデルの性能も低下します。
アノテーション作業は専門家が行う場合や内製で行う場合もあります。どちらにせよ、アノテーションの一貫性と正確性を確保する仕組みが必要です。
アノテーションの作業方法、必要性をこちらの記事で詳しく説明していますので併せてご覧ください。
また、データのプライバシーとセキュリティも重要な考慮点です。個人情報を含むデータを使用する場合は、その取り扱いに最新の法的規制に準拠する必要があります。
欠損値の処理やデータ形式の統一など、学習に使える形へ整える作業もこの段階で実施します。
モデルの設計
データが準備できたら、次はAIモデルの設計です。これは、AIがどのように学習するかの「プラン」を作る作業です。例えば、猫を検出する画像認識のAIなら、どのように画像の中の猫を見つけるか、その方法を決めます。
モデルの設計では、問題の性質に応じて以下を選定します。
| 作業 | 作業内容 |
|---|---|
| アルゴリズム | 分類問題であれば以下などが候補になります。
|
| ハイパーパラメータ | 例えば、ランダムフォレストの場合は、木の数や木の深さなどのハイパーパラメータを設定します。 |
| 評価指標 | 以下のような問題に応じた評価指標を選定します。
|
モデルのトレーニング・構築
設計したAIモデルを実際にデータで訓練し、モデルを構築します。この段階でAIは学習を重ねていきます。
トレーニングでは、できる限り多く、且つ正確なデータを用いてモデルを訓練します。
例えば教師あり学習では、学習データを入力して予測と正解のずれを損失関数で数値化し、その値が小さくなるようモデルのパラメータを調整します。
その後、学習に使っていない画像を用いて、猫を正しく認識できるか確かめる評価工程へと進みます。
関連記事:「AIの開発環境に必要なのは?必須のハードウェア・ソフトウェア、構築手順を徹底解説!」
AIモデルの評価と改善(再学習)
評価の工程では、実際にAIモデルが求める品質に達しているかどうかを検証していきます。
AIモデルの性能を評価するためには、いくつかの「評価指標」が用いられます。
例えば、画像認識タスクでは「正確度(Accuracy)」や「F1スコア(F1 Score)」が重要な指標となります。これらの指標は、モデルのパフォーマンスを定量的に評価するための基盤となります。
また、近年では「XAI(説明可能なAI)」の観点からも評価が重要視されています。XAIとは、AIの判断プロセスを人間が理解しやすくする技術のことを指します。
例えば、画像認識モデルが猫と判断した理由を視覚的に示すヒートマップを表示することで、AIの動作を透明化する試みが行われています。
求める精度に達していない場合は、データやモデルを見直して再学習し、モデルの精度を改善していきます。例えば、特定の画像で誤判定が多ければ、そのような画像を学習データに加えたり、モデルの設計を変更したりして、再評価を実施します。
本番運用後は、MLOpsの取り組みとして、入力データの変化(データドリフト)や性能の低下を監視します。
必要に応じて新しいデータを用いて再学習し、モデルの性能を維持・改善していきます。
AIモデル作成の内製化、外注のどちらかで決めかねている場合はこちらの記事をご覧ください。
貴社ニーズに特化したAI開発に強い開発会社の選定・紹介
今年度AIシステム開発相談急増中!紹介実績1,000件超え!
・ご相談からご紹介まで完全無料
・貴社に最適な会社に手間なく出会える
・AIのプロが貴社の代わりに数社選定
・お客様満足度96.8%超
・画像認識、予測、LLM等、AI全対応
完全無料・最短1日でご紹介 AI開発に強い会社選定を依頼する
AIモデルについてよくある質問まとめ
- AIモデルとアルゴリズムは何が違いますか?
アルゴリズムは学習や処理の方法です。
AIモデルは、その方法を用いてデータから学習・調整され、入力に応じて予測や生成などの結果を出す仕組みです。
- AIモデルにはどのような種類がありますか?
出力で分けると、画像や文章を判別する「分類」、需要などを見積もる「予測」、文章や画像を作る「生成」などがあります。
学習方法によっても、教師あり学習、教師なし学習、強化学習などに分けられます。
まとめ
この記事では、AIモデルの基本から種類、構築手順、評価に至るまで幅広く解説しました。AIモデルは日々進化しており、ビジネスや研究、さらには私たちの日常生活にも多大な影響を与えています。しかし、その進化のスピードについていくためには、正確な知識と理解が不可欠です。
特に、独自AIモデルの構築を考えている方にとっては、データセットの選定やモデルの評価といった基本的なステップが非常に重要です。
AIシステムを自社で開発する際の流れをこちらの記事で詳しく説明していますので併せてご覧ください。
AIモデルの進化は止まりません。だからこそ、今後も学び続け、適切な行動を取ることが求められます。この記事が、その一歩となるような知識と洞察を提供できたら幸いです。
AI Market 運営、BizTech株式会社 代表取締役|2021年にサービス提供を開始したAI Marketのコンサルタントとしても、お客様に寄り添いながら、現場のお客様の課題ヒアリングや企業のご紹介を5年以上実施しています。これまでにLLM・RAGを始め、画像認識、データ分析等、1,000件を超える様々なAI導入相談に対応し、参加累計8,000人を超えるAIイベントを主催。AIシステム開発PM歴8年以上。AI Marketの記事では、AIに関する情報をわかりやすくお伝えしています。(JDLA GENERAL 資格保有)
▶ 監修者の実績・経歴を詳しく見る
AI Market 公式𝕏:@AIMarket_jp
Youtubeチャンネル:@aimarket_channel
TikTok:@aimarket_jp
運営会社:BizTech株式会社
掲載記事に関するご意見・ご相談はこちら:ai-market-contents@biz-t.jp
お電話で無料相談

