

Embedding(埋め込み表現)とは?LLM・RAGでの必要性・活用事例6選・実装手順を徹底解説!
最終更新日:2026年10月01日
記事監修者:森下 佳宏|BizTech株式会社 代表取締役
- Embeddingはテキストや画像、音声などの非構造データを数値ベクトルに変換し、データの意味的関連性を保持したまま計算や分析を可能にする技術。
- 他のベクトル化手法と比べ、Embeddingは文脈や意味を考慮できるため、検索精度やAIモデルの学習効率を高め、RAGやAI検索、多言語翻訳など幅広い分野で活用されている。
- Embeddingモデルの実装は、データ準備からEmbedding生成、ベクトルデータベースへの保存、類似度検索、評価、デプロイまでのステップで行われ、効率的なデータ処理と高精度な情報検索を実現する。
ChatGPTに代表されるLLM(大規模言語モデル)が広く普及したことで、自然言語処理(NLP)の技術が注目されています。
その中でも、自然言語処理やLLMの中で特に注目を集めているのが「Embedding(埋め込み表現)」と呼ばれる技術です。言葉や画像、音声をコンピュータが理解できる形に変換するEmbeddingが、RAGによるLLMの拡張活用や、検索エンジンの精度向上などに活用されており、今後AIを導入したり開発したりする上で、Embeddingは避けては通れない技術と言えます。
この記事では、Embedding(埋め込み表現)の概要や必要性、活用事例、他のベクトル化手法との違い、実装手順を解説します。Embeddingがどんな仕組みでどんな技術なのかをまとめた内容となっているため、Embeddingを全く知らない方でも理解して頂けるでしょう。
LLM・RAG開発が得意なAI開発会社について知りたい方はこちらで特集していますので、併せてご覧ください。
目次
Embedding(埋め込み表現)とは?
Embedding(エンベディング:埋め込み表現)とは、言語データや画像データ、音声データなどをコンピュータが理解しやすい数値形式に変換する手法で、データを数値のベクトルに変換するベクトル化手法の一つを指します。自然言語処理や機械学習の分野において、重要な技術とされています。
例えば、「おはようございます」を[-0.024, 0.039, 0.091, …]、「こんばんは」を[0.012, -0.042, 0.067, …]のように表現する形です。
Embeddingを行う必要性
Embeddingの利点は、データの抽象的な意味を捉えることで、コンピュータが単なる文字列としてではなく、意味のある情報としてデータを扱えるようになることです。
結果として、検索エンジンやチャットボットといった多様なアプリケーションで正確な処理を実現することができるようになります。
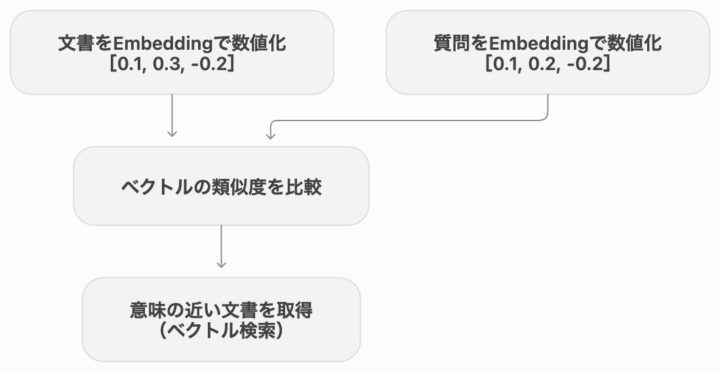
Embeddingは以下の理由で重要です。
- 意味的関連性の抽出
- 数値表現によるデータ処理
自然言語処理では、テキストを数値ベクトルで表現することで、意味に基づく比較や分類に活用できます。画像や音声も、それぞれの特徴をベクトルとして表現し、分析に利用できます。
意味の近い単語や文章を近いベクトルとして表現することで、意味的な関連性を数値で比較できます。この仕組みを利用し、関連する文書を探すのがベクトル検索です。RAGにおいても、ベクトル検索で取得した文書をLLMに参照させ、回答の生成に活用します。
ベクトル検索とテキスト検索の違い
Embeddingを使ったベクトル検索は、質問と文書の意味の近さをもとに情報を探します。一方、テキスト検索は、入力した単語と文書内の単語の一致などをもとに検索します。
主な違いは以下の通りです。
| 比較項目 | ベクトル検索 | テキスト検索(キーワード検索) |
|---|---|---|
| 検索の仕組み | Embeddingでベクトル化し、意味の近さを比較 | 単語の一致や出現頻度などを比較 |
| 異なる言い回し | 意味の近さをもとに検索 | 同義語辞書や検索語の拡張で対応 |
| 検索例 | 「パスワードを忘れた」から「ログイン情報の再設定」を検索 | 「製品番号ABC-123」を含む文書を検索 |
| 適した用途 | 社内文書・FAQの検索、文章での質問 | 製品コード・固有名詞・特定の単語の検索 |
| 主な準備 | モデル選定、文書のベクトル化・保存 | 単語を検索するための索引作成 |
| 注意点 | 意味の近さと回答の正しさは別 | 単語の一致と質問意図への適合は別 |
関連記事:「ベクトル検索とは?仕組み・LLMでの役割・実装方法・活用事例を徹底解説!」
Embeddingの仕組み
Embeddingモデルにデータを入力すると、その特徴を表す数値ベクトルが出力されます。意味や特徴の近いデータを近いベクトルとして表現することで、データ間の関連性を数値で比較できるようになります。
モデルが学習した特徴に基づいて数値化する
Embeddingモデルは、学習したパターンに基づいて、単語や文章などを数値ベクトルに変換します。
例えば上述したように、「おはようございます」を[-0.024, 0.039, 0.091, …]、「こんばんは」を[0.012, -0.042, 0.067, …]のように表現します。
Word2Vecのように単語ごとに決まったベクトルを割り当てるモデルと、BERTのように前後の文脈に応じて表現を変えるモデルなどがあり、同じ文章でも、使用するモデルが異なれば、出力されるベクトルも変わります。
データの特徴を複数の次元で表現する
ベクトルは複数の数値で構成され、この数値の個数を「次元数」と呼びます。例えば、[0.1, -0.2, 0.3]は3次元のベクトルです。
モデルは、複数の次元を使ってデータの特徴を表現します。それぞれの数値が「明るさ」「感情」など、人が理解できる特定の意味に一対一で対応するとは限りません。
次元数はモデルや設定によって決まります。次元数を減らせるモデルでは、保存容量や比較時の計算量を抑えられますが、表現できる情報や精度にも影響します。
ベクトルの方向から類似度を計算する
生成されたベクトル同士の関連性を比較する指標の一つが、コサイン類似度です。2つのベクトルがなす角度をもとに、方向がどれだけ似ているかを計算します。
値は-1から1の範囲を取り、1に近いほど方向が似ています。Embeddingでは、この指標を使ってデータの意味や特徴の近さを比較します。
比較するベクトルには、同じベクトル空間で扱えるモデルと設定を使用します。
LLM×RAGに強い会社の選定・紹介を行います
今年度RAG相談急増中!紹介実績1,000件超え!
・ご相談からご紹介まで完全無料
・貴社に最適な会社に手間なく出会える
・AIのプロが貴社の代わりに数社選定
・お客様満足度96.8%超
完全無料・最短1日でご紹介 LLM×RAGに強い会社選定を依頼する
Embeddingの種類と代表的なモデル
Embeddingには、単語や文章、画像、音声など、扱うデータや表現方法に応じた種類があります。
以下の表で、代表的なモデル・手法と、それぞれの特徴や用途を整理します。
| 種類 | 代表的なモデル・手法 | 特徴・主な用途 |
|---|---|---|
| 単語Embedding | Word2Vec GloVe fastText | 単語をベクトルで表現する基本的な手法。同じ単語には基本的に同じベクトルを割り当てる。 |
| 文脈に応じたEmbedding | ELMo BERT | 前後の文脈に応じて単語の表現を変える。文章検索に利用する場合は、文章全体の表現を得る方法や追加学習も検討する。 |
| 文章Embedding(API) | text-embedding-3-small text-embedding-3-large(OpenAI) | 文章をベクトルに変換するAPIモデル。文書検索、分類、類似度判定などに利用する。 |
| 文章Embedding(自社環境での実行) | Sentence-BERT Qwen3-Embedding-0.6B/4B/8B | 公開モデルを自社環境で実行する選択肢。対応言語、必要な計算資源、ライセンスはモデルごとに確認する。 |
| 画像Embedding | ResNetなどの画像特徴抽出モデル CLIP | 画像の特徴をベクトルで表現する。CLIPは画像とテキストを共通の空間で扱い、文章から画像を検索する用途にも利用できる。 |
| 音声Embedding | wav2vec 2.0 CLAP | 音声の特徴表現を音声認識や分類などに利用する。CLAPは音声とテキストの関連性も扱う。 |
| マルチモーダルEmbedding | Gemini Embedding 2 embed-v4.0(Cohere) | Gemini Embedding 2はテキスト、画像、音声、動画、文書に対応。Cohere Embed v4はテキスト、画像、画像とテキストが混在する文書などに対応する。 |
上記は代表例であり、分類には重なりがあります。企業が選ぶ際は、対応するデータ形式、日本語での検索品質、APIと自社環境での実行のどちらを利用するか、費用やライセンスを確認しましょう。
参照:OpenAI|Vector embeddings
参照:Qwen|Qwen3 Embedding
参照:Google|エンベディング
参照:Cohere|Embed Models
Embeddingと他のベクトル化手法との違い
Embedding(埋め込み表現)は他のベクトル化と比較して、特定の目的に応じた高度な表現力を持つ点が特徴です。ここでは、一般的なベクトル化手法として知られるワンホットエンコーディング、TF-IDF(Term Frequency-Inverse Document Frequency)と比較します。
ワンホットエンコーディング
ワンホットエンコーディングとは、ダミー変数を用いてベクトル化する表現方法です。このベクトル化は1か0のフラグを作成するシンプルな手法で、特定の次元に該当するかどうかをカテゴライズします。簡潔な仕組みですが、単語間の意味的な関連性を捉えることができず、データのスパース性(疎性)も問題になります。
TF-IDF
TF-IDF(Term Frequency-Inverse Document Frequency)は、文書内の単語の出現頻度と、文書集合全体での出現状況を使って重みを付ける手法です。単語の重要度を表現できますが、それ自体では単語の意味や語順をモデル化しません。
これらの手法に対し、Embeddingには以下の特徴があります。
- 学習した意味や特徴をベクトルで表現できる
- 前後の文脈を反映できる
- テキスト以外に、画像や音声などにも利用できる
- 類似度検索、分類、クラスタリングなどに活用できる
ただし、Embeddingがすべての検索に適しているわけではありません。
製品コードや固有名詞の完全一致が重要な場合は、キーワード検索が有効です。両者を組み合わせるハイブリッド検索も選択肢になります。
Embeddingの技術的活用例6選
Embeddingはさまざまな分野で応用されています。ここでは、代表的な活用例として以下を紹介します。
LLM・RAGの中核機能
RAG(検索拡張生成)は、外部の情報を検索し、その内容を参照してLLMが回答を生成する仕組みです。ベクトル検索を使うRAGでは、Embeddingが質問に関連する文書を見つける役割を担います。
あらかじめ社内文書などを分割してベクトル化し、検索できる状態で保存します。質問も対応するEmbeddingモデルでベクトル化し、類似度に基づいて関連する文書を取り出します。
検索対象は、LLM内部の学習データではなく、別途用意した文書やデータベースです。検索後は、取り出した文書の本文と質問をLLMに渡して回答を生成します。
RAGの品質はEmbeddingモデルだけで決まるものではありません。文書の分割方法、検索件数、キーワード検索との組み合わせ、検索結果の再評価なども重要です。
RAGを支える技術やツールとして、Embedding以外に以下が挙げられます。
| 分類 | 技術・ツール | 概要 |
|---|---|---|
| フレームワークとライブラリ | LangChain | RAGを含む様々なLLMアプリケーションの開発を支援するライブラリ |
| LlamaIndex | RAGパイプラインの構築を簡素化するフレームワーク | |
| 基盤技術 | ベクトル検索 | 埋め込みベクトル間の類似性に基づく検索手法 |
| データ前処理 | RAGチャンク | 文書を適切なサイズに分割する技術 |
| 検索最適化技術 | Hybrid Search | ベクトル検索とキーワード検索を組み合わせた手法 |
| Rerankモデル | 検索結果を再評価し、より関連性の高い順に並べ替える技術 | |
| クラウドサービス | Azure AI Search | Microsoftが提供する高度な検索サービス |
関連記事:「RAG(検索拡張生成:Retrieval-Augmented Generation)とは?LLMでの活用方法・事例・メリット・導入の注意点まで徹底解説!」
関連記事:「RAG精度の壁とは?チューニングする戦略・具体的検討方法を徹底解説!」
テキスト生成を支える数値表現
LLMでは、入力された言葉をEmbeddingによって数値で表現し、文章生成のための処理に利用します。モデルは、この表現をもとに文脈や単語間の関係を処理し、続くトークンを予測して文章を生成します。
質問への回答、文章作成、要約など、文脈を踏まえたテキスト生成を支える基盤として活用されています。
AIモデルのトレーニング
Embeddingは、データの特徴を数値で表現し、AIモデルの学習に活用されます。例えば、文章をベクトル化して分類モデルに学習させることで、問い合わせの振り分けや文書のカテゴリ分類などに利用できます。
LLMなどの生成AIの学習でも、Embeddingは言葉の特徴を表す基盤となります。モデル内部のEmbeddingを学習によって調整し、目的のタスクに適した表現を獲得します。
関連記事:「生成AIとは?種類や使い方、メリット、企業での活用方法まで徹底解説!」
AI検索の精度向上
Embeddingは、ベクトル検索を実現し、AI検索システムの精度向上にも貢献します。検索エンジンがユーザーのクエリに対して関連性の高い結果を返すためには、クエリと検索対象のデータに意味的な関連性があるかを正確に理解する必要があります。
Embeddingは単語や文章などのデータをベクトル化し、それらの意味的な近さを定量化します。これにより、ユーザーが入力したクエリと類似の意味を持つ文書や回答を高い精度で検索することが可能です。
従来のキーワードベースの検索では難しかった同義語や異なる言い回しの理解も、Embeddingを活用することで克服され、より直感的で正確な検索結果が得られます。
検索システムの精度向上は、エンタープライズサーチの分野でも活用されています。
また、画像の視覚的特徴をベクトル化し、類似画像検索や画像分類に応用されます。例えば、商品検索アプリでは、商品の画像情報をベクトル化して検索精度を向上させることができます。
関連記事:「ChatGPTの回答精度を上げる方法は?RAGの活用方法・プロンプト設計のコツも徹底解説!」
音声認識の精度向上
音声データのEmbeddingは、音声認識や音声分類に利用されます。音声データを数値ベクトルに変換することで、音声の特性を捉えやすくし、認識精度を向上させます。
関連記事:「AIによる音声認識の仕組みとは?何ができる?技術や企業の活用事例を徹底解説!」
多言語翻訳
Embeddingでは、各言語の単語やフレーズを適切に対応させるプロセスをサポートし多言語の翻訳も可能です。Embeddingを利用することで、異なる言語の単語を共通のベクトル空間にマッピングし、意味の類似性や文脈を理解できます。
例えば、英語の「Cat」という単語と、日本語の「猫」という単語をEmbeddingでベクトル化すると、それぞれのベクトルが近い位置に配置されるため、意味的な配置関係が明確になります。このようにして、異なる言語間で意味が一致する単語やフレーズを効果的に結びつけることができるため、多言語を翻訳できるのです。
さらに、Embeddingによって多言語モデルのトレーニングも効率的に行うことが可能で、1つのモデルで複数の言語に対応した翻訳を提供できます。複数の言語間で一貫性のある翻訳が実現され、多言語環境におけるコミュニケーションがより円滑になります。
LLM×RAGに強い会社の選定・紹介を行います
今年度RAG相談急増中!紹介実績1,000件超え!
・ご相談からご紹介まで完全無料
・貴社に最適な会社に手間なく出会える
・AIのプロが貴社の代わりに数社選定
・お客様満足度96.8%超
完全無料・最短1日でご紹介 LLM×RAGに強い会社選定を依頼する
Embeddingモデルの実装方法7ステップ
Embeddingモデルを用いたシステムの実装方法について、以下のステップで説明します。
- データの準備
Embeddingを作成するためのデータを準備します。例えば、特定のトピックに関する記事を取得し、データフレームに変換します。
この際、不要なセクション(脚注や出典など)は除外します。 - トークン数の計測
データをEmbeddingに変換する前に、テキストのトークン数を計測します。これは、モデルが処理できる最大トークン数を超えないようにするためです。 - Embeddingの作成
OpenAIのAPIなどを使用して、テキストデータからEmbeddingを作成します。モデルを指定して、テキストデータをトークン化し、Embeddingを生成します。 - ベクトルデータベースへの保存
作成したEmbeddingは、Chromaなどのベクトルデータベースに保存します。これにより、後で類似度検索などに利用できます。 - 類似度検索の実行
保存したEmbeddingを用いて、ユーザーからのクエリに対して類似度検索を行います。これにより、関連性の高い文書や情報を効率的に取得できます。
必要に応じて、モデルを特定のタスクに対してファインチューニングします。 - 評価とチューニング
生成したEmbeddingの品質を評価し、必要に応じてハイパーパラメータを調整します。評価には、類似度計算やクラスタリングなどの手法が用いられます。 - デプロイメント
最終的に、トレーニング済みのモデルをデプロイし、実際のアプリケーションで使用します。デプロイには、クラウドサービスやオンプレミスのサーバーを利用することが一般的です。
関連記事:「AI開発の基本からAIシステム構築の手順や流れを徹底解説!失敗しないための注意点も紹介」
Embeddingについてよくある質問まとめ
- Embeddingとは何ですか?
Embedding(埋め込み表現)とは、言語データや画像データをコンピュータが理解しやすい形式に変換する技術です。特に自然言語処理におけるLLM・RAGや機械学習の分野において、重要な概念とされています。
- Embedding技術はどのように活用されていますか?
Embeddingは、以下のような技術的活用がされています。
- LLM・RAGの性能向上
- テキストの生成
- 機械学習モデルのトレーニング
- AI検索の精度向上
- 多言語翻訳
- Embeddingの実装は難しいですか?初心者でも取り組めますか?
Embeddingの実装難易度は、使用するツールやライブラリによって異なります。初心者の方でも、TensorFlowやPyTorchなどの機械学習ライブラリを使用すれば、比較的簡単にEmbeddingを実装できます。
また、OpenAIのAPIなど、事前学習済みのモデルを利用することで、さらにハードルを下げることができます。ただし、効果的なEmbeddingを作成するには、データの前処理やモデルのチューニングなど、一定の知識と経験が必要です。
まずは簡単なテキスト分類タスクから始め、徐々に複雑なタスクに挑戦していくことをおすすめします。オンラインのチュートリアルや実践的な課題に取り組むことで、着実にスキルを向上させることができるでしょう。
まとめ
Embeddingは自然言語処理、特にLLMとRAGにおいて中核的概念です。言語の壁を越え、画像や音声を理解し、より賢明な検索を可能にする可能性は注目です。
本記事で学んだ知識を活かし、あなたのプロジェクトやビジネスにEmbeddingを取り入れてみてはいかがでしょうか。
AI Market 運営、BizTech株式会社 代表取締役|2021年にサービス提供を開始したAI Marketのコンサルタントとしても、お客様に寄り添いながら、現場のお客様の課題ヒアリングや企業のご紹介を5年以上実施しています。これまでにLLM・RAGを始め、画像認識、データ分析等、1,000件を超える様々なAI導入相談に対応し、参加累計8,000人を超えるAIイベントを主催。AIシステム開発PM歴8年以上。AI Marketの記事では、AIに関する情報をわかりやすくお伝えしています。(JDLA GENERAL 資格保有)
▶ 監修者の実績・経歴を詳しく見る
AI Market 公式𝕏:@AIMarket_jp
Youtubeチャンネル:@aimarket_channel
TikTok:@aimarket_jp
運営会社:BizTech株式会社
掲載記事に関するご意見・ご相談はこちら:ai-market-contents@biz-t.jp
お電話で無料相談

