

RAG(検索拡張生成)とは?LLMとの連携シーン・メリット・システム構築の注意点を徹底解説!
最終更新日:2026年09月16日
記事監修者:森下 佳宏|BizTech株式会社 代表取締役
ChatGPTをはじめとするLLM(大規模言語モデル)だけでは、最新の情報、及び企業内部データを反映した正確な文章生成が困難、かつ情報セキュリティの不安があります。
LLMとは?どんな種類がある?こちらの記事で詳しく説明していますので併せてご覧ください。
こうした課題への対策として注目されているのが「RAG(検索拡張生成:Retrieval-Augmented Generation)」です。LLMと外部の情報源を組み合わせ、社内データや最新情報を参照した回答を生成できることから、企業での活用が進んでいます。
本記事では、基本的な仕組みやメリット・デメリット、ビジネスでの活用方法、構築手順、導入後に陥りやすい運用課題とその対策を紹介します。
社内データや外部情報を生成AIで活用したい企業担当者は、ぜひ参考にしてください。
LLM・RAG開発が得意なAI開発会社について知りたい方はこちらで特集していますので、併せてご覧ください。
目次
RAG(検索拡張生成)とは?
RAGとは、Retrieval-Augmented Generationの略称で、外部情報源から取得した情報をLLMへ渡し、その内容に基づく回答を生成する技術です。
簡単に言えば、AIが「本を調べてから答える」ように動作するシステムと考えることができます。現在、ChatGPT等のLLMと組み合わせた活用が進んでいます。
また、エージェンティックRAG(Agentic RAG)による業務自動化や、CAD図面、回路図、フローチャートなどの画像情報も検索対象にするマルチモーダル化も進んでいます。
他にも、機密情報をクラウドへ送らず、社内サーバーやローカル環境で処理するローカルLLMと呼ばれる構成での実装も進んでいます。
なぜLLMの事前学習データだけでは不十分?
LLMは事前学習済みのデータセットに依存するため、最新情報の反映や速やかなアップデートが困難です。また、学習データやユーザーの入力データに社内データ(特に機密情報を含むもの)を使うことは機密情報の漏洩につながるリスクがあります。
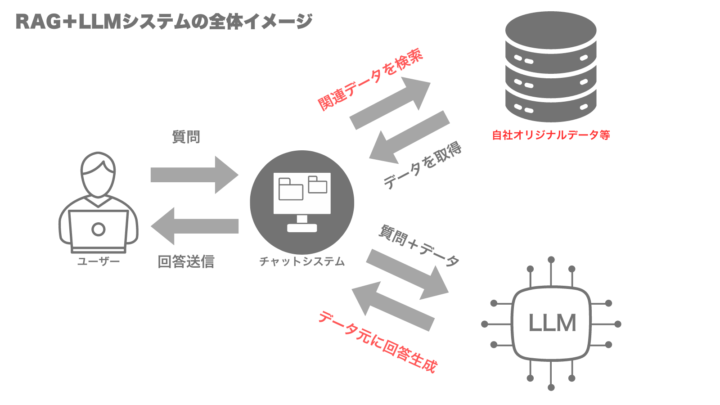
そこで、この技術を活用し、事前学習されていない自社オリジナルのデータが格納されたデータベースからリアルタイムに情報を検索・取得し、そのデータをLLMの回答生成に活用することで、オリジナルデータを踏まえた回答を行うことが可能になります。
オリジナルな回答を行うシステムのイメージは以下のような形です。
関連記事:「LLMとRAGで社内情報検索を効率化!検索・活用における役割やメリット、課題の解決方法」
ファインチューニングとの違い
ファインチューニングは、特定領域に対応した大量の学習データによる追加トレーニングを行う手法で、膨大なコストと時間がかかります。
一方、RAGは、質問に関連する情報を検索し、回答を生成する前に、その情報を質問とともにLLMへ渡す仕組みとなるため、ファインチューニングを行うよりもカスタマイズ工数を削減しつつ、高精度な回答生成を可能とします。
これにより、より低コスト且つスピーディーに独自の回答を行うオリジナルLLMの構築を可能とします。
下記は、RAGを理解する上で非常に重要な論文です。現在進行中で、新しい技術や手法が多く研究・報告されています。
arXiv|Retrieval-Augmented Generation for Large Language Models: A Survey
関連記事:「ファインチューニングとRAGの違い、使い分け方を徹底解説!」
LLM×RAGに強い会社の選定・紹介を行います
今年度RAG相談急増中!紹介実績1,000件超え!
・ご相談からご紹介まで完全無料
・貴社に最適な会社に手間なく出会える
・AIのプロが貴社の代わりに数社選定
・お客様満足度96.8%超
完全無料・最短1日でご紹介 LLM×RAGに強い会社選定を依頼する
なぜ今企業で導入が進んでいるのか?
現代のビジネス環境において、企業競争力の源泉は「どれだけデータを活用し、テクノロジーを業務に組み込めるか」に大きく依存しています。
特に近年では、生成AIを活用した業務効率化やナレッジの利活用が注目されており、生産性向上や働き方改革、さらにはDXの加速といった企業課題の解決に直結する手段として脚光を浴びています。
その中でも、既存の社内データや外部情報を柔軟に組み合わせながら、LLMの弱点を補完し、より信頼性の高い回答生成と実務活用を実現できる点で、多くの企業から注目されています。
単なる検索ツールではなく、組織内に分散した知識を引き出して業務に活かす基盤として、導入を検討する企業が増えています。
社内データが活用されていない
企業内には日々、以下のような情報が蓄積されています。
- 議事録
- 報告書
- 製品マニュアル
- FAQ
- トラブル対応履歴
- ベテラン社員の経験に基づくノウハウや業務のコツ:暗黙知
とりわけ製造業や建設業などでは、熟練工による技術伝承が課題となることも少なくありません。
しかし、こうした情報の多くは検索しづらい形式(非構造化データ)で保管されており、必要なときに必要な情報を活用できない「死蔵データ」となっているのが実態です。
RAGは、自然言語による柔軟な検索と生成を組み合わせることで、こうした埋もれた情報やノウハウを表出化・再活用可能にします。
これにより、社内ナレッジの属人化を防ぎ、技術伝承の効率化や業務標準化の推進といった、経営の基盤強化にもつながります。
関連記事:「ナレッジマネジメントとは?概要・手法・メリット・生成AI(RAG)導入方法を徹底解説!」
従来の生成AI活用の限界
ChatGPTをはじめとするLLMの活用は多くの企業で進んでいますが、実運用ではハルシネーションや最新情報が反映されないことによる信頼性の低下が課題として浮上しています。
特に、法務・医療・製造など正確性が求められる領域では、「間違いを含む自動回答」が重大なリスクにつながりかねません。
RAGは、LLMの出力根拠を社内データや信頼できる情報ソースに紐づけることで、回答の正確性と説明可能性を担保します。これにより、LLMの弱点を補完し、より安全かつ実用的な形での業務活用が可能になります。
関連記事:「ChatGPTの回答精度を上げる方法は?RAGの活用方法・プロンプト設計のコツも徹底解説!」
データドリブン経営の加速
DXやAIによる業務変革において、データに基づいた意思決定は極めて重要なファクターです。しかし、実際には「どのデータを、どう使えば良いか分からない」「導入ツールを使いこなせていない」といった現場の声が少なくありません。
RAGは、自然言語によって直感的に情報を検索・抽出し、その場で活用可能な形で提示できる点で、DXやAX推進の最初の一歩として極めて有効です。
- 業務マニュアルやナレッジを会話形式で引き出し、現場教育を効率化
- 顧客対応履歴から応対内容を自動提案し、CX向上を図る
- 市場データや社内資料から意思決定に必要な要素を抽出し、判断の質を高める
こうした活用により、「データはあるが業務に活かしきれない」という課題の解消が期待できます。
関連記事:「データドリブンについて解説し、導入方法、メリットやビジネスへの活用例」
主要活用シーン比較
単なる社内FAQの高度化に留まらず、企業の意思決定スピードを左右する外部脳へと進化しています。現在のビジネスシーンにおける主要な活用方法を整理しました。
| 活用カテゴリー | 活用内容(ユースケース) | ビジネスメリット |
|---|---|---|
| CX(顧客体験)の変革 | 過去の応対履歴、購買データ、製品マニュアルと連携したパーソナライズ回答やクレームの一次対応 |
|
| 組織知の資産化 |
|
|
| セールス・マーケ支援 |
|
|
| コンテンツ・知財創出 |
|
|
| 法務・コンプライアンス |
|
|
関連記事:「RAG(検索拡張生成)の活用事例は?企業の事例を徹底解説!」
RAGの活用は個別の質問応答からAIエージェントへ
RAGは、社内文書の検索や問い合わせへの回答など、個別の作業を支援する用途で活用されてきました。
近年は、こうした「必要な情報を調べて答える」という点での利用に加え、AIエージェントが進める業務フローの中で、各工程に必要な情報を提供する使い方へと活用が進んでいます。
例えば、問い合わせに回答するだけでなく、内容の確認、対応方針の検討、回答案の作成、対応記録の登録までをつなぐような構成です。その中でRAGは、製品仕様や社内ルール、過去の対応履歴を参照し、各工程の判断や生成を支える技術として利用されます。
個別の質問応答と業務フロー内での活用の違い
RAGの基本的な役割は、検索した情報を生成AIの出力に反映することです。AIエージェントと組み合わせると、その情報を一つの回答にまとめるだけでなく、後続の作業にも引き継げます。
| 比較項目 | 個別の質問応答でのRAG活用 | AIエージェントの業務フロー内でのRAG活用 |
|---|---|---|
| 利用する場面 | 利用者が質問し、必要な情報を確認するとき | 一連の作業の途中で、判断や処理に必要な情報を参照するとき |
| 検索した情報の使い道 | 質問に対する回答や要約を生成する | 対応方針の検討、文書作成、入力内容の確認などに利用する |
| 後続の作業 | 利用者が回答を確認し、次の作業を進める | AIエージェントが取得した情報を引き継ぎ、設定された権限や承認手順に沿って作業を進める |
業務の各工程に必要な知識を提供する
例えば、顧客から製品の不具合について問い合わせがあった場合、RAGを以下のように利用できます。
- AIエージェントが問い合わせ内容を整理し、対象製品や症状を確認する
- RAGで製品マニュアルや過去の類似事例を参照し、原因の候補や確認事項を整理する
- 必要に応じて保証規定や対応手順を参照し、回答案と対応方針を作成する
- 担当者の承認後、連携先のシステムで回答の送信や対応記録の登録を行う
このように、RAGは業務の途中で必要になる知識を補い、情報の確認から実際の対応までをつなぐ役割を担います。送信や登録などの操作は、AIエージェントと外部API・業務システムとの連携によって実行します。
関連記事:「AIエージェントとは?生成AIとの違い・自律的に動く仕組み・種類・導入リスクを徹底解説!」
検索から回答生成までの仕組み
外部情報の検索とLLMによる文章生成を組み合わせる処理は、主に以下のステップで進みます。
尚、必ず以下のステップで進むわけではなく、ベクトル検索を行わないケースもあります。
入力されたクエリのエンコーディング
ユーザーからの質問や要求(クエリ)が入力されると、まず自然言語処理(NLP)技術を用いてクエリを解析します。この解析では、クエリを構成する単語や文章の構造を分析し、その意味や文脈を捉えます。
処理の第一段階は、ユーザーからの入力(クエリ)をベクトル表現にエンコーディングすることです。ベクトル表現に変換する際には、大規模なテキストデータから単語の意味や関係性を学習し、各単語を数値のベクトルで表現します。このベクトル表現は、クエリの意味や文脈を数値的に表現したものです。
この変換されたベクトルは、後段のベクトルデータベースに対して意味検索を行うための、いわば検索キーとしての役割を果たします。
関連記事:「ベクトル検索とは?仕組みやメリット、活用事例を徹底解説」
関連情報の検索
次に、エンコーディングされたクエリベクトルを用いて、ベクトルデータベースから関連する情報を検索します。
ベクトルデータベースには、あらかじめ社内ドキュメントや最新情報がベクトル化され、高速に検索できるようインデックス化されて格納されています。このプロセスにより、LLMがまだ学習していない最新情報や社外秘の内部データにアクセスすることが可能になり、生成される回答の質が向上します。
この検索段階では、ベクトルデータベースのエンジンが、クエリベクトルと格納されている膨大なデータのベクトルとの距離(類似度)を高速に計算し、最も意味的に関連性の高い情報を抽出して提示します。
関連記事:「ベクトルデータベースとは?仕組みやメリット、活用事例を解説」
Agentic RAG
近年は、Agentic RAG(エージェント型RAG)という、AIエージェントが検索の要否や検索先を判断し、取得した情報に応じて処理を調整する技術も活用され始めています。
例えば、質問を複数の問いに分割したり、情報が不足していれば検索語を変更して再検索したりします。
あらかじめ決めた検索を一度実行するだけでなく、回答に必要な情報がそろっているかを確認しながら検索を進められる点が特徴です。検索だけに限定された技術ではなく、取得した情報の評価や回答生成までを含めて処理を制御します。
ただし、検索や生成の反復によって処理時間やコストが増える場合があるため、実行回数の上限や終了条件に注意する必要があります。
関連記事:「Agentic RAGとは?RAGとの違い・特徴・注意点・活用方法を徹底解説!」
マルチモーダルRAG
マルチモーダルRAGは、文章に加え、画像や図表などの情報も検索・参照し、回答の生成に活用する仕組みです。企業で利用されることの多い製品マニュアルの図解や、グラフを含む報告書など、文字情報だけでは内容を捉えにくい資料にも活用できます。
実装方法には、画像の内容を説明文に変換して検索する方法や、画像とテキストを対応するベクトル表現に変換して検索する方法などがあります。取得した画像を、画像入力に対応するモデルへ渡して回答を生成する構成も可能です。
OCRによる文字の読み取りだけでなく、図の内容やレイアウトも扱えるというメリットがあります。
参照:Microsoft|マルチモーダルコンテンツの抽出・分割・検索
ハイブリッド検索
ハイブリッド検索は、従来のキーワード検索の強み(特定の単語やフレーズとの完全一致・部分一致による網羅性や直接性)と、AIを活用したベクトル検索の強み(単語や文章の意味・文脈を理解し、類義語や関連情報を見つけ出す能力)を組み合わせた高度な検索手法です。
RAGの仕組みにおいて、まずユーザーの質問に対し、キーワード検索で関連性の高い候補を広範囲に絞り込み、同時にベクトル検索で質問の意図や文脈に合致する情報を意味的に探索します。
そして、これらの検索結果を統合アルゴリズム(スコアの重み付けやリランキングなど)によって最適化し、最も適切で質の高い情報をLLMに提供します。
リランキングによる検索結果の再評価
リランキングは、検索で取得した候補を、ユーザーの質問との関連性に基づいて再評価し、並べ替える処理です。キーワード検索やベクトル検索で広く候補を集めた後、回答に役立つ情報を優先してLLMへ渡すために利用します。
例えば、同じ製品名を含む資料が複数見つかった場合でも、質問が初期設定についてなのか、不具合の対処についてなのかによって、優先すべき資料は異なります。リランキングでは、質問と候補文書の内容を照合して順位を調整します。
無関係な情報の混入を減らせる一方、追加の処理時間や費用が発生します。また、最初の検索で取得できなかった資料は評価できないため、検索段階で必要な情報を候補に含めることも重要です。
関連記事:「Rerankとは?RAGの検索精度を向上する仕組み・代表モデル・使い方を徹底解説」
抽出した情報の統合と文脈理解
検索で取得した情報は、ユーザーの質問や指示とともにLLMへ入力されます。LLMは、質問と参照情報の関係を捉え、回答に必要な内容を整理します。
複数の文書を参照する場合は、文書名や更新日、出典なども渡すことで、情報の背景や適用条件を踏まえた回答につなげられます。
自然な応答の生成
文脈理解の結果を基に、LLMは自然言語での応答を生成します。この応答生成では、LLMの言語生成能力が活かされ、文法的に正しく、かつ文脈に即した自然な文章が生成されます。
生成された応答は、ユーザーに提示される前に、さらなる後処理が行われる場合があります。例えば、応答の文体を調整したり、不適切な内容をフィルタリングしたりすることで、より質の高い応答を提供できます。
検索と生成の反復によるインタラクティブな対話
検索と生成を反復することで、追加の質問にも対応できます。新たな要求を受けると、関連情報を再検索し、その内容に基づいて回答を生成します。
この反復プロセスにより、RAGはユーザーとの対話を通じて、徐々に文脈を深く理解していきます。その結果、より的確で詳細な応答を提供できるようになります。
LLM×RAGに強い会社の選定・紹介を行います
今年度RAG相談急増中!紹介実績1,000件超え!
・ご相談からご紹介まで完全無料
・貴社に最適な会社に手間なく出会える
・AIのプロが貴社の代わりに数社選定
・お客様満足度96.8%超
完全無料・最短1日でご紹介 LLM×RAGに強い会社選定を依頼する
企業が導入する7つのメリット
RAGのメリットには、精度の高い回答を得られることや、最新の情報、オリジナルの情報を得られることなどが挙げられます。
リアルタイム、オリジナルな情報の反映
質問に応じてその都度外部データベースを検索するため、参照データや検索インデックスを更新することで、常に最新の情報を反映した回答を生成できます。また、自社独自の製品情報(製品に関するお問い合わせへの回答や操作サポートなど)に関する回答なども生成できます。
そのため、社内ヘルプデスク業務の大幅な効率化、自動化を期待できます。
関連記事:「RAGでヘルプデスクを効率化?対話型AIでは不十分な理由・導入メリット・活用事例を徹底解説!」
データ漏洩リスクの低減
LLMの学習データ、そしてユーザーの入力データに機密情報が含まれるとデータ漏洩のリスクが懸念されます。RAGは任意のデータベースから動的に情報を取得するため、学習データに依存せずに高精度な文章生成ができ、漏洩リスクを最小限に抑えられます。
関連記事:「生成AIの機密情報漏洩リスクはRAGで解決できる?メリットや強化策を徹底紹介!」
回答の精度の向上
検索ベースと生成ベースのAIモデルの長所を組み合わせることで、より正確で関連性の高い回答を提供します。この技術は、外部データベースからの情報を取得し、その情報を基に質問やプロンプトに対する回答を生成するため、正確な情報を反映した精度の高い回答を生み出すことが可能です。
特に、変化が激しい分野の情報を得る際に役立ち、ユーザーのニーズに合わせたカスタマイズされた回答を生成できる点が大きなメリットです。
GraphRAGでは、ナレッジグラフを活用して情報検索と生成を統合します。
関連記事:「GraphRAGとは?仕組みや従来のRAGとの違いを徹底解説」
コスト削減
RAGは少ない学習データでも高精度なタスク実行が可能なため、ファインチューニングや追加学習に必要なデータ収集・アノテーションのコストを大幅に削減できます。
柔軟なカスタマイズと拡張性
既存の知識ソースを検索対象にすることで、追加学習用データを大量に準備する負担を抑えられます。対象となるデータベースも柔軟に追加・変更できるため、企業ごとの要件に合わせたシステムを構築できます。
また、新たなデータソースを追加することで、システムの能力を継続的に向上できます。
応答速度の向上
検索フェーズで文脈を絞り込むことにより、生成フェーズで処理が必要なデータ量を減らすことができます。これにより、応答速度が向上し、ユーザー体験が改善されます。
特に、顧客サポートやバーチャルアシスタントなどのアプリケーションでは、迅速な回答提供が求められるため応答速度の向上は大きな利点となります。
また、最新の情報やデータソースへのアクセスが実現することで、回答が正確かどうかをチェックしやすくなり、結果的に信頼性の保証にもつながります。
文脈に合わせた回答生成
抽出された情報は、生成モデルによって統合され、ユーザーの質問やプロンプトの文脈に沿った回答が生成されます。この過程では、人間のような自然な言葉遣いや文脈を反映した説明が可能になり、より理解しやすい回答の提供が可能です。
RAGによる回答は、ただの情報の要約ではなく、質問の意図を把握し、適切な情報を組み合わせることで形成されます。
RAGを活用した社内チャットシステムの構築方法
既存のLLM、例えばChatGPTにも使われているGPTなどを基に社内チャットシステムを構築する方法は以下の通りです。
この過程では、LlamaIndexのようなRAG特化型のフレームワークを活用することで、効率的に開発を進めることができます。
関連記事:「RAGを導入するまでの8ステップ!プロジェクトの進め方や技術選定のポイントも徹底解説!」
1. LLMの選定
GPTやClaudeなど、RAGシステムのベースとなるLLMを選定します。モデルの言語生成能力や対応言語、ライセンス条件などを考慮し、自社のニーズに最も適したものを選びます。
2. 検索エンジンの開発
社内データを検索するための検索エンジンを開発します。この際、LLMとの連携を念頭に置き、検索結果をLLMに入力しやすい形式で出力できるようにします。また、Rerankモデルを導入することで、検索結果の関連性と精度を向上させることができます。
LlamaIndexは高度なインデックス作成機能を提供し、効率的なデータ検索を可能にします。さらに、Rerankモデルとの統合も容易です。
3. 参照データの準備
RAG構築における参照データの準備は、AIが情報を正確に理解し、検索精度を高めるための重要な土台となります。
まず、社内文書やウェブページなど元となるデータを収集します。次に、不要なHTMLタグや定型文を除去するデータクリーニングを行い、情報を整理します。
続いて、長い文書をAIが扱いやすいサイズに分割するチャンキングを実行します。
ベクトル検索を利用する場合は、分割した文書をEmbeddingモデルでベクトル化し、元の文章や文書名などの情報とともに検索インデックスへ登録します。
文書構造を考慮したチャンキング
チャンキングでは、文字数やトークン数で機械的に区切る方法に加え、見出し、段落、表などの構造を考慮し、意味のまとまりを保って分割する方法があります。
例えば、操作手順の途中や、表の項目名と数値の間で分割すると、検索された部分だけでは内容を正しく理解できない場合があります。見出しを各チャンクに付けたり、表とその説明を関連付けたりすることで、回答に必要な背景情報を保持しやすくなります。
適切な分割単位は資料の種類や質問の内容によって異なるため、検索結果に必要な説明や条件が含まれているかを確認しながら、チャンクの大きさや分割位置を調整します。
関連記事:「チャンキングとは?RAGにおける分割手法と精度への影響を解説」
参照:Microsoft|ドキュメントレイアウトを利用したコンテンツの分割
4. 検索エンジンとLLMの連携
検索エンジンとLLMを連携させる仕組みを開発します。ユーザーからの質問をLLMで解析し、関連するキーワードを抽出して検索エンジンに渡します。検索結果をLLMに入力し、文脈に即した自然な応答を生成します。
LlamaIndexを使用すると、検索エンジンとLLMの連携が非常にスムーズになります。LlamaIndexは、ユーザーからの質問をLLMで解析し、関連するキーワードを抽出して検索を行い、その結果をLLMに入力して文脈に即した自然な応答を生成するプロセスを一貫して管理します。
5. LLMのファインチューニング(オプション)
必要に応じて、社内データを用いてLLMのファインチューニングを行います。これにより、社内特有の用語や文脈をより高度にLLMに学習させ、さらに適切な応答の生成が期待できます。
ただし、ファインチューニングには大量の計算リソースと時間が必要となります。
6. ユーザーインターフェースの開発
ユーザーとのやり取りを行うためのインターフェース(チャットボット、Web UIなど)を開発します。ユーザーの入力をLLMに渡し、生成された応答を適切に表示できるようにします。
7. テストと評価
システム全体の動作をテストし、応答の質や応答時間などを評価します。ユーザーによる実際の利用を想定したテストを行い、システムの改善点を洗い出します。
関連記事:「RAGの精度評価方法とは?指標や改善のポイントを解説」
8. 運用とメンテナンス
システムの本番運用を開始したら、継続的なモニタリングとメンテナンスが必要です。ユーザーからのフィードバックを収集し、システムの改善につなげます。
また、LLMの更新や検索エンジンのインデックス更新など、定期的なメンテナンスも欠かせません。
既存のLLMを活用することで、自前でLLMを学習するよりも短期間かつ低コストでシステムの構築が可能になります。ただし、LLMの利用条件や、検索エンジンとの連携における技術的な課題にも注意が必要です。
また、既存のLLMはあくまで一般的な言語生成モデルであるため、社内の特定ドメインに特化した応答を生成するには限界があります。高度なカスタマイズが必要な場合は、独自のLLMを学習することも検討に値します。
RAGシステムの構築は、自然言語処理や機械学習の知見を持つエンジニアとの協力が不可欠です。自社の技術力を見極め、必要に応じて外部の専門家やベンダーとの連携を図ることが重要でしょう。
関連記事:「LLMOpsとは?導入メリット・最適ツール、活用のコツを徹底解説」
企業での導入時の課題と解決策
RAGは強力な技術である一方で、導入・活用にはいくつかの課題が存在します。以下に代表的な課題とその解決策を表形式で整理しました。
| 課題カテゴリ | 具体的な課題 | 解決策 |
|---|---|---|
| データの品質と更新 |
|
|
| 精度と信頼性 |
|
|
| セキュリティとプライバシー |
|
|
| 組織的な変化への受容 |
|
|
| ベンダー選定と依存度の管理 |
|
|
このように、各課題に対して具体的な解決策を講じることで、RAG導入の成功率を高め、業務への定着をスムーズに進めることが可能です。
運用で陥りやすいRAGの沼とは?

ここでは、「RAGの沼」と呼ばれることも多い運用で陥りやすい典型的な問題と、それを乗り越えるための理想的な運用体制について解説します。
データの陳腐化
データの陳腐化は、代表的な落とし穴の一つです。製品仕様の変更や社内規定の改定など、企業のデータは常に更新され続けているため、参照データベースが古いままではAIも古い回答しか生成できません。
また、各部門が資料を個別に管理している企業では情報がサイロ化しやすく、重複データや更新漏れ、バージョン不整合が精度低下の原因となります。
手動でのデータ更新は陳腐化を招きやすく、自動反映の仕組み(データパイプライン)を誰が担保するのかを、運用体制としてあらかじめ決めておく必要があります。
気づきにくい検索精度の劣化
検索精度の悪化も見過ごせない課題です。データの格納単位(チャンク)が不適切であったり、ユーザーが使う言葉(専門用語、略語、俗語)が変化・多様化したりすることで、時間の経過とともに検索精度は低下しがちです。
特に厄介なのは、明確な評価指標を設定していないために、こうした劣化に気づかないまま運用を続けてしまうケースです。精度改善が遅れるほどハルシネーションや誤情報の出力が増加し、RAGへの信頼損失につながります。
理想的な運用体制:マネジメント層・技術層・業務運用層の役割分担
RAGの精度と信頼性を維持するには、マネジメント層・技術層・業務運用層が連携する運用サイクルが理想的です。
| レイヤー | 主な役割・担当領域 | 具体的な業務内容・重要ポイント |
|---|---|---|
| マネジメント層 |
| KPIやROIの設定、予算管理、データ利用ガイドラインおよびセキュリティポリシーの策定 役職や部署に応じた閲覧権限(アクセス権限)の設計を行い、検索結果への機密・非公開文書の混入を防ぐ最重要の統制を担う |
| 技術層 | RAG基盤の設計・運用・継続的改善 | データ収集・正規化・インデックス更新の自動化、ベクトルデータベースの運用 データソースからの最新情報の検知と前処理(クリーニング、チャンキング)、検索アルゴリズムやプロンプトのチューニング、評価フレームワークを用いた精度改善 |
| 業務運用層 |
| 実際の利用者視点に基づくFAQや業務マニュアルの更新、誤回答の報告、ユーザーフィードバックの収集 日常業務へのRAG活用の組み込みと、組織全体への定着推進 |
評価体制の構築とPDCAサイクル
RAGを安定的に運用するためには、定量的な評価と改善サイクルの仕組み化が欠かせません。
「回答精度(正答率)XX%」「検索再実行率(ユーザーが質問し直す割合)X%以下」など、技術チームと事業サイドが合意できる定量的なKPIを設定し、自動評価ツールを用いて検索精度・生成精度を定期的にモニタリングすることが重要です。
あわせて、現場ユーザーからの「Bad」フィードバックが具体的に誰に通知され、何営業日以内に分析・改善(ナレッジ更新やプロンプト修正)されるのかを明確にし、分析結果の共有先と改善アクションの決定者を組織としてあらかじめ決めておくことが求められます。
LLM×RAGに強い会社の選定・紹介を行います
今年度RAG相談急増中!紹介実績1,000件超え!
・ご相談からご紹介まで完全無料
・貴社に最適な会社に手間なく出会える
・AIのプロが貴社の代わりに数社選定
・お客様満足度96.8%超
完全無料・最短1日でご紹介 LLM×RAGに強い会社選定を依頼する
RAGについてよくある質問まとめ
- RAGはどんな仕組みですか?
RAGは、以下の3つのステップで動作する情報検索と言語生成を組み合わせたAI技術です。
- ユーザーの質問を解析し、ベクトル表現に変換
- ベクトル表現を使って外部データベースから関連情報を検索・抽出
- 抽出した情報を言語モデルに入力し、文脈に即した自然な応答を生成
この一連のプロセスを反復することで、RAGはユーザーとのインタラクティブな対話を実現します。
- RAGを活用するメリットは?
RAGを活用するメリットは以下の通りです。
- 常に最新の情報を反映した正確な応答が可能
- 少ない学習データでも高精度な文章生成を実現
- 学習データに依存しないため、データ漏洩リスクを低減
- 企業ごとに最適なシステムを柔軟に構築・拡張可能
- カスタマーサポートの自動化、社内ナレッジの活用、マーケティングの高度化など、様々な業務シーンで活用可能
導入により、企業はデータドリブンな意思決定を加速し、業務効率の向上と競争力の強化を実現できます。
- AI Marketでは、生成AI(RAG)を活用した業務効率化の相談は可能ですか?
はい、可能です。例えば製造業様からは、熟練者のノウハウを学習させたチャットボットで技術継承を支援したいというご相談を、製薬企業様からは、RAG(検索拡張生成)を用いて講演資料の法規制チェックを自動化したいとのご相談をいただいています。
AI Marketでは、お客様の独自データを活用できるRAG技術に強いパートナーをご紹介し、属人化した業務の効率化をご支援します。
まとめ
RAGは、外部情報の検索とLLMを組み合わせ、社内外のデータに基づく回答を生成する技術です。社内検索や問い合わせ対応、意思決定支援など、幅広い業務で活用できます。
導入時には、回答精度だけでなく、検索対象データの品質、アクセス権限、セキュリティ、データガバナンスの強化、運用体制も整える必要があります。自社の課題と利用範囲を明確にし、PoCから段階的に適用範囲を広げることが重要です。
AI Market 運営、BizTech株式会社 代表取締役|2021年にサービス提供を開始したAI Marketのコンサルタントとしても、お客様に寄り添いながら、現場のお客様の課題ヒアリングや企業のご紹介を5年以上実施しています。これまでにLLM・RAGを始め、画像認識、データ分析等、1,000件を超える様々なAI導入相談に対応し、参加累計8,000人を超えるAIイベントを主催。AIシステム開発PM歴8年以上。AI Marketの記事では、AIに関する情報をわかりやすくお伝えしています。(JDLA GENERAL 資格保有)
▶ 監修者の実績・経歴を詳しく見る
AI Market 公式𝕏:@AIMarket_jp
Youtubeチャンネル:@aimarket_channel
TikTok:@aimarket_jp
運営会社:BizTech株式会社
掲載記事に関するご意見・ご相談はこちら:ai-market-contents@biz-t.jp
お電話で無料相談

