

画像認識とは?AIで行う仕組み・種類・活用方法を相談事例付きでわかりやすく解説
最終更新日:2026年09月23日
記事監修者:森下 佳宏|BizTech株式会社 代表取締役
AIを活用した画像認識は、製造業における品質管理の自動化、小売業の在庫最適化、セキュリティ強化など、幅広いビジネス領域で導入が進んでいます。
しかし、「導入コストが高そう」「自社に本当に必要なのか」「どれくらいの精度が出るの?」といった懸念をお持ちの経営者も多いのではないでしょうか。
さらに近年は、Vision Foundation ModelやVLM、GPT・Geminiなどのマルチモーダル基盤モデルの発展により、画像の意味や状況を理解し、自然言語で説明・検索・推論する技術へと広がっています。
この記事では、AIで画像認識を行う方法、AIモデルの種類、活用されている分野、注意点、導入方法をわかりやすく解説します。
精度に関するよくある誤解や最新技術動向、AI Marketが開発企業を紹介した事例も取り上げます。導入を検討している方や、精度向上に課題を抱えている方は、ぜひ参考にしてください。
画像認識・画像解析に強いAI開発会社をご自分で選びたい場合はこちらで特集していますので併せてご覧ください。
目次
画像認識とは?
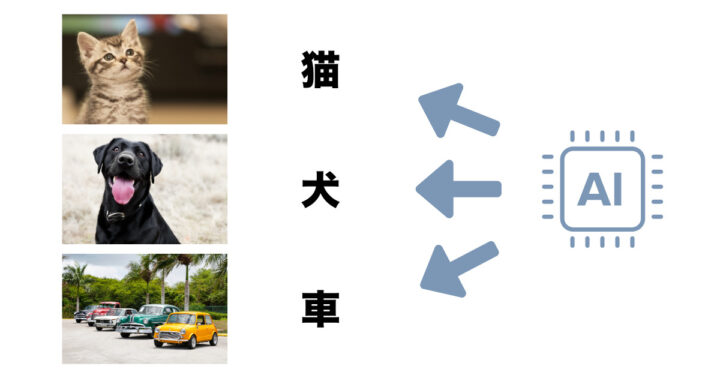
「画像認識」とは、形や色などの特徴を用いて、コンピュータが2次元(2D)または3次元(3D)画像に写るものが何であるかを認識する技術です。人間が「犬」「猫」「車」などの物体を識別する際に、特徴を学習し判断するプロセスを参考に、コンピュータが同様の認識能力を獲得することを目指しています。
AI、特に機械学習やディープラーニングを利用すると、手作業で判定ルールを設定する従来手法に比べて、複雑な特徴を学習できるようになります。こうした技術は、広義にはコンピュータビジョンの一分野です。
尚、動画解析においても、基本的には画像認識の技術がベースとなっています。
関連記事:「AI動画認識・解析とは?画像認識との違い・相談事例/活用事例・仕組み・メリットデメリットを完全解説!」
画像認識でできること
画像認識でできることは、大きく以下の3つに分けられます。
- 何が写っているかを判定する
- どこに・どのような状態で写っているかを特定する
- 画像の内容を言語化して活用する
代表的なものとして、画像をカテゴリに振り分ける分類、対象物の位置を特定する物体検出、ピクセル単位で領域を切り分けるセグメンテーションなどがあります。
さらに近年はVLMの普及により、画像の内容を文章で説明したり、写真をもとに質問へ回答したり、見た目の近い画像を検索したりする使い方も可能になっています。
画像認識と画像解析・画像処理の違い
画像認識と混同されやすい言葉に「画像処理」と「画像解析」があります。3つは役割が異なり、実際のシステムでは組み合わせて使われます。
| 用語 | 役割 | 例 |
|---|---|---|
| 画像処理 | 画像そのものを加工・補正し、見やすく扱いやすい状態に整えます |
|
| 画像認識 | 画像に写る対象が「何か」「どこにあるか」を判定します |
|
| 画像解析 | 認識結果などから数値や傾向を導き、業務の判断に使える情報にします |
|
例えば外観検査では、以下のような流れになります。
- 撮影画像の明るさを揃える(画像処理)
- 傷を検出する(画像認識)
- 傷の大きさや発生傾向を集計する(画像解析)
なお「画像解析」は画像認識とほぼ同じ意味で使われることも多く、その範囲は文脈によって異なります。
AIが画像を認識する仕組み
AIによる画像認識は、大きく次の流れで行われます。
- 画像取得:カメラやスマートフォン、ドローン、スキャナなどで対象を撮影します
- 前処理:サイズや明るさを揃え、ノイズや歪みを補正して、AIが判定しやすい状態に整えます
- 特徴抽出:輪郭(エッジ)や色、形状、質感などの特徴を数値(特徴量)として取り出します
- 分類・検出:抽出した特徴を学習済みのパターンと照らし合わせ、「何が」「どこに」写っているかを判定します
- 出力・活用:判定結果を合否判定やアラート、データとして業務システムに渡します
従来の手法では、特徴抽出のルールを人が設計していました。ディープラーニングでは、大量の画像から判定に役立つ特徴をAI自身が学習するため、人が言葉で定義しにくい微妙な違いも捉えられるようになりました。
どの工程をどのモデルで担うかは、目的によって異なります。代表的なモデルの特徴は以下のとおりです。
| モデル・手法 | 仕組みの特徴 | 得意なこと | 向いている用途 |
|---|---|---|---|
| CNN(ResNetなど) | 畳み込み処理によって、局所的な特徴を段階的に抽出 | 画像分類、特徴抽出 | 外観検査、画像分類全般 |
| YOLO・SSD(物体検出モデル) | 画像全体を1回の処理で見て、物体の位置と種類を同時に予測 | 高速な物体検出 | リアルタイム監視、個数カウント |
| Vision Transformer(ViT) | 画像を小さなパッチに分割し、自己注意機構で画像全体の関係性を学習 | 大規模データでの高精度な分類、複雑なシーンの理解 | 背景が複雑な画像の認識、基盤モデルの土台 |
| SAMなどのセグメンテーションモデル | 点や枠などの指示をもとに、対象の輪郭をピクセル単位で切り出し | 汎用的な領域抽出 | アノテーションの効率化、医療・インフラ画像の解析 |
| Vision Foundation Model(DINOv2など) | ラベルのない大量の画像で自己教師あり学習を行い、汎用的な特徴表現を獲得 | 少量データでの転用、類似画像検索 | データを集めにくい新規用途、画像検索 |
| VLM・マルチモーダル基盤モデル(CLIP、GPT、Geminiなど) | 画像と言語を組み合わせて扱う | 画像の説明、質問応答、追加学習なしでの分類 | 帳票・図面の読み取り、現場写真の要約 |
実務では、速度と安定性が求められる検査工程にはCNNやYOLO、柔軟な理解が求められる業務にはVLMといったように、複数のモデルを組み合わせて使うケースも少なくありません。
画像認識の歴史と技術の進化
画像認識は近年急速に普及した技術ですが、光学的に情報を読み取る研究は1940年代にまで遡るとされます。主な流れは以下のとおりです。
| 年代 | 主な出来事・技術 | 概要 |
|---|---|---|
| 1940〜50年代 | バーコード・光学的な読み取り技術 | バーとスペースの組み合わせを光学装置で読み取る仕組みが考案された |
| 1960〜70年代 | パターン認識・3次元物体認識の研究 |
|
| 1980〜90年代 | PCの普及、テンプレートマッチング・ルールベース手法の実用化 |
|
| 2000年代 | 特徴量と機械学習の組み合わせ、画像検索の普及 |
|
| 2012年〜 | ディープラーニング(CNN)の躍進 |
|
| 2020年〜 | Vision Transformer・自己教師あり学習・画像と言語の統合 |
|
| 2023年〜 | 視覚基盤モデル・マルチモーダル基盤モデルの普及 |
|
初期は、テンプレートマッチングや、人が色・形などの特徴に基づいて判定ルールを設定する手法が用いられていました。しかし、固定されたルールだけで複雑なシーンや多様な対象に対応することには限界がありました。
その後、機械学習や統計的手法が取り入れられ、さらにディープラーニングによって、画像から判定に必要な特徴を自動的に学習できるようになりました。
特に、畳み込みニューラルネットワーク(CNN)を活用した手法は、2012年頃からImageNetなどのコンテストで高い性能を示し、画像分類や物体検出などの実用化を後押ししました。
近年は、自己教師あり学習などを用いて大量の画像から汎用的な特徴を獲得するVision Foundation Model(視覚基盤モデル)の活用が進んでいます。
関連記事:「画像認識アルゴリズムとは?各種類の特徴・選定ポイントを徹底解説!」
GPTやGeminiなどのマルチモーダル基盤モデルによる画像理解
近年は、分類・物体検出・セグメンテーションといった認識技術に加え、画像と自然言語を組み合わせて扱うVLM(Vision-Language Model)や、GPT・Geminiなどのマルチモーダルな基盤モデルの活用が広がっています。
画像に対応したGPTやGeminiなどでは、何が写っているかを判定するだけでなく、以下も可能になります。
| 機能・できること | 概要 | 具体的な活用例 |
|---|---|---|
| 自然言語での説明 | 画像の意味や状況をテキストとして言語化し、結びつけて理解する | 店舗画像から状況を説明させる |
| 質問への回答 | 提示された画像に対する具体的な問いに対して適切な答えを返す | 製造現場の写真に対して「異常と思われる箇所を説明して」と質問する |
| 複雑な推論・読み取り | 複数の視覚情報を踏まえて推論し、内容を抽出・要約する | 図面や帳票の内容を読み取って要点を整理する |
ただし、製造業の外観検査や高速な物体検出など、特定の対象を高い安定性や低遅延で判定する用途では、CNNを用いた専用モデルやYOLOなどの物体検出モデルが適している場合もあります。
そのため、導入時には、専用モデルの精度・速度と、マルチモーダル基盤モデルの柔軟な画像理解能力を比較し、用途に応じて使い分けることが重要です。
関連記事:「VLMとは?仕組み・LLMとの違い・メリット・デメリット・活用分野を徹底解説」
関連記事:「マルチモーダルAIとは?代表モデル・活用メリット・ビジネス活用事例や相談事例を徹底解説!」
画像認識に強いAI会社の選定・紹介を行います
今年度AI相談急増中!紹介実績1,000件超え!
・ご相談からご紹介まで完全無料
・貴社に最適な会社に手間なく出会える
・AIのプロが貴社の代わりに数社選定
・お客様満足度96.8%超
・物体検出、異常検知、類似画像検索等
完全無料・最短1日でご紹介 画像認識に強いAI会社選定を依頼する
AIによる画像認識の種類は?
AI画像認識の種類には、以下のようなものがあります。
- 分類
- 物体検出
- セグメンテーション(領域検出)
- 異常検知
- 姿勢推定・動作認識
- キャプション生成・視覚的質問応答
- 顔認証
- 文字認識(OCR)
- 検索
- 変化検出
それぞれの特徴について、詳しく解説します。
分類
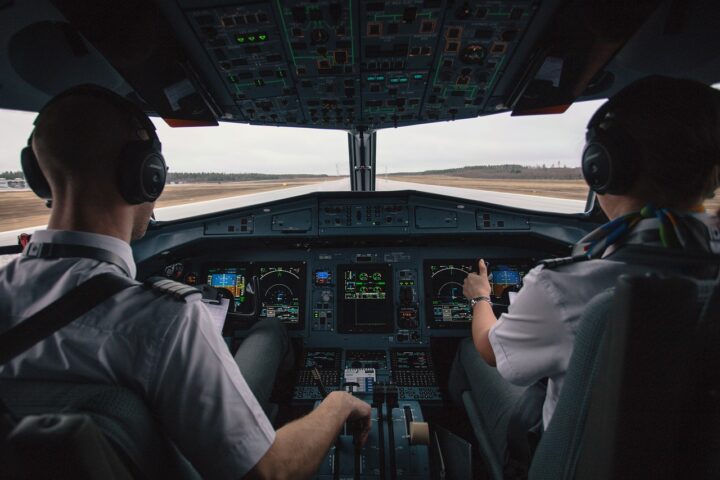
分類は、画像に写るものをカテゴリ(ラベル)として判定する技術です。また、全体の特徴からシーンを分類する用途にも活用されます。
例えば、ある画像に「多くの計器」「左右に座る制服姿の男女」「空の背景」などが写っているとします。これらの要素の組み合わせから、一般的に飛行機の操縦室であると推定できます。
このように、分類・シーン理解は画像全体の意味を掴む入口として、多くのAIの土台になります。製造工程の状態判定や医療画像の一次スクリーニング、クマ・シカなどの害獣検知といった場面で活用されています。
関連記事:「AIによる画像分類とは?画像全体を理解する画像認識の特徴・活用方法・導入手順・注意点を徹底解説!」
物体検出
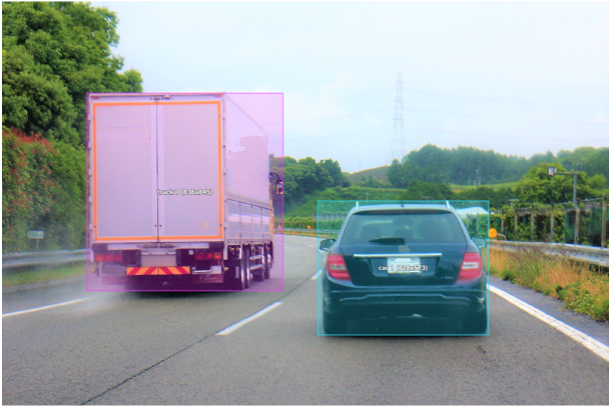
物体検出は、「何があるか」だけでなく「どこにあるか」まで特定する技術です。主に、物体の位置を矩形(バウンディングボックス)で表します。
近年、この技術は画像検査AIによる個数カウントでも大きく進展しています。単なる検出にとどまらず、追跡(トラッキング)まで含めて数える・追う・異常を拾う運用が一般化しました。
製造業の部品カウントや小売の棚監視、自動運転での車両・歩行者の検出、建設現場の安全管理など、位置の特定が必要な業務で幅広く活用されています。
またセキュリティカメラ映像では、人物検出→追跡→異常行動検出や人数カウント(人流解析)に活用されます。店舗のAIカメラでは、棚の商品やレジ通過品など個々の物体識別にも応用されます。
現場ではYOLOのような高速なアルゴリズムが重宝される一方、より複雑なシーンでは、画像全体の関係性を捉えるVision Transformer(ViT)系の採用も増えています。
関連記事:「AIの物体検出とは?相談事例、YOLO・CNN・VITなど画像認識の仕組み・手法を徹底解説!」
セグメンテーション(領域検出)
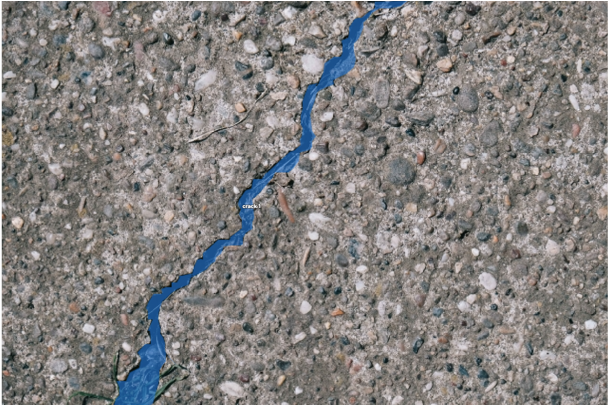
セグメンテーションは、画像中の各ピクセルが「どの物体/背景に属するか」を分類する技術です。物体検出よりも境界が正確に取れるため、形状・面積・輪郭が重要な業務で効果を発揮します。
例えば、道路や壁面のひび割れの位置・形状の抽出、医療画像で病変部位の正確な範囲推定などに使われます。自動運転でも、道路/歩道/車線などを分離し、運転環境をより正確に理解するために用いられます。
セグメンテーションには主に以下の種類があります。
- セマンティックセグメンテーション:同種の物体を同じグループとして識別(例:車は全部「車」)
- インスタンスセグメンテーション:同種の物体でも個体ごとに分離(例:車A/車B)
関連記事:「セマンティックセグメンテーションとは?ピクセル単位で理解する画像認識AIの仕組み・インスタンス手法との違い・実用例徹底解説」
異常検知
画像認識の中でも多く活用が進んでいるのが異常検知です。これは「正常のパターン」を学習し、そこからの逸脱を検出する考え方で欠陥検出に強いアプローチです。
さらに、色検査も重要な応用分野として注目されています。
製造ラインの外観検査では、従来目視で判定していた傷・汚れ・欠けなどを、高精度に判別します。
また2D画像だけでなく、Lidarや3Dカメラを用いて、立体形状の異常(歪み・欠け・凹み)まで検査するケースも増えています。医療分野ではCT/MRIから異常組織の検出などにも活用されます。
関連記事:「異常検知とは?相談事例、メリットや学習方法、手法、ディープラーニング活用を完全解説!」
関連記事:「AIによる外観検査の仕組みは?導入相談事例・目視検査との比較・メリット」
姿勢推定・動作認識
姿勢推定は、主に人物画像から骨格・関節の位置(キーポイント)を特定し、人物がどのような姿勢・動きをしているかを推定する技術です。
代表的なライブラリとして以下があります。
- OpenPose:定番ライブラリで、関節を「点」で結ぶ
- Meta SAM 3D Body:人体全体を3Dメッシュとして復元し、ひねりや隠れ部位の推論が強い
プロスポーツ選手のフォーム解析、工場スタッフの動線・作業姿勢の改善など人の動きを数値化したい領域で強力です。
関連記事:「姿勢推定AIとは?AI Marketで実際に扱った相談事例・体の動きを理解する画像認識の仕組み・アルゴリズムを徹底解説!」
キャプション生成・視覚的質問応答
キャプション生成は、画像を説明する文章を自動生成する技術です。画像に写る物体だけでなく、状態・行動・関係性まで文章化できます。
また、画像に関する質問に答えるVisual Question Answering(VQA)も同系統で、画像×言語の相互理解を深めます。
視覚障害者支援アプリでは、写真を撮るだけで内容を音声で説明できます。SNSやECでは、自動生成キャプションを検索・整理に活用できます。
この領域では、VLM(Vision-Language Model)が中核技術として急速に普及しています。
顔認証
顔認証は、顔の特徴を数値化し、個人を特定・照合する技術です。セキュリティゲートやスマートフォンのロック解除など、本人確認のUXを大きく変えました。
オフィスや工場の入退室管理、スマートフォンや決済での本人認証、空港の搭乗手続きなどでも活用されています。
関連記事:「顔認証システムとは?画像認識で本人確認する仕組み・導入手順・注意点・ディープフェイク対策を徹底解説!」
文字認識(AI-OCR)
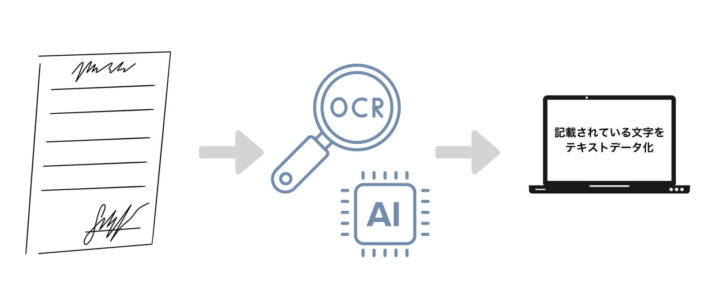
文字認識は、印刷文字や手書き文字を識別し、画像内の文字をテキストに変換する技術です。従来OCRにAIが加わり、AI-OCRとして精度が大きく改善しました。
AI-OCRは、データ入力自動化、郵便物仕分け、チェック(マーク)読み取り、図面読み取りなどで活躍します。
近年は生成AI連携により、読み取った文字列を「日付」「金額」などの項目として理解・整形する運用が現実的になっています。
関連記事:「AI-OCRとは?従来型OCRとの違いや生成AIとの使い分け、メリット、製品10選を比較」
検索
画像検索(Image Retrieval)は、大量のデータベースから類似画像を検索・取得する技術です。テキスト検索だけでは説明しづらい「見た目が近い」を直接探せる点が強みです。
一般的には、画像から色・形状・テクスチャなどの特徴を抽出し、CNNやTransformerで高次元ベクトルに変換します。ベクトル検索により類似度を計算し、関連性の高い画像をランキング表示します。
ECの類似商品検索や、製造業での類似不良・過去事例の参照、医療での類似症例検索などに活用されています。
関連記事:「ベクトル検索とは?仕組み・LLMでの役割・実装方法・活用事例を徹底解説!」
関連記事:「類似画像検索とは?導入相談事例・AI導入の効果・利用シーン・注意点を徹底解説!」
変化検出
画像変化検出は、同一の場所や対象を異なる時点で撮影した画像を比較し、変化を検出する技術です。単発画像の理解ではなく、時間変化という文脈まで扱うのが特徴です。
例えば、建設現場の定点カメラでは、建物形状の変化や資材移動などを検出し、進捗管理・安全管理の精度を上げられます。橋梁・道路の経年劣化の監視、災害時の浸水・土砂崩れの把握、農作物の生育差の検知などにも活用されています。
関連記事:「AIでの画像変化検出とは?相談事例、時間変化をとらえる画像認識の仕組み・シーン・導入方法・注意点を徹底解説!」
画像認識に強いAI会社の選定・紹介を行います
今年度AI相談急増中!紹介実績1,000件超え!
・ご相談からご紹介まで完全無料
・貴社に最適な会社に手間なく出会える
・AIのプロが貴社の代わりに数社選定
・お客様満足度96.8%超
・物体検出、異常検知、類似画像検索等
完全無料・最短1日でご紹介 画像認識に強いAI会社選定を依頼する
業界別活用方法は?
製造、小売、物流、医療など、業界ごとの代表的な用途を紹介します。より詳しい事例は、業界別の活用事例をご覧ください。
| 業界 | 主な活用方法 | 主に使われる技術 |
|---|---|---|
| 製造業 |
|
|
| 自動車・交通 |
|
|
| Eコマース・小売 |
|
|
| 流通・物流 |
|
|
| セキュリティ |
|
|
| 建設・インフラ・公共事業 |
|
|
| 環境保護 |
|
|
| スポーツ |
|
|
| 文化財保護・芸術 |
|
|
| 教育 |
|
|
| 農業 |
|
|
| 医療・介護 |
|
|
| エンターテインメント・メディア |
|
|
AI Marketに寄せられた画像認識の活用相談事例
AI Marketには、画像や映像を用いた業務効率化・品質向上について、多くの企業からご相談が寄せられています。
お客様から寄せられたご相談は以下のようなもので、AI Marketでは、コンサルタントがお客様の課題感をヒアリングし、適した技術・ソリューションを保有する企業をご紹介致しました。
- 図面・仕様書から自動見積積算を行うAIシステムの構築
- 食品工場の入場前作業(コロコロ・毛髪除去)の行動遵守チェックAI
- 配電盤のネジ締め・コネクタ接続不良のスマホ画像検知アプリ
- 液体残量の変化を測定するスマートフォン解析アプリ
- 製品本体画像・型番シールからSKUを特定する画像検索・OCRシステム
※実際のお客様からのご相談内容のため、企業特定に繋がる情報は伏せています。
① 図面・仕様書から自動見積積算を行うAIシステムの構築
ご相談企業様属性
- エリア:関東
- 従業員数:1,001人〜
要件・技術整理内容
電気通信設備の見積積算業務において、仕様書・数量表・図面・特記事項など複数のドキュメントをもとに手作業で積算を行っており、見積作成に時間がかかる点が課題となっていました。特に既存の積算パッケージでは対応できない独自記号や線情報、図面の読み取りが必要なケースが多く、自動化が進んでいない状況です。
そのため、PDF図面やCAD図面、仕様書などの非構造データを統合的に解析し、機器構成や数量を抽出した上で見積を自動生成する仕組みを希望されていました。また、3Dスキャンデータから図面を生成し、その情報を積算に連携するフローも将来的に検討されています。
カスタマイズ前提で図面意味理解まで含めた長期的な開発を視野に入れた相談となっていました。
② 食品工場の入場前作業(コロコロ・毛髪除去)の行動遵守チェックAI
ご相談企業様属性
- エリア:関東
- 従業員数:1,001人〜
要件・技術整理内容
食品工場の入場時に実施するコロコロクリーナーや毛髪除去などの衛生工程について、作業が確実に実施されているかをAIカメラで確認したいという相談です。現在は監視カメラ映像を人が確認しており、確認作業に工数がかかる点や見逃しが発生する点が課題となっていました。
求められているのは、特定の作業を行っていない人物の検知や、作業時間の不足、工程逸脱などを自動で検出する仕組みです。リアルタイム解析だけでなく、録画映像の後解析にも対応し、将来的には複数工程に横展開できる行動定義の登録機能も希望されています。
また、防護服やマスク着用状態での人物識別、複数人同時入場時の動作判定など、実環境に合わせた行動認識精度が求められていました。
③ 配電盤のネジ締め・コネクタ接続不良のスマホ画像検知アプリ
ご相談企業様属性
- エリア:関東
- 従業員数:1,001人〜
要件・技術整理内容
受配電キャビネット内部のネジ締め不良やコネクタ接続不良を検知するため、スマートフォンで撮影しながら点検を支援するアプリの検討相談です。配電盤内には数百点の確認箇所があり、目視点検では見落としが発生する可能性があるため、品質向上のための補助ツールとしての導入を希望されています。
固定カメラではなく作業者がスマートフォンを持って撮影し、画面上で即時判定される仕組みを想定しています。スプリングワッシャーの潰れ具合やネジの緩み、配線の抜けなど微細な状態を画像から判定し、異常箇所を提示する機能が求められています。
また図面や3Dモデル情報と連携し、点検対象箇所の抜け漏れを防止する仕組みも将来的な要望として挙げられていました。
④ 液体残量の変化を画像から測定するスマートフォン解析アプリ
ご相談企業様属性
- エリア:関東
- 従業員数:1,001人〜
要件・技術整理内容
ビニール袋状や筒状容器に入った液体の残量を、スマートフォンで定期撮影した画像から測定し、残量ゼロまでの時間を算出するアプリの開発相談です。容器は減少に伴い形状が変化するため、単純な液面検出ではなく、形状変化量から体積を推定する必要があります。
袋型容器では変形量の解析、筒状容器ではメモリ位置やピストン位置の認識など、容器タイプごとの計測ロジックが必要とされています。複数容器を同時管理し、残量低下時のアラート通知や将来的なシステム連携も視野に入れた要件です。
また正面・側面の複数画像やマーカー付与など、精度向上のための撮影条件も検討されています。
⑤ 製品本体画像・型番シールからSKUを特定する画像検索・OCRシステム
ご相談企業様属性
- エリア:関東
- 従業員数:101〜500人
要件・技術整理内容
多数の製品SKUの中から、スマートフォンで撮影した本体画像や型番シール画像をもとに該当品番を特定し、部品検索システムに連携する仕組みを検討されていました。色違いやサイズ違いなど外観差異が小さい製品が多く、誤案内を避けるため高精度な特定が必要とされています。
本体画像からの類似検索だけでなく、底面シールの文字情報を読み取りSKUを特定する方法も並行して検討されています。コンシューマ向けWebサービスへのAPI連携を前提とし、撮影ガイドUIや画像トリミングなどユーザー操作を簡略化する設計も求められています。
過去製品を含む数千SKU規模での検索精度と、部品検索サイトへの自動連携が要件として挙げられていました。
AI Marketでは、上記のように、様々な企業・教育機関からのAI活用相談を受け付けています。
生成AIツールを用いて、AI企業の選定をAIに相談するケースも増えています。しかし、実際のAI導入では、機密情報の取り扱い、実装可能性の判断、企業選定など、人が介在しないと判断が難しい要素も多く存在すると考えています。
だからこそAI Marketでは、実際の人間である専門のAIコンサルタントが直接お客様と対話し、ヒアリングから企業選定までを支援し、実現性の高いAI導入をサポートしています。
貴社でもAI活用をご検討中の際は、ぜひご相談ください。
画像認識に強いAI会社の選定・紹介を行います
今年度AI相談急増中!紹介実績1,000件超え!
・ご相談からご紹介まで完全無料
・貴社に最適な会社に手間なく出会える
・AIのプロが貴社の代わりに数社選定
・お客様満足度96.8%超
・物体検出、異常検知、類似画像検索等
完全無料・最短1日でご紹介 画像認識に強いAI会社選定を依頼する
メリットは?
画像認識AIは、単なる技術トレンドではありません。貴社のビジネスを根幹から変えて、新たな成長軌道に乗せる可能性を秘めた戦略的ツールです。
主なメリットとして、以下の点が挙げられます。
- 業務効率化とコスト削減
- 品質向上と顧客満足度の改善
- 新サービス創出と競争優位の獲得
これらのメリットをさらに詳しく掘り下げていきます。
業務効率化とコスト削減
多くの企業にとって、画像認識AI導入の最も直接的で分かりやすいメリットは、業務プロセスにおける圧倒的な効率化と、それに伴うコスト削減効果でしょう。
人間が行ってきた「目で見て判断する」作業は集中力や体力を要し、時間的制約も伴います。画像認識AIは、これらの定型的な視覚タスクを継続的かつ高速に処理でき、特定の条件やタスクでは人間と同等以上の精度を実現できる場合があります。
これにより、以下のような効果が期待できます。
- 人件費の削減
- 生産性の向上
- ヒューマンエラーや見落としの低減
- 人材の最適配置
例えば、検査工程の時間が半減すれば、生産ライン全体のスピードアップに繋がります。また、不良品の流出や手戻り作業に伴う損失(時間・コスト)を大幅に削減します。
さらに、ルーティンワークから解放された従業員を、企画、開発、顧客対応といった、より高度な判断や創造性が求められるコア業務へと再配置することが可能になります。
関連記事:「画像認識AIの導入・運用費用内訳を徹底解説!ROIの考え方と向上させる方法は?」
品質向上と顧客満足度の改善
画像認識AIは、コスト削減や効率化といった守りの側面だけでなく、企業の生命線ともいえる品質の向上においても絶大な効果を発揮します。そして、その品質向上は、顧客満足度(CS)の向上という形で明確なビジネス成果へと直結します。
例えば、製造業では人間の目では検出が困難なμm(マイクロメートル)単位の微細なキズや異物混入、色むらなどをAIが高精度で検知します。これにより、不良品率が低下し、製品品質の安定化・均質化が実現します。
結果として、クレーム削減、ブランドイメージ向上、顧客からの信頼獲得に繋がります。
新サービス創出と競争優位の獲得
画像認識AIの導入効果は、既存業務の改善だけに留まりません。むしろ、これまでにない新しいサービスやビジネスモデルを創出し、競合他社に対する明確な優位性を確立する戦略において発揮されます。
既存製品にAIを組み込むことで、その機能性や利便性を飛躍的に高め、競合製品との差別化を図ります。
例えば、店舗内のカメラ映像から顧客の動線、滞在時間、手に取った商品などを分析し、これまで把握できなかった顧客インサイトから、全く新しい商品開発やサービス事業の着想を得ることも可能です。
これらの取り組みは、単なる業務効率化とは異なり、企業の新たな収益源を生み出し、市場における独自のポジション(競争優位性)を築くための強力な武器となります。
画像認識に強いAI会社の選定・紹介を行います
今年度AI相談急増中!紹介実績1,000件超え!
・ご相談からご紹介まで完全無料
・貴社に最適な会社に手間なく出会える
・AIのプロが貴社の代わりに数社選定
・お客様満足度96.8%超
・物体検出、異常検知、類似画像検索等
完全無料・最短1日でご紹介 画像認識に強いAI会社選定を依頼する
企業がAI画像認識を導入する流れ
画像認識AIの導入方法は、既存のクラウドサービスやマルチモーダル基盤モデルを利用する場合と、自社データで専用モデルを構築する場合で異なります。
専用モデルを開発する場合は、目的設定、データ整備、モデル選定・構築、PoC、実装、継続改善という流れが一般的です。
以下では、専用のモデルを開発する際のそれぞれのステップについて説明します。
関連記事:「AI開発の手順は?AIシステム構築の流れを徹底解説!失敗しない為の注意点もわかる完全ガイド」
1.導入目的・必要な精度を明確にする
画像認識AIの導入は、「何のために、どの程度の精度で判定できればよいか」を明確にすることから始まります。
目的と求める精度によって、必要なデータ量や選ぶべきモデル、開発費用が大きく変わるためです。
精度の目標は、単に「正解率〇%」とするのではなく、見逃し(偽陰性)と過検出(偽陽性)をそれぞれどこまで許容できるかで考えるのが実務的です。
例えば、外観検査では不良品の見逃しは品質事故につながる一方、過検出が多すぎると再検査の工数が増えてしまいます。
自動運転や医療画像診断など人命に関わる用途では極めて高い精度が求められます。
一方、社内書類の文字認識のように人の確認を前提とする用途では、一定の精度でコストを抑えるという判断もあり得ます。
あわせて、リアルタイムでの判定が必要か、判定結果を誰がどう使うのか、誤判定が起きたときにどう対応するのかも整理しておくと、後工程のデータ準備やモデル選定がスムーズになります。
導入目的によって必要な精度は変動するため、この段階で具体的な目標値を決め、後のPoCでの評価基準として使えるようにしておくことが重要です。
関連記事:「画像認識AIの精度向上ガイド!指標種類・低下の原因・改善方法・上げるコツを徹底解説」
2.必要な画像データを収集・準備する
目的と精度目標が決まったら、用途や採用するモデルに応じて必要な画像データを準備します。データの収集方法は主に以下の2つに分かれます。
- 公開データセットの利用:ImageNetやCOCOなどの既存データセットを事前学習や検証に活用
- 独自データの収集:実際の現場で自社製品や特定の対象物を撮影
独自モデルをゼロから学習する場合は大量の画像が必要ですが、現在は事前学習済みモデルの転移学習やファインチューニング、Vision Foundation Model、Few-shot Learningなどを活用することで比較的少ないデータから開発を始められるケースが増えています。
重要なのは単純な画像枚数ではなく、照明・角度・背景・季節変動など、実際の利用環境を十分に反映したデータを用意できるかどうかです。
また、学習用の画像には正解ラベルを付けるアノテーション作業が必要です。
集めた画像データには、モデルの学習効率と精度を高めるための前処理(リサイズ、正規化、データ拡張など)を行います。
関連記事:「AI学習用のデータ収集代行会社プロ厳選おすすめ」
3.用途に合ったAIモデル・ソリューションを選定する
データの準備と並行して、用途や求める精度・処理速度、社内の開発体制に応じてモデルと導入方式を選定します。主な導入方式は以下のとおりです。
| ソリューション | 手法 | メリット | ポイント |
|---|---|---|---|
| クラウドの画像認識API | Google Cloud Vision、Amazon Rekognition、Azure AI Visionなどの学習済みAPIを利用 |
|
|
| マルチモーダル基盤モデル | GPT、Gemini、ClaudeなどのAPIに画像と指示文(プロンプト)を入力 |
|
|
| オープンソース | PyTorch、OpenCV、YOLOシリーズ、公開されている学習済みモデルなどを活用 |
|
|
| カスタム開発 | 自社または専門の開発会社とともに、専用のモデル・システムを構築 |
|
|
実務では、まずマルチモーダル基盤モデルやクラウドAPIで実現性を確かめ、精度や速度が不足する部分を専用モデルで補うという段階的な進め方も一般的になっています。
専用モデルを開発する場合、開発言語にはPythonが広く用いられます。OpenCVなどで画像を処理し、PyTorchやTensorFlowでモデルの構築・学習・評価を行うのが一般的です。
関連記事:「PythonがAI開発で使われるのはなぜ?理由・メリット・デメリット・活用例を徹底解説!」
4.PoCで精度・実現性を検証する
モデルや導入方式の候補が決まったら、本格導入の前に小規模なPoC(Proof of Concept:概念実証)を行います。
PoCは、AIが自社の課題を実際に解決できるかを、限られた範囲で検証する段階です。
例えば、以下のような形で実施します。
- 工場ラインの一工程だけで不良検知AIを試す
- 店舗の一部商品カテゴリで欠品検知を試行する
検証では、学習に使っていないテスト用データや現場で新たに撮影した画像を用いて、設定した目標(見逃し率・過検出率・処理速度など)を満たしているかを評価します。あわせて、撮影環境の制約や現場の作業フローとの相性、運用時の費用対効果も確認します。
結果が目標に届かない場合は、データの追加や撮影条件の見直し、モデルの変更などを検討します。PoCの段階で課題を洗い出すことで、無駄な投資を抑えつつ本格導入の成功率を高められます。
また、PoCを始める前に「どの結果が出たら本番導入に進むか」という判断基準を関係者で合意しておくと、検証だけが長引く「PoC止まり」を防ぎやすくなります。
関連記事:「AI開発のPoCとは?目的・進め方から『PoC止まり』を防ぐポイントまで解説」
5.本番導入・運用後の改善を行う
PoCで有効性を確認できたら、本番環境へ導入します。カメラや照明などの撮影環境を整え、既存の生産管理システムや業務システムと連携させたうえで段階的に適用範囲を広げていくのが一般的です。
導入後も、以下のような観点で継続的に評価・改善を行います。
- 精度の定期評価
- 誤判定の分析:見逃しや過検出が起きた画像を収集し、原因を特定
- 再学習・ファインチューニング:新たなデータを加えてモデルを更新し、環境の変化に対応
- 運用ルールの見直し
現場では、製品仕様の変更や設備の入れ替え、季節による照明の変化などにより、導入時の精度が徐々に低下することがあります。
こうした変化を前提に、データの蓄積→評価→再学習というサイクルを運用に組み込む(MLOps)ことで長期的に安定した精度を維持できます。
関連記事:「MLOpsとは?導入すべき理由・手順・特徴からDevOpsやLLMOpsとの違いを分かりやすく解説!」
AI画像認識を活用する際の注意点
AI画像認識を活用する際の注意点は以下です。
誤認識を前提に運用方法を設計する
画像認識AIの精度をどれだけ高めても、誤認識を完全になくすことはできません。そのため、AIの判定を最終判断とせず、誤りが起きても業務が止まらない運用を設計することが重要です。
例えば、判定の確信度が低い画像だけを人が確認する、見逃しが許されない工程では過検出寄りに閾値を設定するといった工夫が有効です。
また、社内で、AI導入に関して以下のような極端な見解や誤解が広まらないよう、正しい認識を共有しておくことが重要です。
| よくある誤解 | 正しい見解 |
|---|---|
| AIは常に100%正確である、または逆に人間よりも常に劣っている |
|
| 精度は単一の数値で表すことができる |
|
| GPTやGeminiなどの生成AIを使えば、学習なしで高い精度が出る |
|
実際の利用環境で継続的に精度を確認する
PoCで高い精度が出ても、本番環境では照明や天候、カメラの汚れ、製品仕様の変更などによって精度が低下することがあります。
導入後も実際の運用データで精度を定期的に確認し、低下の兆候を早期に捉えることが重要です。誤判定の事例を蓄積し、再学習に活用できる体制をあらかじめ整えておくとよいでしょう。
法令・ガバナンスへの対応を確認する
画像認識は、対象によっては個人情報・生体情報・監視に該当し、技術より先に運用ルールが必要になります。
日本(個人情報保護法/APPI)では、顔などの身体的特徴をデータ化したものは「個人識別符号」に該当し得ます。つまり「映っている」だけでなく、照合可能な形で扱う時点で管理水準が上がると考えるのが安全です。
EU AI Actでは、用途によっては「禁止」または「高リスク」に分類され、透明性・リスク管理・記録・人の監督などが強く求められます。特に生体認証や公共空間の監視は要注意領域です。
企業としては、法令対応を“現場で回る形”にするために、最低限次を決めておくと導入がスムーズです。
- 目的:何のために撮り、何を判定し、誰が使うか
- 保管:保存期間、アクセス権、匿名化/マスキング
- 監督:誤判定時の人手レビュー手順
- ログ:いつ、何を、どう判定したか(監査可能性)
さらに、AIガバナンスを社内制度として整えるなら ISO/IEC 42001(AIマネジメントシステム) を参照すると、属人的な運用から抜けやすくなります。
関連記事:「AIを活用した画像認識の得意・不得意分野・企業導入での課題と対応策は?」
最新の画像認識AI動向
認識精度と適用範囲を大きく広げる可能性を秘めている技術を紹介します。
ロボティクスとの融合
視覚情報を取得・分析する技術は、ロボティクスの分野でも欠かせない要素です。主に以下の用途で活用されています。
- 物体認識を用いたロボットマニピュレーション
- 環境理解に基づくロボットナビゲーション
- 人とロボットのインタラクションにおける視覚情報の活用
特に、Metaのスマートグラス「Aria Gen 2」などを活用し、人間が見ている世界や手の動きを一人称視点でデータ化することで、ロボットが人間の行動を模倣したり、意図を汲み取ったりする研究が加速しています。
関連記事:「ロボット×AI?世界モデル連携での活用分野・相談事例/導入事例・コスト・課題を徹底解説!」
Few-shot Learningで少量データから学習
Few-shot Learning は、少量のデータから効果的に学習するための手法です。従来の機械学習では大量のデータを必要としましたが、Few-shot Learning ではメタ学習の考え方を取り入れ、わずかな例から新しいクラスを認識できるようにします。
この手法を用いることで、データが少ない場合でも高精度な画像認識が可能になります。
関連記事:「Few Shot Learning入門:ファインチューニングとの違いは?どんな分野で使う?失敗しない注意点を解説」
Zero-shot Learningで未知の物体も認識
Zero-shot Learning は、学習時に一度も見たことがないクラスを認識する手法です。属性情報や言語情報を利用して、未知のクラスに対する認識能力を獲得します。
例えば、「黄色くて長い」という属性情報から「バナナ」を認識するような場合に用いられます。Zero-shot Learning により、画像認識の適用範囲が大きく広がることが期待されます。
Zero-shot Learningの仕組み、活用事例をこちらの記事で詳しく説明していますので併せてご覧ください。
自己教師あり学習(Self-supervised Learning)の進化
自己教師あり学習(SSL:Self-supervised Learning)は、教師なし学習の1つで特徴表現を学習する手法です。画像の一部を隠して復元させたり、画像の変換に対して不変な特徴を学習させたりすることで、ラベルのない大量の画像データから汎用的な特徴表現を獲得します。
事前学習モデルを用いることで、少量のデータでも高精度な画像認識が可能になります。
関連記事:「自己教師あり学習とは?教師なし学習・教師あり学習との違い・仕組み・LLMにおける活用方法を初心者向けに解説!」
3D情報や複数のセンサーを組み合わせた画像認識
画像認識では、通常の画像に加えて、深度や立体形状などの情報を組み合わせ、2D画像だけでは捉えにくい特徴を判定に利用する方法も活用されています。
例えば、外観検査では画像の色や模様と深度情報を組み合わせ、傷や汚れだけでなく、凹みや変形などの検出に役立てます。
姿勢推定でも、画像から人体の立体的な姿勢を推定し、作業動作やスポーツのフォーム分析に利用する技術が研究・開発されています。
画像認識と社内データ・RAGの連携
画像認識の結果を、社内のマニュアルや製品情報、過去の対応事例などと組み合わせ、業務に必要な回答や説明を生成する仕組みへの応用も進んでいます。
例えば、製品画像から類似する部品を検索し、部品データベースの仕様情報と合わせて候補を提示したり、現場写真から読み取った情報をもとに関連マニュアルを検索し、確認手順を案内したりする使い方があります。
こうした仕組みでは、画像検索やVLMによる画像理解に、関連情報を検索して回答に利用するRAG(検索拡張生成)を組み合わせます。
関連記事:「RAG(検索拡張生成)とは?導入相談事例・LLMとの連携シーン・メリット・システム構築の注意点を徹底解説!」
エッジデバイスでの展開
モデルの軽量化や処理の最適化により、スマートフォンや工場内の端末などで画像認識を実行する方法が活用されています。
例えば、製造ラインの画像を現場の端末で解析することで、クラウドへの送信に伴う遅延や通信量を抑えられます。画像を外部に送信しない構成も可能です。
関連記事:「エッジAIとは?メリット・クラウドとの使い分け・相談事例や活用事例を徹底解説」
画像認識についてよくある質問まとめ
- AI画像認識はどのような業務に向いていますか?
AI画像認識は、製品の外観検査、人物や車両の検出、在庫確認、異常検知、文字認識、画像検索、作業行動の分析など、目視確認や画像・映像の判定が発生する業務に向いています。
特に、判断基準をある程度定義でき、一定量の画像や映像を継続的に取得できる業務では導入効果を期待しやすくなります。
- 画像認識AIの精度はどのくらい出ますか?
画像認識AIの精度は、対象物、撮影環境、画像データの質、モデル、判定基準などによって大きく異なります。
そのため、一律に「何%の精度が出る」とは言えません。実際の導入では、精度だけでなく、誤検知と見逃しのどちらを重視するか、処理速度やコストまで含めて評価することが重要です。
- 画像認識AIの導入には大量の画像データが必要ですか?
必ずしも大量の画像データが必要とは限りません。独自モデルをゼロから学習する場合は一定量のデータが必要ですが、現在は事前学習済みモデル、転移学習、Vision Foundation Model、Few-shot Learningなどを活用し、比較的少ないデータから開発を始められるケースもあります。重要なのは枚数だけでなく、実際の利用環境を反映した質の高いデータを用意することです。
- VLMやVision Foundation Modelを使えば従来の画像認識モデルは不要になりますか?
従来の画像認識モデルが不要になるわけではありません。VLMやVision Foundation Modelは、画像の意味理解や自然言語による検索・説明などに強みがあります。一方、製造業の外観検査やリアルタイム物体検出など、特定対象を高速かつ安定して判定する用途では、CNNやYOLOなどの専用モデルが適している場合があります。用途に応じた使い分けが重要です。
- 画像認識AIを導入する場合、既存サービスとカスタム開発のどちらを選ぶべきですか?
一般的な物体認識やOCRなどであれば、クラウド型の画像認識APIや既存サービスを利用することで短期間・低コストで導入できる場合があります。
一方、自社固有の製品や微細な欠陥、特殊な撮影環境などに対応する場合は、カスタム開発が必要になることがあります。必要な精度、導入期間、コスト、カスタマイズ性を比較して選定することが重要です。
導入する際は専門会社へ
画像認識AIは、製品検査や在庫管理、セキュリティなど、幅広い業務の自動化・高度化に活用できます。
比較的短期間で試せるサービスも増えています。一方で、必要な精度や撮影環境、データ整備、法令・プライバシーへの対応は用途ごとに異なります。
自社だけで要件や技術方式を判断することが難しい場合は、画像・映像解析に詳しい専門会社へ相談するとよいでしょう。
AI Market 運営、BizTech株式会社 代表取締役|2021年にサービス提供を開始したAI Marketのコンサルタントとしても、お客様に寄り添いながら、現場のお客様の課題ヒアリングや企業のご紹介を5年以上実施しています。これまでにLLM・RAGを始め、画像認識、データ分析等、1,000件を超える様々なAI導入相談に対応し、参加累計8,000人を超えるAIイベントを主催。AIシステム開発PM歴8年以上。AI Marketの記事では、AIに関する情報をわかりやすくお伝えしています。(JDLA GENERAL 資格保有)
▶ 監修者の実績・経歴を詳しく見る
AI Market 公式𝕏:@AIMarket_jp
Youtubeチャンネル:@aimarket_channel
TikTok:@aimarket_jp
運営会社:BizTech株式会社
掲載記事に関するご意見・ご相談はこちら:ai-market-contents@biz-t.jp
お電話で無料相談

