

VLMとは?仕組み・LLMとの違い・メリット・デメリット・活用分野を徹底解説
最終更新日:2026年08月21日
記事監修者:森下 佳宏|BizTech株式会社 代表取締役
VLM(Vision-Language Model)は、画像などの視覚情報と言語情報を統合的に処理できるマルチモーダルAIモデルです。画像の内容理解、視覚質問応答、文書解析、画像検索などに活用されており、製造、小売、医療、カスタマーサポートなど幅広い分野で利用が進んでいます。
本記事では、VLMの仕組みなどの基本情報から、ビジネスにおける具体的な活用方法やメリット・デメリットまでを網羅的に紹介します。生成AI(人工知能)の活用を検討している企業担当者の方は、ぜひ最後までご覧ください。
また、LLMとは何か?基本的な仕組みとその重要性についてはこちらで詳しく解説していますので併せてご覧ください。
LLM導入・カスタマイズに強いAI開発会社を自力で選びたい方はこちらで特集していますので併せてご覧ください。
目次
VLMとは?
VLMとは、画像などの視覚情報と文章などの言語情報を統合的に処理するマルチモーダルAIモデルです。
マルチモーダルとは、画像・テキスト・動画など複数の異なる形式のデータ(モダリティ)を扱い、統合的に処理するAI技術のことです。
VLMでは、主に以下の技術を組み合わせて視覚情報と言語情報を関連付けます。
- 視覚情報処理:画像内の物体や文字、構図、状況などの特徴を抽出・理解する
- 言語処理:質問や指示などのテキストを理解し、画像の内容を踏まえて文章として回答する
このような技術を有するVLMは、デジタル広告、医療画像解析、eコマース、自動運転など、様々な分野で応用されています。
VLMとLLMとの違い
VLMは、画像などの視覚情報と言語情報を関連付けて処理できる点が特徴です。
一方、LLMはもともとテキスト処理を中心に発展してきた大規模言語モデルですが、現在では画像入力にも対応するマルチモーダルLLMが増えています。
そのため現在は、「LLMはテキストのみ、VLMは画像とテキスト」という単純な区分ではなく、VLMは視覚と言語の統合処理に重点を置いたモデル群として理解するのが適切です。
| LLM、VLM、VLA | 特徴 | 出力形式 |
|---|---|---|
| LLM(大規模言語モデル) | 言語処理を中心に発展したモデル 文章生成、要約、翻訳、推論などが得意で、画像入力に対応するモデルも増えている | 主にテキスト情報 |
| VLM(Vision-Language Model) | LLMの能力を拡張し、テキストに加えて画像情報も扱える 画像の内容を説明したり、画像に関する質問に答えたりできます | テキスト情報 |
| VLA(Vision-Language-Actionモデル) | VLMの「認識」能力をさらに一歩進め、物理的な「行動」に結びつけます | 現実世界で具体的なアクションを直接生成 |
また、これらのモデルを包括する概念としてMLLM(マルチモーダル大規模言語モデル)があります。MLLMは、テキストや画像だけでなく、音声や動画など複数の情報(モダリティ)を統合的に処理できるため、より複雑なタスクに対応可能です。
企業がどのモデルを採用するかは、テキスト分析だけで十分なのか、画像認識が必要か、あるいは物理的な作業の自動化まで目指すのかといった目的によって選択することが重要です。
加えて、SLM(小規模言語モデル)は、軽量で特定タスクに最適化されたモデルとして、効率性と実用性を重視する用途に適している点が特徴です。エッジLLMも、現場で迅速な応答が求められるシーンにおいて、その特性が活かされると期待されています。
関連記事:「LLM・SLM・VLM・MLLM・LVM・LMMなどの用語、意味が分かる!」
代表的なVLM
代表的なVLM・視覚言語対応モデルとして、以下が挙げられます。
- OpenAIの視覚入力対応モデル
- Geminiシリーズ(Google)
- Claudeの視覚入力対応モデル(Anthropic)
- LLaVA
- Qwen-VLシリーズ
- InternVLシリーズ
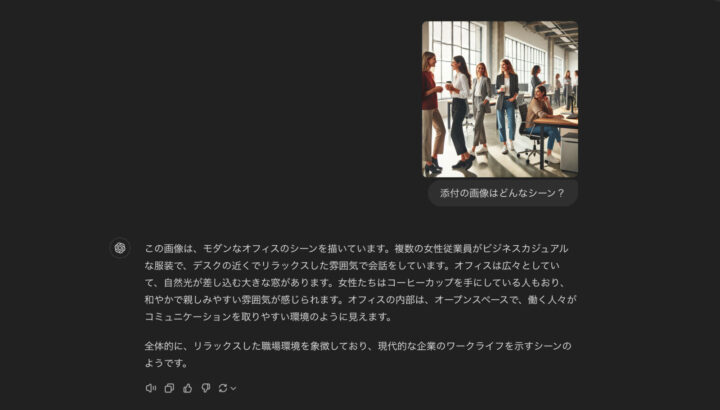
例えば、VLMでは以下のように画像を入力することで、画像内の情報を認識(理解)し、言語情報として回答を行ってくれます。以下の画像では、オフィスの様子であること、女性従業員が会話をしているなど、画像内の重要な要素を抽出してくれています。
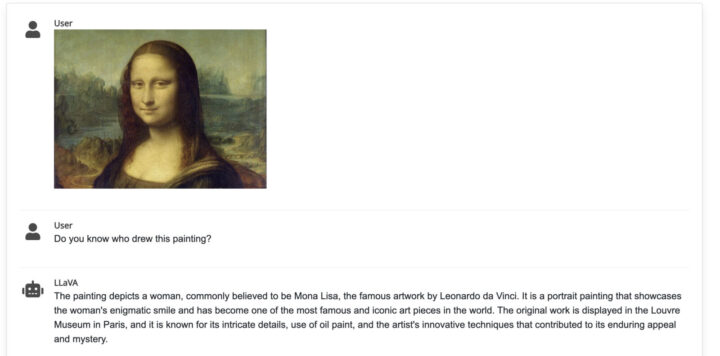
例えばLLaVAでは、以下のようにモナリザの画像を元に「誰がこの絵を描いた?」という質問に対して、何が描かれているか、という観点だけではなく、この絵画自体を理解して「モナリザとして知られるこの絵画はレオナルド・ダ・ヴィンチによって描かれた」ということまで説明を行ってくれています。
なお、画像生成機能を備えたマルチモーダルAIサービスもありますが、画像の理解・推論を行うVLMと、画像を生成するモデルは役割が異なります。
このように、VLMは視覚と言語を融合し、より直感的かつ柔軟な方法で情報を扱うことが可能です。
VLMの仕組み
VLMは、画像とテキストのデータを同時に処理できるように設計されており、以下が重要な構成要素です。
- 事前学習:大量の画像とテキストなどを用いて、視覚情報と言語情報の関係を学習します。
- Vision Encoder:入力画像を複数の特徴表現へ変換します。現在ではVision Transformer(ViT)などTransformer系のアーキテクチャが広く利用されています。
- 言語モデル:ユーザーから入力された質問や指示を理解し、言語として処理します。
- マルチモーダル融合:Vision Encoderが抽出した画像特徴と言語情報を接続・統合し、両者の関係をモデル内で処理します。
- 出力生成:統合された情報をもとに、画像の説明や質問への回答、情報抽出など、タスクに応じたテキストを生成します。
現在のVLMでは、Transformerを中心としたアーキテクチャが広く利用されています。
画像処理にはVision Transformer(ViT)などのVision Encoderが使われ、抽出された画像特徴をLLMが扱える形式へ変換・接続することで、画像と言語を統合的に処理します。
なお、CNNも画像認識で重要な技術ですが、現在の主要なVLMではTransformer系の画像エンコーダが広く利用されています。
画像とそれに対応するテキストで学習することにより、画像の内容からテキストの生成や分析が可能なモデルを構築しています。
LLMに強い会社・サービスの選定・紹介を行います
今年度LLM相談急増中!紹介実績1,000件超え!
・ご相談からご紹介まで完全無料
・貴社に最適な会社に手間なく出会える
・AIのプロが貴社の代わりに数社選定
・お客様満足度96.8%超
・GPT、Claude、Gemini、Llama等の複数モデルに対応
完全無料・最短1日でご紹介 LLMに強いAI会社選定を依頼する
VLMでできること
VLMが対応できることは、以下のとおりです。
| VLMでできること | 機能の詳細 |
|---|---|
| 画像内容の理解・情報抽出 | 画像内の物体、人物、文字、状況などを認識し、必要な情報をテキストとして抽出 |
| 画像からサンプルコードを生成 | Webデザインの図や手書きスケッチから自動的にサンプルコードを生成 |
| 画像の内容を説明 | ユーザーの質問から画像内のオブジェクトや状況を正確に説明 |
| 画像の文章を要約・翻訳 | 専門的な技術書などの画像に含まれるテキストの多言語翻訳や要約を行う |
| 手書きの文字や図を読み取る | はがきの文字やマニュアルからデータを読み取り、デジタル化に役立てる |
| 視覚質問応答(VQA) | 画像に関する質問に答える機能 |
| 画像検索 | テキストクエリに基づいて関連する画像を検索する機能 |
VLMの活用分野
VLMのマルチモーダルな能力は、さまざまなシーンで活用され始めています。以下では、主な活用分野について紹介します。
- 自動運転:自動運転車のセンサーやカメラから取得した映像データを分析し、周囲の交通状況をリアルタイムで把握
- 医療:医師が行う診断に対して補助的な役割を果たすことで、早期発見や誤診のリスク低減に貢献
- 広告・マーケティング:広告クリエイティブの画像内容を分析し、商品、構図、テキストなどの情報をもとに分類・評価や制作支援に活用
- カスタマーサポート:画像に関する質問にも対応でき、カスタマーサポートの対応サービスの拡大
- 商品検索:購入者が正確なアイテム名や詳細な商品情報を入力しなくても、自然言語でテキストクエリを入力するだけで商品を簡単に見つけられます。
VLMの5つのメリット
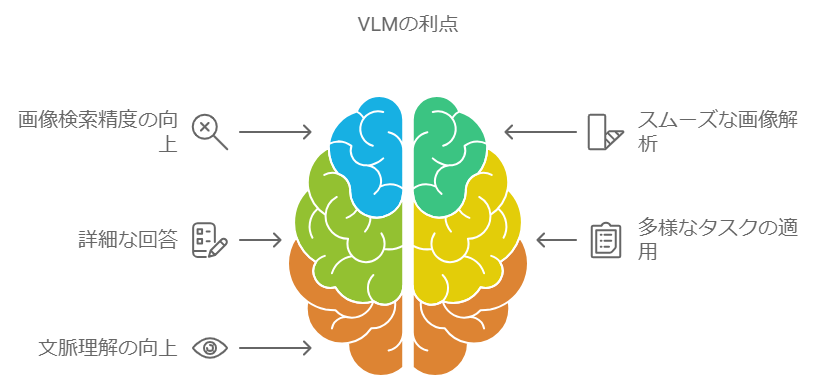
VLMには、従来のLLMや認識系AIモデルにはないメリットがいくつかあります。VLMのメリットについて、従来のLLMや認識系AIモデルと比較しながら解説します。
画像検索精度が向上する
VLMを活用すれば、テキストと画像を組み合わせて画像を検索ができるため、検索精度が大幅に向上します。
例えば、従来のキーワード検索では、ユーザーが「カジュアルな白いドレス」と入力した場合に、「白い」「ドレス」や「カジュアル」など個別キーワードに基づく結果が返される傾向がありました。結果として、白いウェディングドレスや黒いカジュアルな服が表示されるなど、ユーザーが求める意図が反映されないことも多くありました。
また、画像認識AIを用いた検索では、画像の特徴を抽出し、類似画像を検索します。そのため、テキストによる詳細な要求を理解できない限界がありました。
一方、VLMでは、「カジュアルな白いドレス」というテキスト情報と、ユーザーの好みを示す参考画像を同時に処理できます。
そのため、テキストの意味とビジュアル情報を組み合わせた検索が可能になり、ユーザーの意図により近い商品や画像を提示しやすくなります。
このようにVLMを活用することで、テキストと画像の両方を検索条件として利用でき、単一のモダリティだけを利用する検索では捉えにくかったユーザーの意図を反映しやすくなります。
画像解析がスムーズになる
従来の画像認識AIモデルでは、監視カメラなどから得られる映像に対して「画像内のどこに注目すべきか」が曖昧なため、不審者検出や異常検知が難しいケースも少なくありませんでした。
一方、VLMを用いることで、例えば「青い服の人物を追跡」といったように、テキストで画像のどの部分に注目すべきかを具体的に指示できるようになります。
VLMを活用することで、自然言語による指示をもとに画像や映像の内容を分析できるため、従来の画像認識モデルだけでは設定が難しかった柔軟な視覚タスクに対応しやすくなります。
ただし、高速かつ高精度な物体検出など特定のタスクでは、専用の画像認識モデルの方が適している場合もあります。
より詳細な回答ができる
近年、LLMを使用したFAQシステムやチャットボットが急速に普及しつつあります。オープンソースLLMを活用した事例も増加しており、これにより開発コミュニティが協力してより高品質なシステムの構築が期待されます。また、ローカルLLMを利用することで、企業内部でのデータ管理やセキュリティ対策が一層強化される可能性があります。
しかし、テキストのみでやり取りするため、製品の使い方など視覚情報が必要な場合には曖昧な回答しか得られないことも多く、活用シーンが限られる点が課題です。
一方、VLMを導入することで、ユーザーは質問をテキストと画像の両方で入力できるため、視覚情報を必要とする質問にも対応しやすくなります。
VLMは、従来のLLMと比べ、FAQシステムの活用領域を広げられるツールとして注目されています。
汎用タスクに適用可能
VLMはさまざまな視覚・言語タスクに適用できます。従来の画像認識AIは、物体検出や顔認識など特定の視覚タスクに特化したモデルが中心でした。また、テキストのみを扱う従来型LLMは言語関連のタスクを中心としていました。
一方、VLMは画像と言語に関連する幅広いタスクに対応可能です。例えば、同じVLMモデルを使って画像キャプション生成、視覚質問応答、画像検索などの異なるタスクを実行できます。
コンテキスト理解の向上
VLMは画像と言語の文脈を統合的に理解します。従来の画像認識AIは主に画像の視覚的特徴を処理し、テキストのみを扱う従来型LLMは言語情報を中心に処理していました。
VLMでは、画像の視覚情報と言語情報を関連付けて処理できるため、画像の内容について自然言語で質問したり、複数の情報を組み合わせて推論したりできます。
これにより、より深い意味理解や推論が可能になります。例えば、画像内の物体間の関係性や、画像とテキストの間の微妙なニュアンスを捉えることができます。
LLMに強い会社・サービスの選定・紹介を行います
今年度LLM相談急増中!紹介実績1,000件超え!
・ご相談からご紹介まで完全無料
・貴社に最適な会社に手間なく出会える
・AIのプロが貴社の代わりに数社選定
・お客様満足度96.8%超
・GPT、Claude、Gemini、Llama等の複数モデルに対応
完全無料・最短1日でご紹介 LLMに強いAI会社選定を依頼する
VLMのデメリット
VLMは有力なAI技術ですが、導入の際には開発コストや計算リソースなどいくつか課題も伴います。以下では、VLMのデメリットについて紹介します。
独自学習や追加学習ではデータ整備にコストがかかる
既存の事前学習済みVLMをAPIなどで利用する場合、必ずしも自社で大量の学習データやアノテーションデータを用意する必要はありません。
一方、自社業務に特化したモデルを追加学習したり、独自のVLMを構築したりする場合には、画像とテキストの組み合わせなど、用途に適した学習・評価データを整備する必要があります。
特に専門性の高い画像や、正確な回答が求められる業務では、高品質なデータの作成や確認に一定のコストがかかる点に注意が必要です。
アノテーション作業を外注できる会社をこちらで特集していますので併せてご覧ください。
計算コストが高い
VLMは、テキストだけでなく画像などの視覚情報も処理するため、テキストのみを扱うモデルと比べて計算負荷が大きくなる場合があります。
必要な計算リソースは、モデルの規模、入力画像の解像度や枚数、処理頻度、利用するインフラなどによって大きく異なります。
そのため、VLMを動作させるには、高性能な計算インフラが必要になる分、ハードウェアやクラウドの利用コストも増加する点がデメリットです。特に、IoTデバイスなど計算能力の限られた環境での展開が困難です。
大規模なデータセットを用いたトレーニングやリアルタイム処理を求められるビジネス用途では、ハイエンドモデルのGPUが必要になり、導入コストが高くなる傾向にあります。
そのため、VLMを導入する際には、サービスの規模や用途に応じたコスト計画が重要です。
ハルシネーションのリスク
VLM(Vision-Language Model)におけるハルシネーション(幻覚)の問題は、AIの信頼性と安全性に関わる重要な課題です。例えば、画像に存在しない物体や人物について、あたかも存在するかのように説明したり、実際にはない詳細や背景情報を創作して提供することもあります。
主な原因は、特定のドメインや状況に偏ったデータセットで学習したことや、視覚情報よりも言語モデルの出力に依存しすぎる傾向です。
ハルシネーション問題に対処するための主な対策と課題は以下の通りです。
- より多様で偏りの少ないデータセットの構築
- 高品質なアノテーションデータの整備
- ハルシネーションを適切に検出・評価する指標の確立
- 重要な判断における人間の専門家による確認プロセスの導入
ハルシネーション問題は、VLMの実用化と社会実装において克服すべき重要な課題です。技術的な改善とともに、適切な運用ガイドラインの整備や社会的な理解の促進が求められています。
関連記事:「「AIがなぜ幻覚を生むのか?」また「それは人間にどのように影響するのか?」」
VLMについてよくある質問まとめ
- VLMとは何ですか?
VLM(Vision-Language Model)とは、画像などの視覚情報と言語情報を関連付けて処理できるマルチモーダルAIモデルです。
画像の内容説明、視覚質問応答、文書解析、画像検索など、視覚と言語を組み合わせた幅広いタスクに利用できます。
- VLMとLLMの違いは何ですか?
LLMは言語処理を中心に発展してきたモデルで、VLMは画像などの視覚情報と言語情報を統合して処理する点が特徴です。
ただし、現在は画像入力に対応するマルチモーダルLLMも増えており、LLMとVLMの境界は以前より曖昧になっています。
まとめ
VLMは、視覚情報(画像や映像)と言語情報を統合的に処理するマルチモーダルAI技術です。画像内容の理解、視覚質問応答、文書解析、画像検索など幅広い視覚・言語タスクに対応でき、製造、小売、医療、カスタマーサポートなどさまざまな分野で活用が進んでいます。
今回の機会にVLMを導入し、ビジネスの成長を加速させましょう。
AI Market 運営、BizTech株式会社 代表取締役|2021年にサービス提供を開始したAI Marketのコンサルタントとしても、お客様に寄り添いながら、現場のお客様の課題ヒアリングや企業のご紹介を5年以上実施しています。これまでにLLM・RAGを始め、画像認識、データ分析等、1,000件を超える様々なAI導入相談に対応し、参加累計8,000人を超えるAIイベントを主催。AIシステム開発PM歴8年以上。AI Marketの記事では、AIに関する情報をわかりやすくお伝えしています。(JDLA GENERAL 資格保有)
▶ 監修者の実績・経歴を詳しく見る
AI Market 公式𝕏:@AIMarket_jp
Youtubeチャンネル:@aimarket_channel
TikTok:@aimarket_jp
運営会社:BizTech株式会社
掲載記事に関するご意見・ご相談はこちら:ai-market-contents@biz-t.jp
お電話で無料相談

